anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。
GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

Motion-Omni framework

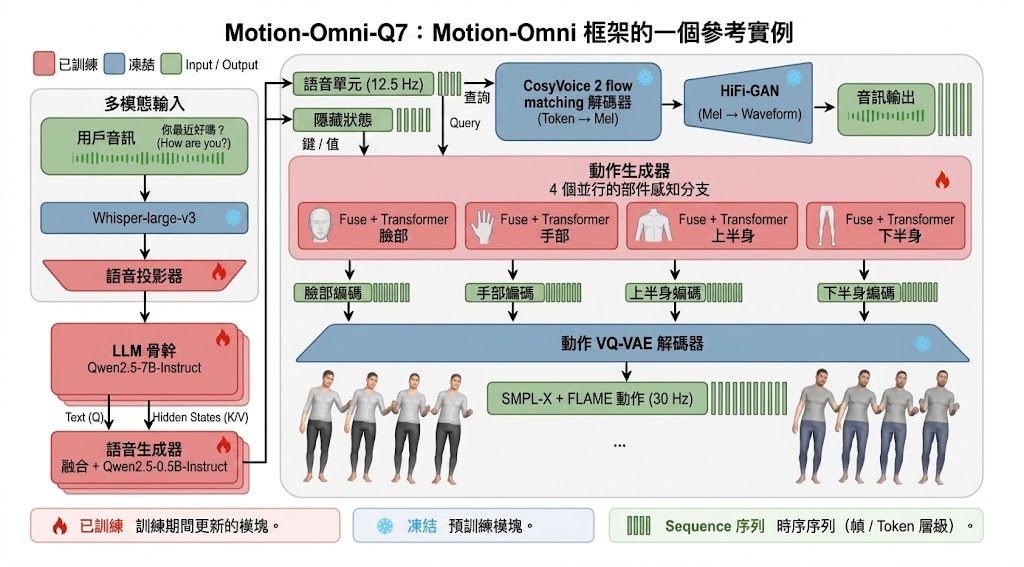
試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

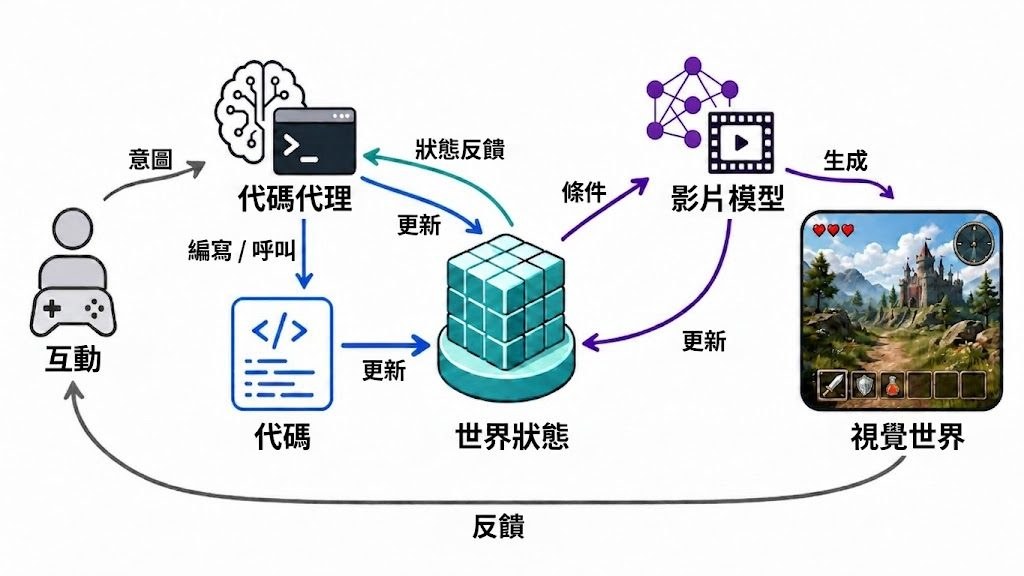
Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

Wan-Animate-2 把角色動畫推向即時互動

同一張角色圖,已經可以跟住驅動影片做出更穩定動作,連鏡頭角度都可另外控制。Wan-Animate-2想解決的,不只是畫面靚唔靚,仲包括直播同數字人能否即時用。

Og image

一張角色圖片配合一段驅動影片,便可以生成動作自然、表情細緻的角色動畫,這正是 Wan-Animate-2 想處理的核心場景。它屬於角色動畫生成框架,重點不只放在畫質,還試圖解決身份容易走樣、動作細節流失,以及難以支援即時互動這幾個長期卡位。

跟不少依賴中間動作表示的方法不同,Wan-Animate-2 直接把 driving video 餵入重新設計的 Diffusion Transformer,避開 motion extractor 帶來的誤差與 identity drift。這種端到端做法的好處,是角色外觀保持得更穩,細微表情、複雜肢體動作,甚至角色與場景之間較合理的互動,都更容易保留下來。

它另一個值得留意的能力,是加入 text-driven viewpoint control,令輸出鏡頭角度可以跟驅動影片分開控制。對數字人、直播主持、虛擬角色演出這類互動工作流來說,這代表同一段驅動內容不一定要綁死原本視角,使用時更容易配合不同畫面需求。

  • 直接使用 driving video,而不是先抽取中間動作表示
  • 主打更穩定的 identity preservation 與 motion fidelity
  • 支援 text-driven viewpoint control,可分離鏡頭視角與驅動動作
  • 推出 Wan-Animate-2-Lite,目標是把推理延遲壓到即時門檻
  • 預告公開 Wan-Animate-2-Base 權重,方便社群延伸研究

為了走向即時應用,團隊亦提出 Wan-Animate-2-Lite,並用三階段訓練流程去降低 inference latency,包括 teacher forcing pretraining、error buffer mechanism,以及 Self-Forcing distillation 配合 chunk-wise backpropagation。現有結果與使用者研究顯示,它在多種角色和動作模式下都有不錯的高保真表現;不過目前公開資訊仍以研究展示為主,部署成本、硬件需求與長時間串流穩定性,仍要等更多公開細節驗證。

項目主頁

Categories: 阿里巴巴, 視覺模型, Video, Image, 動畫

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

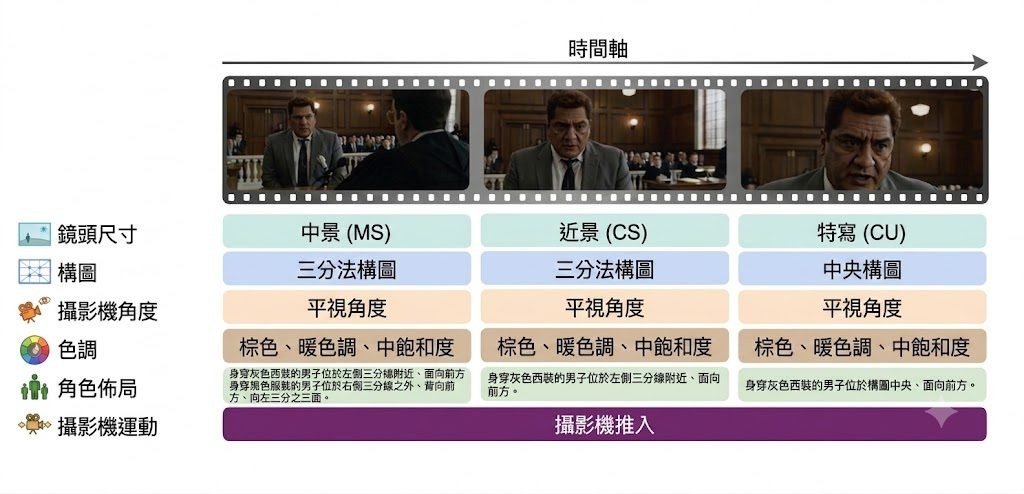
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

ARDY 讓 3D 角色動作可即時受控

想像你一邊改文字指令,一邊即時見到角色順住路徑、姿勢同目標動起來。ARDY把可控性同即時回應拉到同一個工作流入面。

Og image

一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。

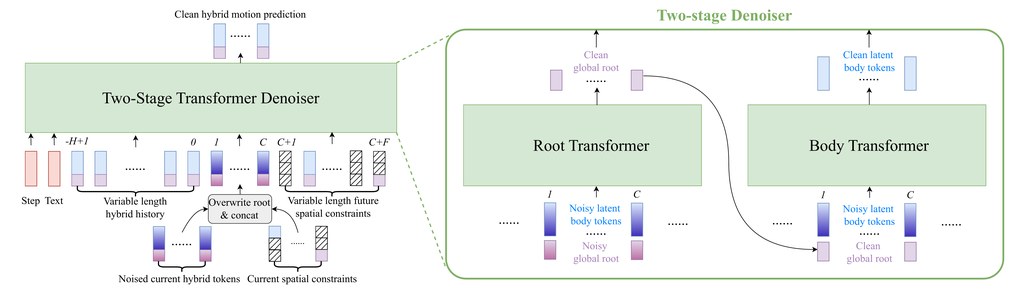
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。

它支援的約束方式幾完整,包括 root paths、waypoints、full-body keyframes,以及 sparse joint positions/rotations,亦可混合使用。更重要的是,約束唔一定只限當前生成視窗,較遠將來的目標都可以先講定,令角色更容易朝長程目標連續行動,而唔係每幾步就失去方向。

  • 支援 online text-to-motion generation,可即時改提示詞
  • 可加入 root paths、waypoints、full-body keyframes 同 sparse joint constraints
  • 兼顧即時反應、動作品質同長距離控制
  • 面向動畫、模擬、humanoid robotics 等互動工作流

資料提到,ARDY 以大型 motion capture dataset 訓練,並直接用文字標籤與來自真實姿勢抽樣的 kinematic constraints 作條件,令模型原生學會受控生成。研究團隊亦展示了互動式 demo,涵蓋動態文字控制、關鍵幀約束、路徑跟隨同即時 locomotion control;定位上,它較適合需要邊調邊看結果的內容製作與研究場景。

項目主頁 · 模型

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, VLA, 提示詞, Robotic, 框架, 軟件, 3D, 動畫, Dataset 數據集

DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

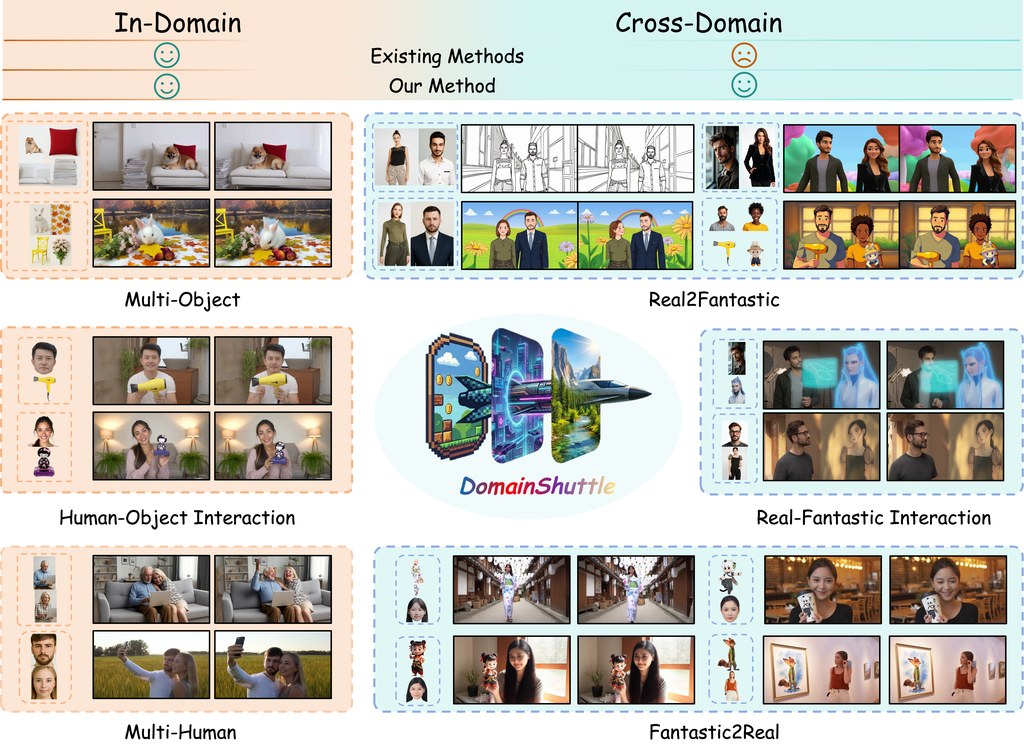
DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

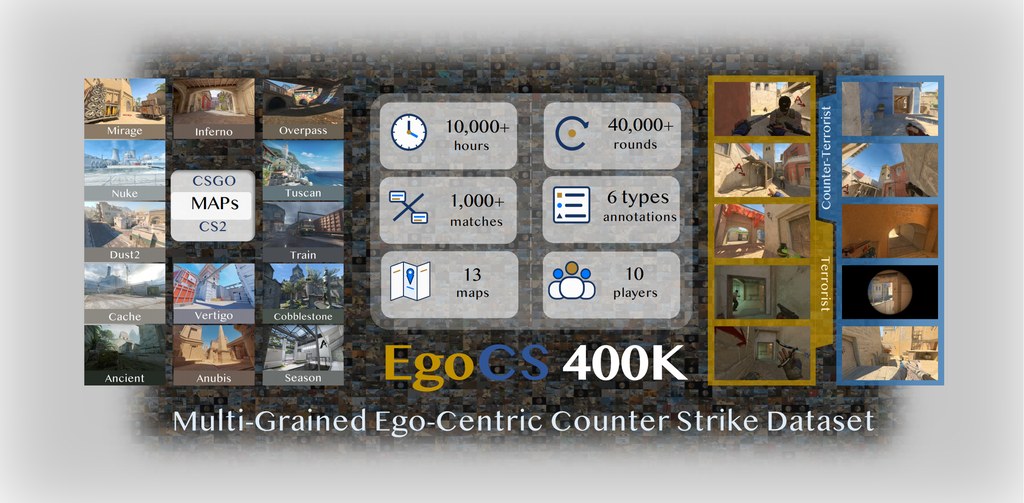
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, 庫, 動畫, Dataset 數據集

LIA-X 肖像動畫器

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。 LIA-X 功能列表 LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用: 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。

LIA-X 功能列表

LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用:

  • 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。
  • 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。
  • 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。
  • 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。
  • 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。
  • 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。
  • 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

Categories: 開源, 數字人, 視頻模型, 影像模型, 影像處理, 動畫

Page 4 of 5
1 2 3 4 5