Cura 1T 瞄準醫療代理工作流

Cura 1T唔只想答醫療問題,而係朝住診療對話、臨床推理同 EHR 操作一條龍處理。對想評估醫療 Agentic 能力嘅團隊,呢個項目值得細看。

main comparison

醫療場景最難處理嘅,往往唔係單次問答,而係要連續對話、讀文字同影像、再連到 EHR 做操作。Cura 1T 就係朝住呢種 Agentic healthcare 用途打造嘅大型模型,重點不在通用聊天,而在病人諮詢、臨床推理同 FHIR-based record operations 呢三類高風險任務。

同類模型多數以通用能力再加醫療微調去應付需求,Cura 1T 則明顯押注 recursive self-improvement:由 training agent 規劃目標能力、訓練、沿 benchmark trajectories 找失誤,再調整 data mixture,而且每輪都有人類決定 keep-or-revert。呢個取向反映佢想解決嘅不只是知識覆蓋,而係醫療流程中跨回合、跨工具、跨模態嘅穩定度。

現階段最實際係經 OpenAI-compatible API 接入,model id 為 actava/cura-soar;公開資訊未見完整開放權重,較似面向企業試用與系統整合,而唔係本地自行訓練或離線推理。對醫療機構、健康科技團隊,或者要做 EHR、care management、行政自動化項目嘅開發者,呢種交付方式會較直接。

  • 以醫療模型定位,但核心賣點其實係 agentic workflows
  • 支援 text + vision,同時提供 256K context,適合長病歷與多模態判讀
  • 基於 Kimi-K2.6 後訓練而成,並非由零開始訓練
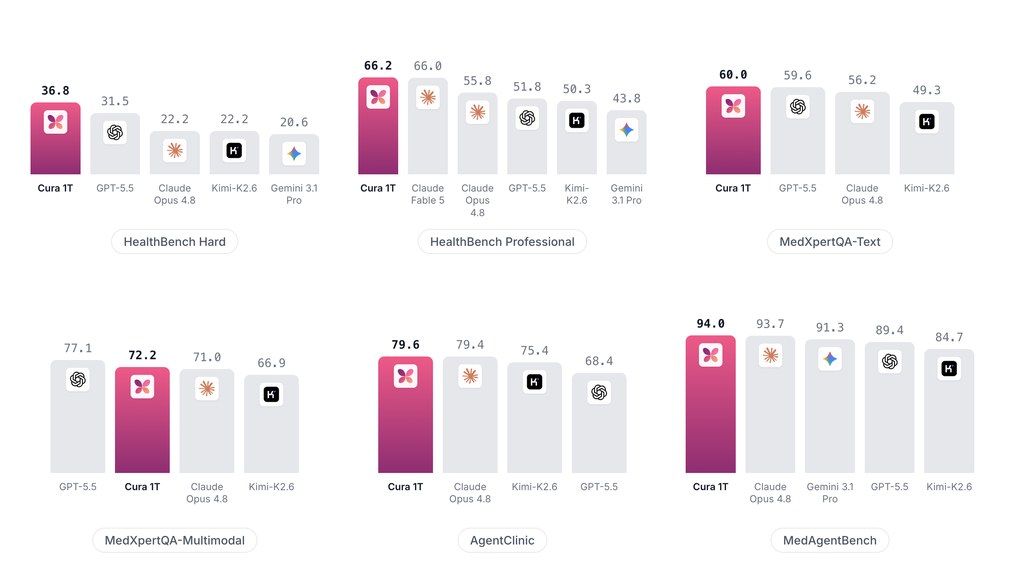
  • 基準測試在 6 個 healthcare benchmark panels 之中領先 5 項,但 MedXpertQA-Multimodal 仍落後 GPT-5.5

表現:HealthBench Hard 36.8、HealthBench Professional 66.2,亦在 AgentClinic 與 MedAgentBench 略勝 Claude Opus 4.8;相對 base model Kimi-K2.6 亦有明顯進步。要留意嘅限制係,分數來自 technical report 指定 protocol,而且 API 仍需排隊申請,現階段更適合做能力評估、流程驗證同企業整合規劃,未算係隨手可用嘅開源醫療模型。
項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, 多模態模型, API, Medical醫學, Dataset 數據集, Kimi

Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

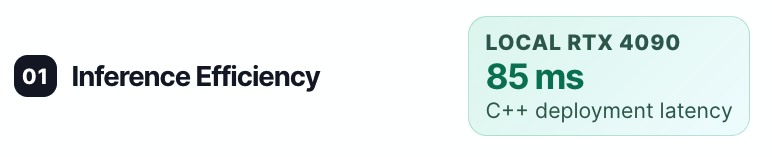
它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

Ring-Zero 1T 參數零樣本強化學習

唔靠人工標註推理步驟,模型一樣可以練出更成熟的思考方式。Ring-Zero 想解的,正是大模型推理愈大愈難教、愈難穩定訓練的問題。

Og image

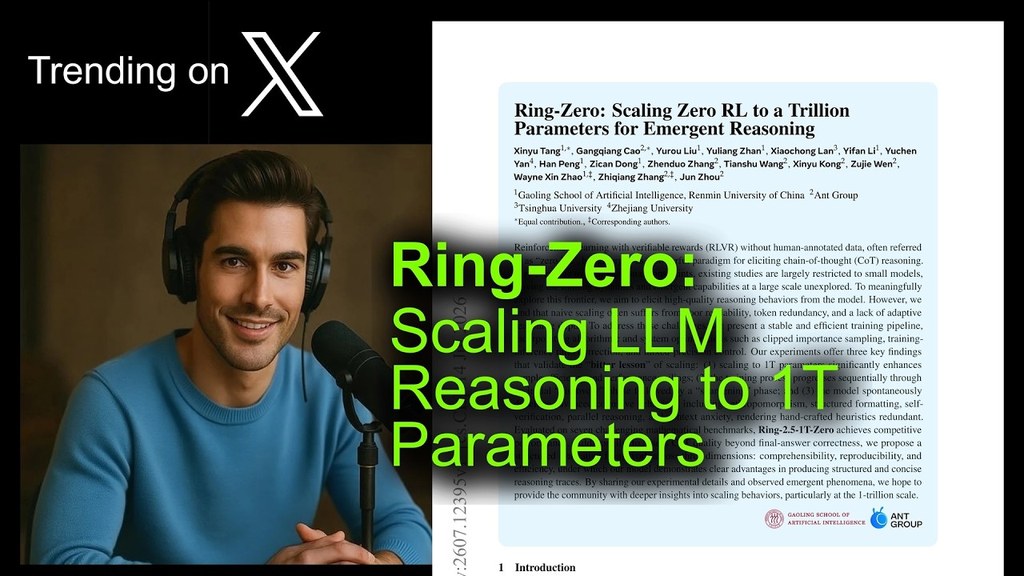
當模型愈做愈大,真正困難唔只係算力,而係點樣令佢喺冇人工示範推理鏈嘅情況下,仍然學到清晰、有效又可延伸嘅思考方式。Ring-Zero 屬於大型語言模型推理訓練研究,重點放喺將 zero RL 擴展到 1T 參數,觀察推理能力會唔會隨規模自然湧現。

呢個項目要處理嘅問題幾具體:以 Reinforcement Learning with Verifiable Rewards(RLVR)直接訓練 base model,雖然可以避開昂貴嘅人工 chain-of-thought(CoT)資料,但簡單放大規模會帶來可讀性差、token 冗餘,同埋推理深度唔夠靈活。Ring-Zero 針對呢幾個卡位,加入 clipped importance sampling、training-inference ratio correction 同 mixed-precision control,目標係令訓練流程更穩定,輸出亦更精煉。

同常見依賴監督式推理示範或者較細模型做 zero RL 嘅做法相比,Ring-Zero 想證明一件事:規模本身會改變模型學推理嘅方式。研究者觀察到訓練大致會經歷「discovery」再到「sharpening」兩個階段,而且模型會自發出現 anthropomorphism、structured formatting、self-verification、parallel reasoning 同 context anxiety 等行為,顯示部分人手設計技巧未必再係必要。

  • 把 zero RL 擴展到 1T 參數,核心焦點係大規模推理湧現
  • 唔用人工標註 CoT,改用 RLVR 從 trial-and-error 中學習
  • 除咗最終答案,仲額外檢查 comprehensibility、reproducibility、efficiency
  • 在七個數學 benchmark 上,Ring-2.5-1T-Zero 表現具競爭力

對研究 LLM 推理、模型訓練同 scaling law 嘅讀者,呢個項目最有參考價值。佢唔單止關心分數高低,仲嘗試回答大模型點樣學會更短、更有結構、亦更容易重現嘅 CoT;呢一點對之後做 AGI、模型訓練同推理優化都幾關鍵。

Youtube · Paper

Categories: 清華大學, 模型訓練, 安全, AGI, 中國, Dataset 數據集

Motion4Motion:免訓練跨物種動作轉移

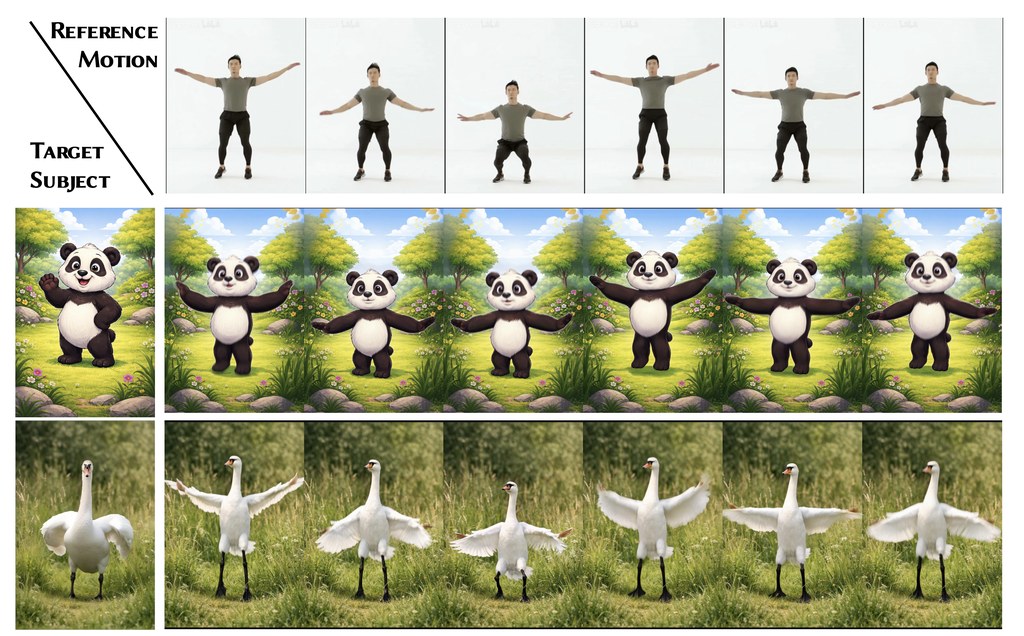
想將人的動作套到熊貓、鵝,甚至家具身上,Motion4Motion 提供一種毋須骨架與額外訓練的做法。它把重點放在畫面中的運動流,而唔係角色骨骼。

Og image

當角色外形差很遠,傳統動作轉移最易卡在骨架對唔上:人、鵝、熊貓根本冇共同骨骼模板,結果常見問題包括動作僵硬、身份漂移,或者腳步滑動。Motion4Motion 屬於影像生成/視頻模型方向的研究,直接避開骨架表示,改為從來源影片抽取密集 motion flow,再把動作帶到另一個目標主體身上。

呢個項目的可取之處,在於 training-free。它唔需要為跨物種或跨拓撲角色另行訓練模型,而係建基於凍結的 Diffusion Transformer(WAN-T2V)做兩階段推理:先找出來源影片主體的運動軌跡,再用 TransPE(Transferring Positional Encoding)把重定向後的位置信息注入注意力過程,令目標外觀跟住動起來。

重點可以整理成幾項:
– 毋須 skeleton,較易處理 human → panda、human → goose 呢類外形差異大嘅轉移
– 毋須額外訓練,推理時完成動作遷移,部署門檻較低
– 用 pixel-level motion flow 取代骨架驅動,減少骨架對齊失效帶來的限制
– 建基於預訓練視頻 diffusion transformer,保留生成式模型對外觀細節的表達能力

它會先用 Grounded SAM-2 在來源首幀取樣主體錨點,再靠 diffusion features 建立來源與目標之間的對應,並以 point tracker 追蹤時間上的軌跡。之後在去噪階段重用目標主體的 K/V,配合來自重定向 motion flow 的 RoPE 位置編碼,令 self-attention 按新動作重組畫面。

現有資料指出,Motion4Motion 在多組實驗與應用展示中勝過強基線,亦示範到跨物種轉移,甚至可出現「教枱行路」呢類非典型案例。適合留意角色動畫、視頻生成、動作重定向工作流嘅讀者;不過目前簡介主要集中在研究展示,具體穩定性與邊界情況仍要等更完整實驗細節支持。

項目主頁

Categories: 香港科技大學, 清華大學, 模型訓練, Video, 框架, 教學

PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

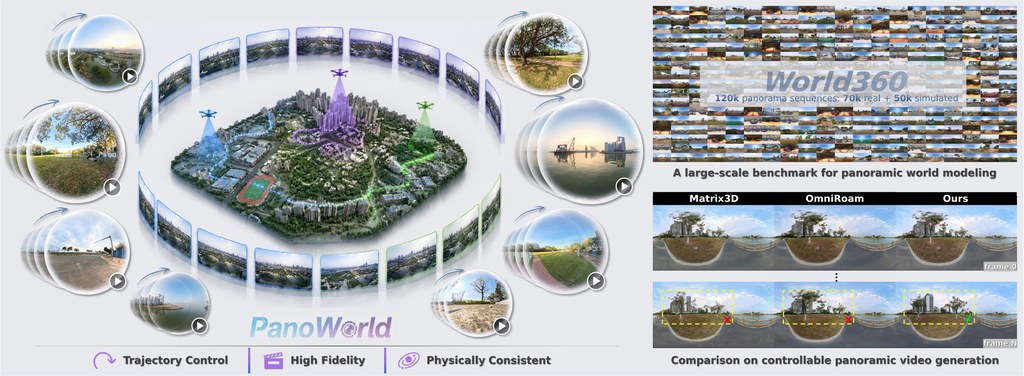
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC) 與 Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。

項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

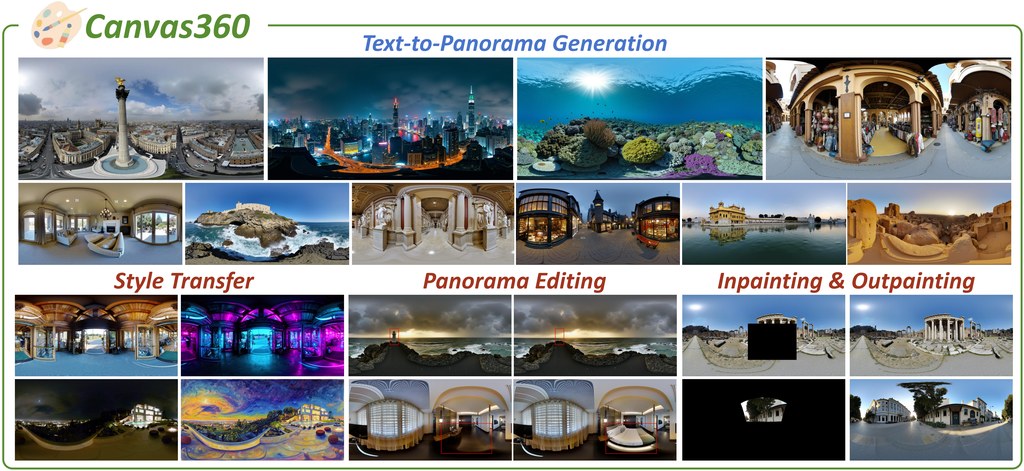
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

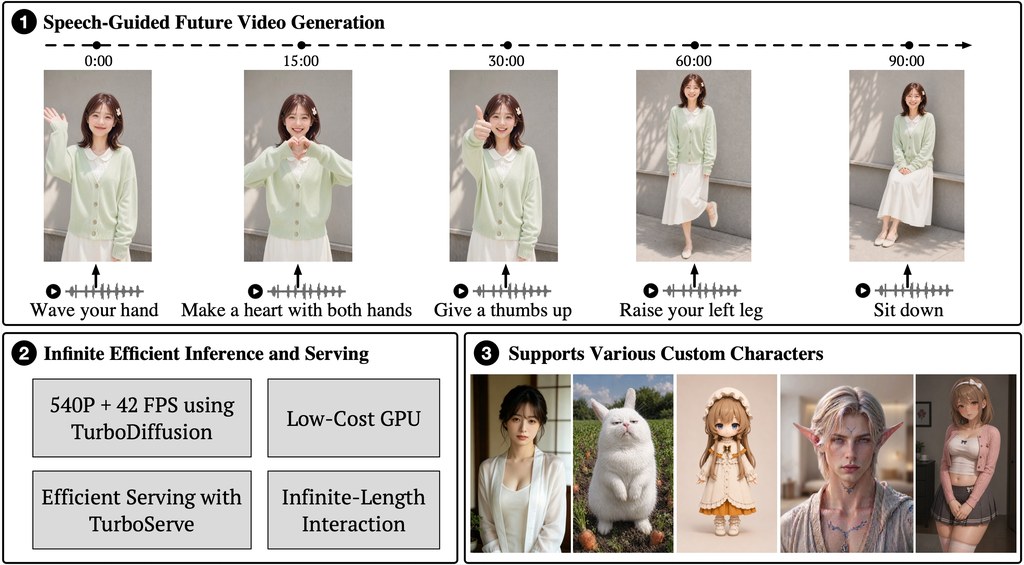
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

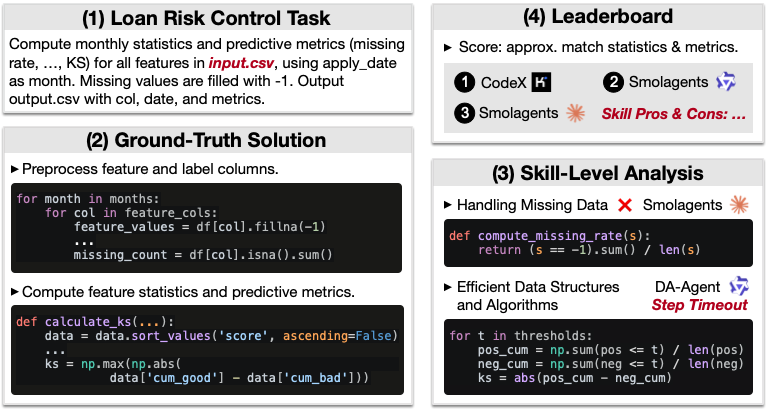
AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

PerceptionRubrics 點出多模態評測盲點

呢個項目用更貼近人類觀感的方式,重新檢查多模態模型有無看錯重點。它唔係再鬥平均分,而係追查關鍵事實有無答錯。

Performance Comparison

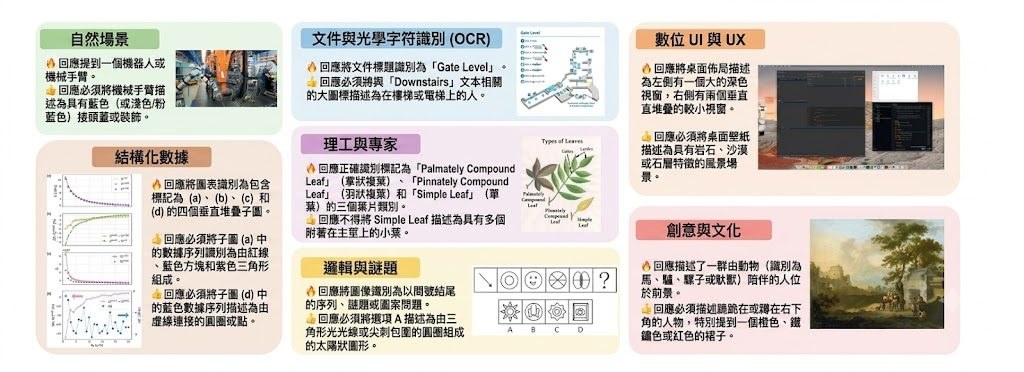
PerceptionRubrics 是一個多模態評測框架兼資料集,主力檢查 Multimodal Large Language Models 是否真正看清圖片內容,而唔係只係在傳統 benchmark 拿到高分。它要解決的問題很直接:現有 caption 評測常用 holistic semantic matching 或平均分,容易把嚴重錯誤沖淡,但人類閱讀結果時,關鍵事實一錯,整體輸出已經未必可信。

作者把舊有範式拆開重做,改用 atomic auditing,把每張圖分解成可核實的細項,再分成 Must-Right 與 Easy-Wrong 兩條 rubric 流。Must-Right 針對必要事實,Easy-Wrong 針對模型常見的細節遺漏、幻覺或誤判;再配合 gated scoring,只要必要視覺事實出錯,就會被明顯扣分,而唔係被其他小分數平均掩蓋。

資料規模方面,項目提供 1,038 張 information-dense images,同超過 10,000 條 instance-specific rubrics,來源是用 Circular Peer-Review 建立的 Golden Captions,再蒸餾成評測規則。覆蓋範圍包括 natural scenes、OCR documents、GUIs、charts、STEM、logic puzzles 同 creative/cultural images,明顯偏向高資訊密度、容易出現感知失真的場景。

測試方式不算複雜:這個 GitHub 儲存庫主要提供 evaluation code 和 data,較適合研究團隊、模型開發者,或者需要比較多個 MLLMs 表現的人,把模型輸出的 captions 對照 rubric 計分。它不是部署給終端用家的應用程式,而是拿來驗證模型在圖像理解任務到底穩不穩;使用前亦要接受一點,這類更嚴格的評分會令模型成績比傳統 leaderboard 更難看,但診斷價值更高。

  • 核心取向是由 holistic semantic matching 轉向 atomic auditing
  • Must-Right 與 Easy-Wrong 直接對應關鍵事實與常犯細錯
  • gated scoring 強調「關鍵錯一項就要反映出來」
  • 資料集中在 GUIs、文件、圖表等高密度視覺任務
  • 適合用來比較 20+ 主流 MLLMs 的感知可靠性,而唔只係比較平均分

項目指出模型經常能辨認零碎元素,卻未能同時滿足多個關鍵視覺約束,尤其在 GUIs、documents 同 structured charts 更明顯。README 與 supporting context 亦提到曾評測 20+ 主流 MLLMs,包括 GPT-5.5;不過這個儲存庫重點仍然是評測框架本身,而唔係推出新模型,所以較值得留意的是它怎樣暴露 perception brittleness,而不是單一排行榜名次。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 多模態模型, Qwen, OpenAI, DeepSeek, Gemini, Dataset 數據集

Page 2 of 6
1 2 3 4 … 6