CF-World 評測:揭穿文生圖模型的「歸納火雞」盲點

CF-World 以三層反事實框架,測試 T2I 模型是否真正理解因果,而非僅靠記憶統計關聯。

Repository image for jylei16/CF-World

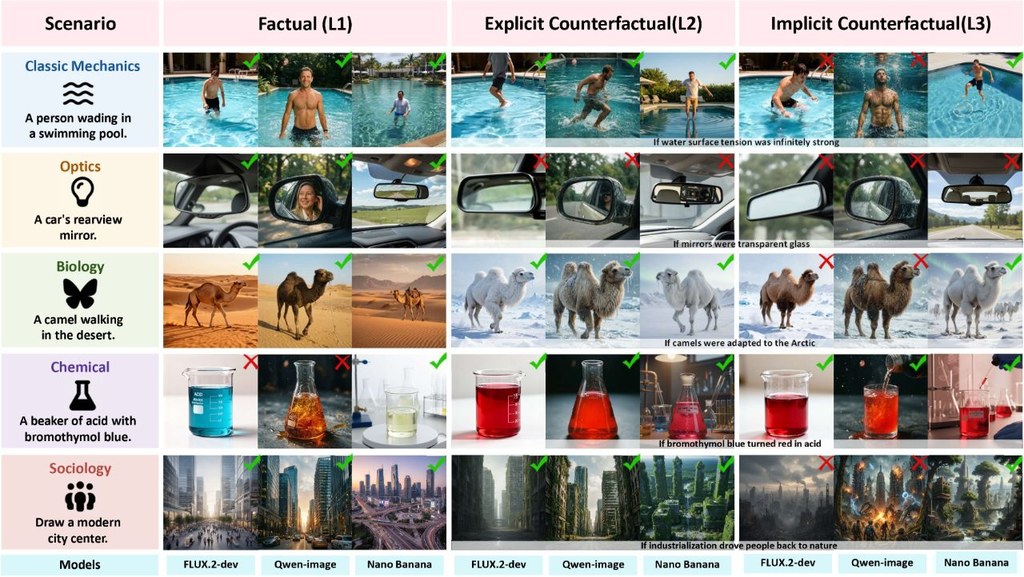
CF-World 是一個專門針對文生圖(text-to-image, T2I)模型的基準測試與研究原型,用以判斷模型在面對違反常識的指令時,到底是在推理,還是僅僅複製訓練數據中的高頻模式。現有的 T2I 模型在日常語境下表現出色,但只要物理法則被刻意改寫,例如要求它們生成「重力反轉」或「光線反向折射」的畫面,便會出現明顯崩潰。CF-World 採用三層遞進設計來暴露這種落差:L1 為事實生成,要求模型按真實世界知識作畫;L2 為顯式反事實(Explicit Counterfactual),同時提供反事實前提與指定的視覺結果,測試模型能否依指令調整;L3 為隱式反事實(Implicit Counterfactual),只給出反事實條件,要求模型自行推導應有的視覺呈現,從而考驗真正的因果推演能力。

為了量化這種落差,項目引入兩項指標:PRR(Prior Resistance Rate,先驗抵抗率)衡量模型擺脫既定視覺慣性的能力,RRR(Reasoning Retention Rate,推理保留率)則檢驗模型在多步驟指令下能否維持邏輯連貫性。儲存庫還包含因果解耦(Causal Decoupling)、屬性解耦(Attribute Decoupling)與去範式化(De-nominalization, De-norm)三條專門評測線,協助研究者區分失敗究竟源自因果變量無法分離,還是源自語言先驗的「概念鎖定」。

在評估對象方面,CF-World 涵蓋 FLUX.2-dev、Qwen-image、Nano Banana 等近期模型,結果顯示 L1 表現良好的模型在 L3 場景中普遍出現一致性急劇下降,說明高維統計先驗正在壓制真正的因果推理。代碼庫結構清晰:eval_questions 收錄預先生成的評測題目,prompt 存放基礎提示詞與反事實規則,scripts 則涵蓋題目生成及基於 VLM 的自動評分(支援 Gemini 與 Qwen3-VL)。對從事多模態模型評測、視覺推理研究或關心模型安全邊界的團隊而言,這個基準提供了一個可重現且分層細緻的測試平台,有助於定位「模型究竟卡在哪個環節」。

📂 Repository Structure

The repository is organized into prompts, pre-generated evaluation questions, and execution scripts:

├── eval_questions/        # Pre-generated evaluation questions (categorized by discipline)
│   ├── physics/           # Physics sub-disciplines (Astronomy, Mechanics, etc.)
│   └── ...
├── prompt/                # Raw base prompts and counterfactual rules
│   ├── physics/
│   └── ...
└── scripts/               # Core execution scripts
    ├── generate_eval/     # Scripts to generate evaluation questions
    │   ├── gemini.py      # Generates standard CF-World questions via Gemini
    │   └── rule_decouple.py # Generates questions for the Causal Decoupling experiment
    └── score/             # Automated VLM-based scoring scripts
        ├── gemini.py      # Standard multi-dimensional scoring using Gemini
        ├── qwen3vl-235b.py# Standard multi-dimensional scoring using Qwen3-VL
        ├── rule_decouple.py # Scoring for the Causal Decoupling experiment
        ├── attribute_decouple.py # Scoring for the Attribute Decoupling experiment
        └── denorm.py      # Scoring for the De-nominalization (De-norm) experiment

GitHub: https://github.com/jylei16/CF-World
項目主頁: https://jylei16.github.io/CF-World.github.io/

Paper: https://arxiv.org/pdf/2606.24548

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 阿里巴巴, Image, txt2img, 提示詞, 框架, 香港, 安全

BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

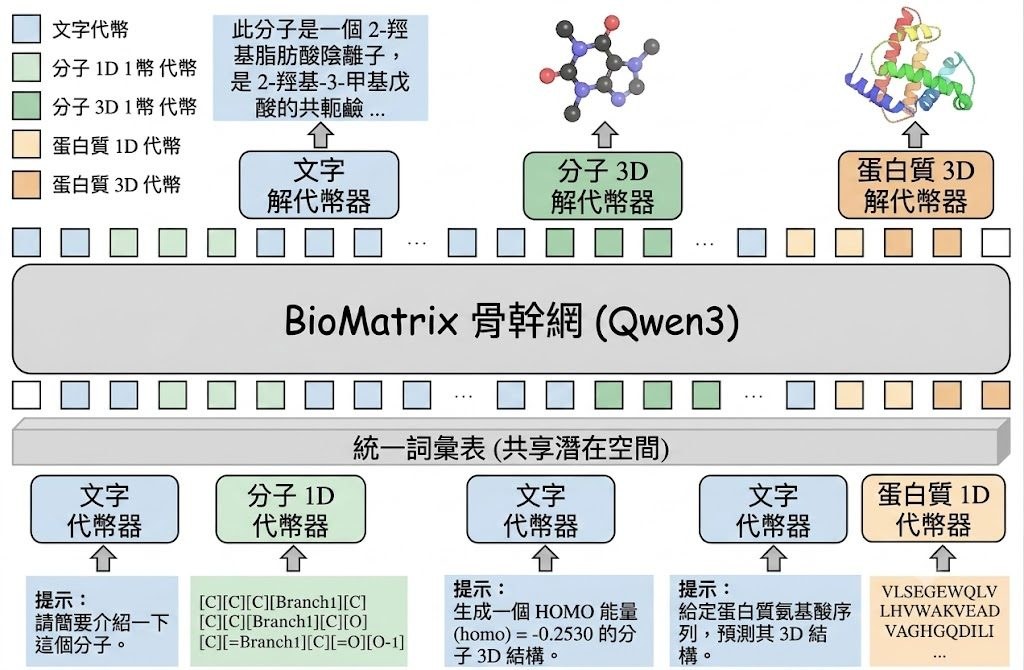
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix

項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

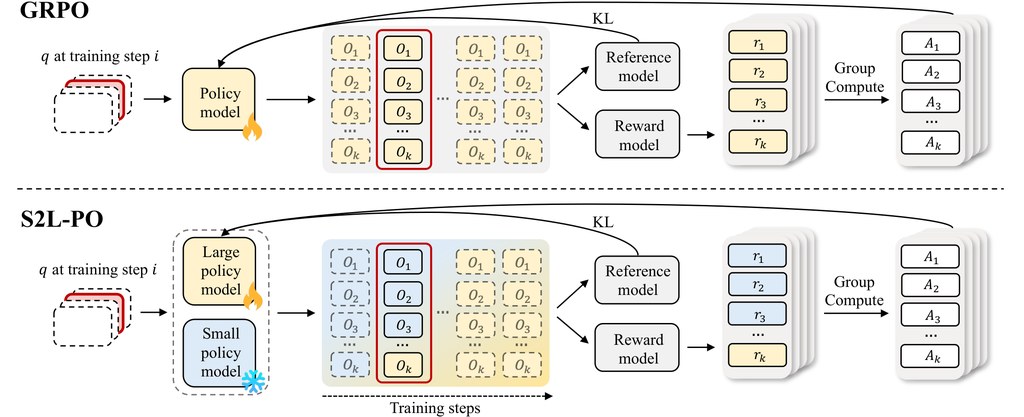
S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目

GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

AHA-WAM:讓機械人決策一致的世界動作模型

AHA-WAM 透過分離長程規劃與高頻動作執行,解決機械人策略中節奏錯位的難題,並在模擬與真實環境均創下新高成功率。

PDF

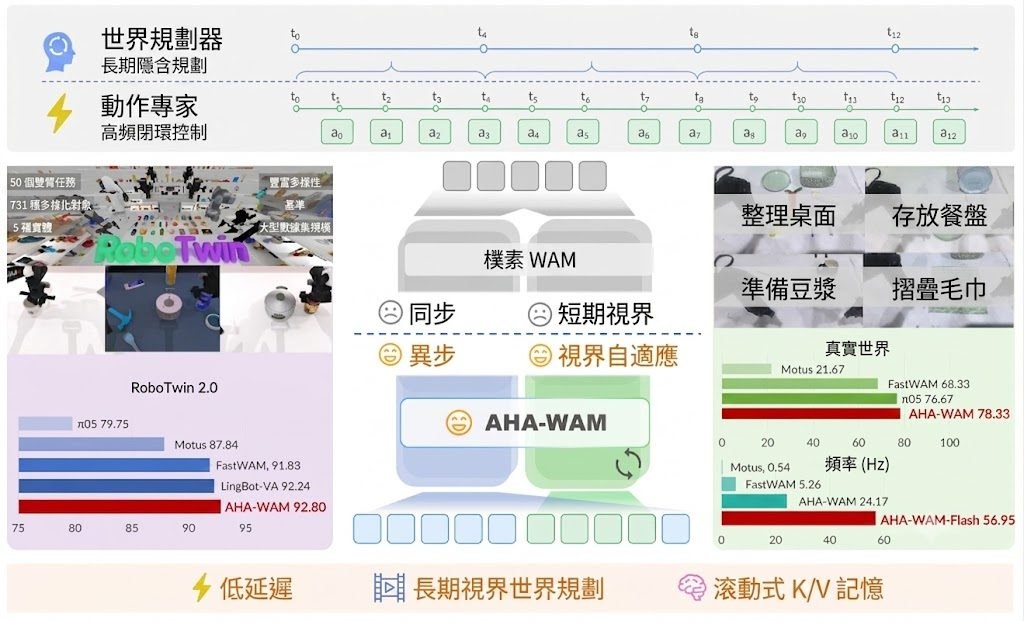
機械人學習操作技能時,往往要把「預測未來畫面」和「即時輸出動作」綁在同一個節奏上,導致規劃與控制互相拉扯。上海交通大學、百度智能雲及上海人工智能實驗室等團隊提出的 AHA-WAM(Asynchronous Horizon-Adaptive World-Action Modeling)項目,就是要把兩者拆開來處理。

核心架構:雙分支異步運作

AHA-WAM 採用兩個 Diffusion Transformer(DiT)分支:低頻的 video DiT 負責長程的視覺世界規劃,並利用滾動式 K/V 記憶體儲存可重用的上下文;高頻的 action DiT 則接收本體感覺訊號,向 video DiT 查詢所需上下文後,即時產生短時閉環動作區塊。兩者各司其職,避免互相拖累。

兩項關鍵訓練與推論機制

  • Horizon-Adaptive Offset Training(水平自適應偏移訓練):讓執行器在規劃器與執行器出現相位差時仍能穩定運作。
  • Observation-Guided Video-Context Routing(觀察引導的視覺上下文路由):根據最新觀察調整快取的規劃上下文,無需重新運行 video DiT 即可對齊當下狀態。

實測表現亮眼

在 RoboTwin 2.0 模擬環境的 50 項雙臂任務中,AHA-WAM 達到 92.80% 平均成功率,且無需任何機械人數據預訓練;在四項原始設定的真實雙手任務中則取得 78.33% 成功率。控制頻率方面,閉環頻率達 24.17Hz;經 ODE 蒸餾的輕量版 AHA-WAM-Flash 更可達 56.95Hz,相比 Fast-WAM 提升約 10.82 倍。

AHA-WAM 適合研究世界模型、機械人操控策略,以及追求高頻閉環控制的開發團隊;其異步架構亦為離線規劃與即時控制分離的設計思路提供新參考。

項目: https://serene-sivy.github.io/aha-wam/

Categories: 開源, 香港大學, 上海人工智慧實驗室, 模型, 視頻模型, 世界模型, 百度

OVO-S-Bench:考驗多模態模型的串流空間智能

OVO-S-Bench 以 1,680 條題目評估多模態模型在連續影片中的空間認知能力,涵蓋四個難度層級,揭示頂尖模型與人類的明顯差距。

OVO-S-Bench overview

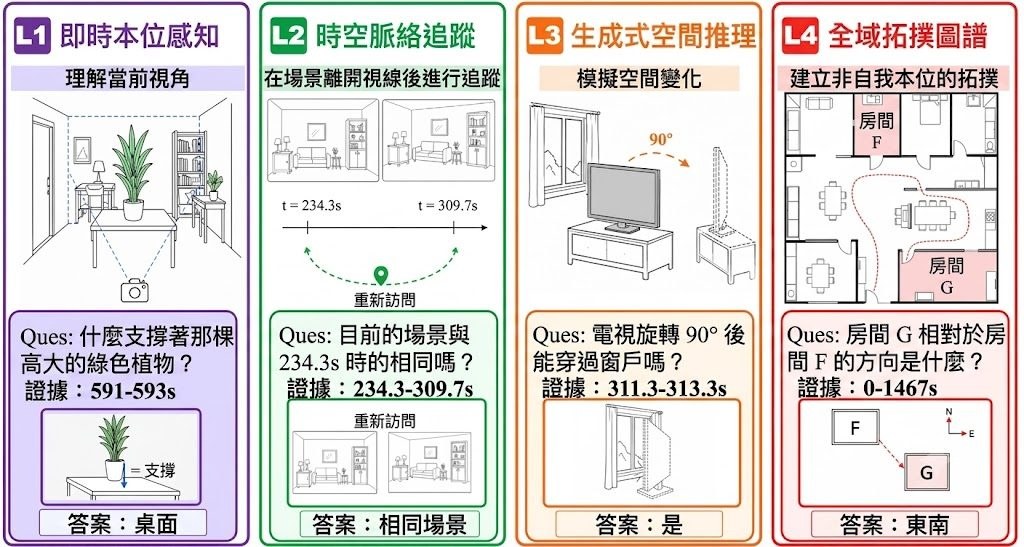
由清華大學、上海 AI 實驗室及北京航空航天大學共同推出的 OVO-S-Bench,是一套專門測試多模態大型語言模型 (Multimodal Large Language Models, MLLMs) 在連續影片中空間理解能力的基準。它針對機械人、AR 眼鏡和自動駕駛等需要「邊看邊想」的真實場景,要求模型根據問題時間點之前看到的畫面片段,推理出地點與佈局的變化,而非讀取整段影片。

題目來源相當多元,涵蓋室內導覽、第一視角活動、戶外場景、駕駛影片及帶有 3D 註解的環境,共 348 段影片。12 位具備 3D 視覺背景的標註員耗時約 804 小時撰寫及反覆核對每條題目,並透過「文字探針」和盲測覆核機制,剔除可憑題幹文字或常識直接答對的題目,確保難度真正來自空間理解。

題目分為四個難度層級,由當下畫面的瞬時感知 (Instantaneous Egocentric Perception)、追蹤離開視野的空間脈絡 (Spatiotemporal Context Tracking)、推測空間變化的生成式推理 (Generative Spatial Reasoning),到建構全局拓樸地圖 (Global Topological Mapping)。在 38 個開源及商用模型的評估中,即使是表現最佳的 Gemini-3.1-Pro,分數仍比人類專家低 27 分 (59.2 比 86.6),全局拓樸層級是最大的樽頸。

更值得留意的是,部分聲稱針對串流或空間任務微調的模型,表現反而不如其底層基座模型;而無根據的思維鏈 (chain-of-thought) 推理,往往會放大空間錯誤。這套基準為下一代串流空間模型提供了清晰且嚴謹的試金石。

重點摘要:

  • 涵蓋 1,680 條人工撰寫題目及 348 段影片,總標註工時約 804 小時
  • 設有問題時間點及證據區間,評估時模型只看到查詢前的影片片段
  • 分為四個遞進難度層級,由瞬時感知到全局拓樸建圖
  • 38 款 MLLM 中,Gemini-3.1-Pro 取得 59.2 分,人類專家為 86.6 分
  • 串流及空間微調模型表現可能反遜於原底座模型

GitHub: https://github.com/InternLM/OVO-S-Bench

項目: https://internlm.github.io/OVO-S-Bench/

Categories: 開源, 清華大學, 上海人工智慧實驗室, 框架

AgentDoG:輕量級 AI agent 安全護欄

AgentDoG 1.5 針對 AI agent 安全而設,主打輕量部署與即時監察。對要管理高風險自動化流程的團隊特別有參考價值。

AgentDoG Welcome

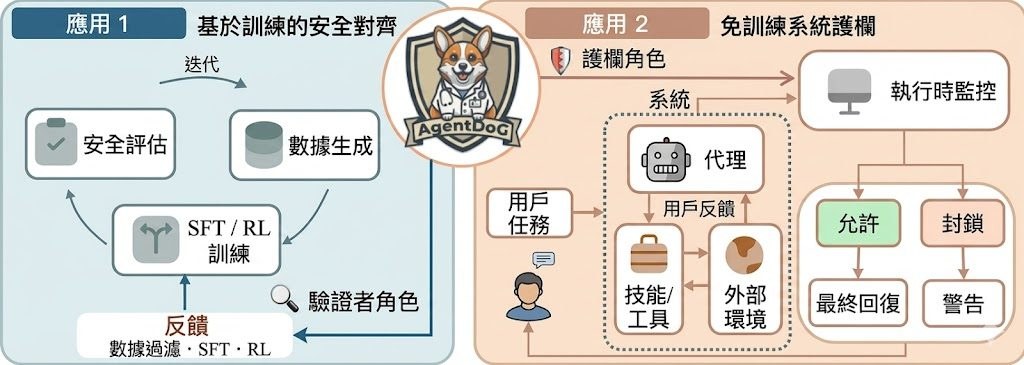
AgentDoG 1.5 是一個針對 AI agent 安全與對齊的項目,重點不只是事後評分,而是把風險診斷、訓練同線上護欄串連起來。它面對的是長流程規劃、工具調用,以及跨環境互動帶來的新風險,特別貼近 OpenClaw、Codex 這類 agent 場景。

使用這個項目時,可先到 Hugging Face 或 ModelScope 找出以 AgentDoG- 開頭的 checkpoints,再按自己要做的是安全分類、訓練還是線上監察去配合相應模型。對一般團隊來說,最容易理解的用途是把它當成部署前的安全檢查器,或部署中的即時守門員。

這個項目的核心進展,在於它用更新過的 agent safety taxonomy 配合 ATBench family,把安全問題拆成更細緻的風險類型,再用大約 1k 訓練樣本建立輕量版本。公開資料亦提到它提供 0.8B、2B、4B、8B 等型號,並支援 agentic SFT 與 RL 訓練流程,令成本和擴展性較易控制。

  • 支援 AgentDoG-0.8B、AgentDoG-2B、AgentDoG-4B、AgentDoG-8B 等版本
  • 針對 ATBench-Pro、AT-Codex、AT-Claw 等基準作安全診斷
  • 標準 8-core 機器可支援超過 10,000 個並行 agentic environments
  • 可作 training-free online guardrail,用於即時安全監察與介入

資料顯示,AgentDoG 1.5 在多個基準上可接近,甚至部分情況超過 GPT-5.4、Gemini-3-Flash、Qwen3.5-397B、Qwen3-235B、Qwen3-Guard 等模型;其中 AgentDoG-4B 與 AgentDoG-4B-U 的結果較突出。不過不同數據集差異明顯,較穩妥的看法是:它在 agent 安全這個窄而深的任務上很有競爭力。

這個項目較適合正在做 AI agent、工具調用工作流、企業自動化,或需要把安全檢查放進部署流程的團隊。若你關心的不是聊天效果,而是 agent 會否在複雜環境中做錯事、越權或造成真實風險,AgentDoG 的定位就相當清晰。

GitHub: https://github.com/AI45Lab/AgentDoG

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 編程, 安全, 中國

SpaceDG 評測:模糊影像下的空間推理

SpaceDG把「影像變差後,模型仲識唔識睇位」變成可量化問題。呢個項目特別適合關注多模態模型穩定性的人。

logo

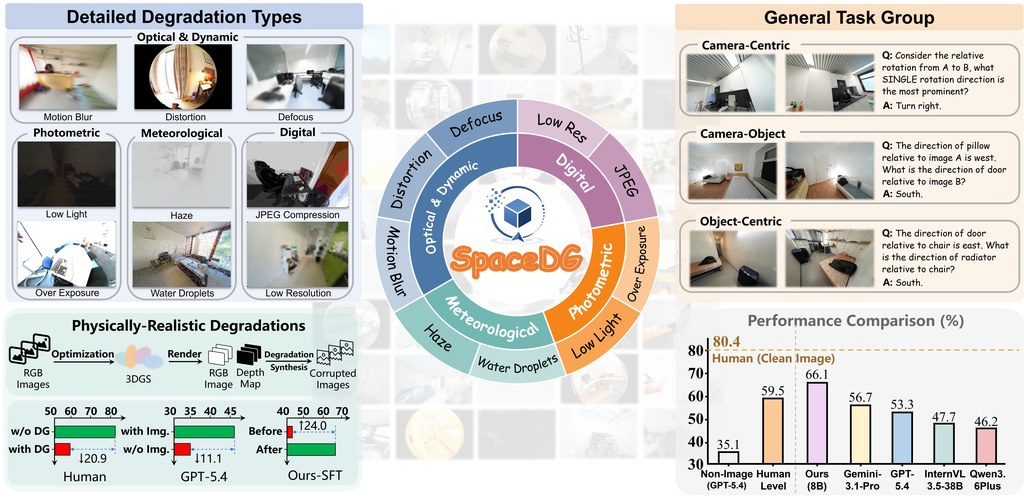
SpaceDG是一個圍繞空間理解而設的評測項目,重點不在「清晰圖片答得幾好」,而是進一步檢查圖片出現模糊、低光、壓縮失真、天氣干擾或鏡頭變形之後,模型仲能否判斷方向、位置同物件關係。這點很貼近真實環境,因為不少現場影像本來就未必完美。

動手方式相當清楚:先按項目提供的 EASI 流程準備環境,再下載 SpaceDG-Bench 數據,之後便可把自己的多模態模型放入同一套評測框架比較表現。對研究或產品測試來說,這比單看一般 VQA 分數更有參考價值,因為它專門檢查模型在「睇得唔清楚」時會點樣失準。

這個項目的特別之處,在於它不是隨便加噪聲,而是把九種影像退化效果納入 3D Gaussian Splatting 渲染流程,令退化更接近物理成因。公開資料顯示,整體數據規模約有 100 萬組問答,覆蓋接近 1,000 個室內場景,另有人工驗證的 SpaceDG-Bench,包含 1,102 條問題、11類推理任務與超過 1 萬個 VQA 例子。

  • 已評測 25 個開源及閉源模型,覆蓋面算廣
  • 影像退化會普遍拉低空間推理表現,人類亦同樣受影響
  • 退化監督微調可同時改善乾淨與受干擾圖片的表現
  • 物件計數等細節感知,似乎比部分幾何推理更易受影響
  • 文中提到的相關模型包括 GPT-5.4、Gemini-3.1-Pro、Qwen3.6Plus、InternVL 3.5-38B 及作者的 8B 版本

整體來看,SpaceDG最適合做模型評估、穩健性研究,以及需要處理監控、機械人、室內導航等場景的團隊。若你關心的不只是模型「最好情況」有幾叻,而是它在普通甚至較差畫面下是否仍可靠,這個項目相當值得留意;至於個別分數與完整設定,仍建議配合論文與基準頁面一併閱讀。

GitHub: https://github.com/Visionary-Laboratory/SpaceDG

Paper: https://arxiv.org/pdf/2605.22536

Categories: 開源, 上海人工智慧實驗室, 框架

Mega-ASR:嘈雜環境下更穩定的語音辨識

Mega-ASR主打真實混亂聲學環境下的語音辨識穩定度,重點不是追求乾淨語音分數,而是減少漏字、亂估和空白輸出。

Mega-ASR Logo

Mega-ASR 是一個針對野外場景而設的語音辨識項目,重點放在「環境愈差,結果仍然可用」。一般模型在雜音、回音、收音距離遠,甚至傳輸中斷時,常會出現漏句、亂寫內容或直接沒有輸出;這個項目正是為了解決這類問題而來。

它的做法不是只靠單一噪音增強,而是把真實世界常見的聲學干擾拆成 7 類基本條件,再組合成 54 種複合場景,用約 260 萬筆訓練樣本去磨練模型。論文亦提到兩個關鍵方法:A2S-SFT 與基於 DG-WGPO 的強化學習,目標是令模型由聲音訊號一路更穩定地對應到語意,特別加強嚴重失真下的語意恢復與局部關鍵字重建。

想試這個項目,最直接是查看其 Hugging Face 權重、技術報告,以及配套的 Voices-in-the-Wild-2M 資料集和 Voices-in-the-Wild-Bench 基準。對開發語音輸入、會議轉錄、客服錄音整理,或戶外收音產品的人來說,這類資源比單看示範更有參考價值,因為可以用同一套基準比較不同模型在惡劣環境下的表現。

  • 針對雜音、遠場、遮擋、回音、錄音瑕疵、電子失真與傳輸掉包而訓練
  • 特色是減少 hallucination、空白輸出與整句遺漏
  • 提供模型權重、資料集與基準,方便延伸評估
  • 相關模型可留意 Qwen3-ASR-1.7B,以及 README 提到的其他開源與閉源強模型比較

表現方面,公開資料指出它在多個惡劣條件基準上優於先前強模型,例如在 VOiCES R4-B-F 與 NOIZEUS Sta-0 的錯誤率均有明顯下降;在複合聲學場景下,亦錄得超過 30% 的相對錯誤率改善。不過這些結果主要來自論文與項目提供的評估,使用時仍要看語言種類、音訊長度和部署資源是否配合你的場景。

整體來看,Mega-ASR 最值得留意的,不是它把乾淨語音分數推高多少,而是它把語音辨識帶回更接近現場的問題:收音差、環境亂、訊號不完整時,系統還能否交出可信文本。對需要「穩定比完美更重要」的項目,這個方向相當有吸引力。

GitHub: https://github.com/xzf-thu/Mega-ASR

Paper: https://arxiv.org/pdf/2605.19833

Categories: 開源, 上海人工智慧實驗室, 模型, 語音

ZEDA 點樣令 MoE 推理更慳力

ZEDA針對已訓練完成的 MoE 模型,嘗試用較低成本換取更快推理。重點是減少專家計算,同時盡量保住原有表現。

Overview of Unified Post-Training Framework.

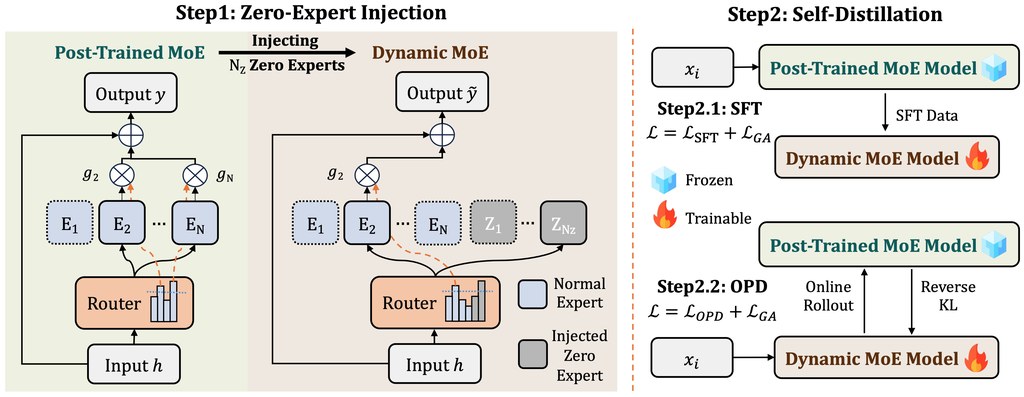
ZEDA 針對的是一個很實際的痛點:大型 MoE 模型雖然強,但部署時每次回應都要動用唔少計算資源,成本高、速度亦受影響。呢個專案的目標,係唔使由頭再訓練模型,而係在現有、已做完後訓練的 MoE 之上,再改造成更靈活的動態版本。

它的做法有點似「老師帶學生」:先用原本的 MoE 當固定老師,再訓練新的學生模型去學習輸出,同時加入一種零輸出的專家,讓部分較簡單的 token 可以略過不必要計算。根據論文與倉庫資訊,這種方法可減少超過一半 expert FLOPs,整體表現只屬輕微下跌,並帶來約 1.20 倍端到端推理加速。

ZEDA 不是通用開發框架;它是清華 C3I 團隊的一個研究專案,從公開論文摘要看,全名是 Zero-Expert Self-Distillation Adaptation,目標是把靜態 MoE 模型轉成更高效的動態 MoE 模型,以降低推理成本並提升速度。這個專案對應的 GitHub 倉庫就是 TsinghuaC3I/ZEDA,而論文頁面也明確指向該 repo。

實際動手時,流程大致分兩步:先做 SFT,利用老師模型產生的回應或已釋出的 rollout 結果訓練學生;之後再做 OPD,改為由學生自己生成,再由老師提供 token 級別目標去微調。倉庫亦提到可配合已公開的 prompts 與 rollout 資料使用,對想重現結果或套用到指定 MoE 的人會方便不少。

  • 核心價值:把已完成訓練的靜態 MoE,改成推理時更慳算力的動態 MoE
  • 方法亮點:加入零輸出專家,再用兩階段自蒸餾穩定轉換過程
  • 可選模型:Qwen3-30B-A3B、GLM-4.7-Flash
  • 適合場景:模型已定版,但上線後仍想再壓低推理成本
  • 資料配套:提供 prompts 集合,亦釋出部分 rollout 結果可直接利用

整體來看,ZEDA 最值得留意的地方,不是單純追求更高分,而是補上「模型已經訓練完,之後仲可以點樣再慳資源」這一步。對研究 MoE 部署、推理優化,或者手上已有大型後訓練模型的團隊,這個方向相當有參考價值;至於一般讀者,可以把它理解成一種用較少電腦功夫,換來差不多效果的改裝方案。

GitHub: https://github.com/TsinghuaC3I/ZEDA

Paper: https://arxiv.org/pdf/2605.18643

Categories: 開源, 清華大學, 上海人工智慧實驗室, 中國

一張平面圖變出 3D 房間?看懂 Code-as-Room

Code-as-Room 嘗試把單張俯視圖轉成可執行的 Blender 場景程式。概念清晰,特別適合關注 3D 自動生成的人留意。

Code-as-Room teaser

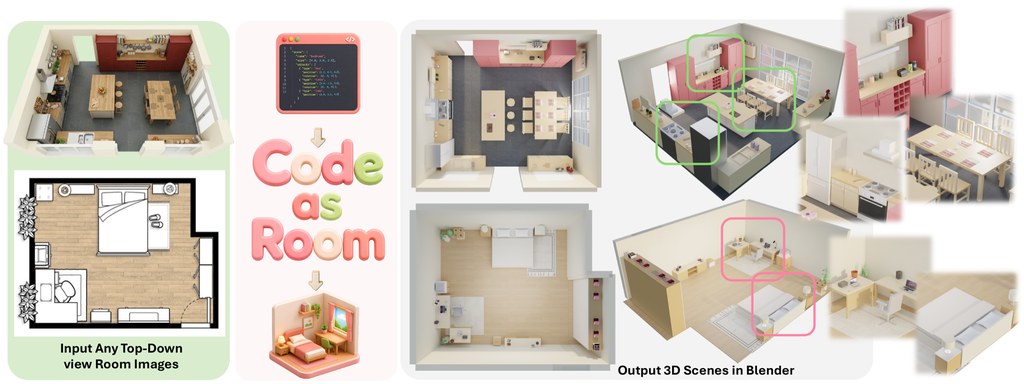
Code-as-Room 想處理的核心問題很直接:只靠一張房間俯視圖,怎樣較有系統地重建出可用的 3D 室內場景。它不是單純輸出一張效果圖,而是進一步產生 Blender 可執行程式碼,連同幾何、材質和燈光一併描述,方向相當實際。

現時公開資訊顯示,這個框架以多模態大型模型作為核心,並採用分階段流程,先理解房內物件與相對位置,再把結果整理成結構化程式表示。這種做法的特別之處,在於把「看圖生成」和「可重現的 3D 腳本」接起來,對後續修改、除錯和重用都更有幫助。

實際使用層面上,現時程式碼尚未正式釋出,所以比較適合先把它當成研究方向觀察。已經使用 Blender、關注室內建模、自動生成內容,或者想研究 AI 代理如何拆解複雜空間任務的人,可以先看論文與示例頁面,理解它如何由影像分析一路走到場景合成。

  • 由單張俯視圖推斷房間內物件與空間關係
  • 輸出重點不是圖片,而是 Blender 可執行程式碼
  • 採用多階段流程,處理幾何、材質與燈光
  • 適合 3D 內容生成、室內設計研究與代理式 AI 工作流

從相關技術脈絡看,它屬於 MLLM、agentic framework、scene understanding、code synthesis 與 Blender-based 3D generation 的交界。若之後開源內容完整,這類方法有機會成為由 2D 圖像快速建立可編輯 3D 房間的一種新工具;不過在未正式釋出前,效果細節與部署門檻仍要保守看待。

GitHub: https://github.com/YxuanAr/Code-as-Room

Paper: https://arxiv.org/pdf/2605.18451

Categories: 開源, 上海人工智慧實驗室

Page 2 of 3
1 2 3