PermaVid 令影片修改後仍然連貫

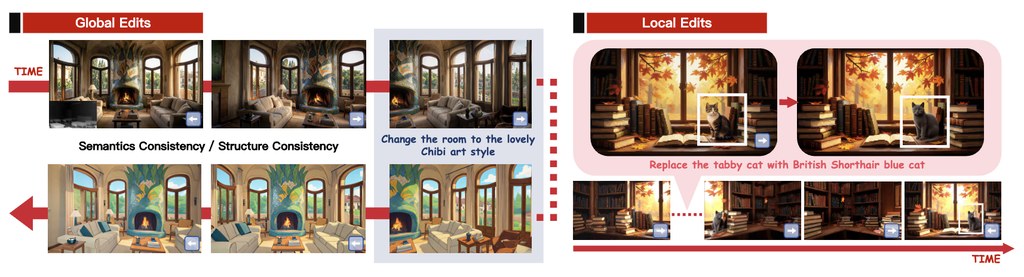
PermaVid 想解決影片一改風格或場景後就前後不一致的老問題。它用分離式記憶設計,兼顧外觀變化與空間結構。

teaser

很多影片生成方法處理編輯任務時,會把過往畫面當成單一記憶來源;一旦做了 style、season、weather 或 time 這類修改,舊記憶就可能變成過時參考,之後生成的鏡頭容易出現人物變樣、場景走位錯亂,或者視角切換後對不上。PermaVid 提出的方向,是把「外觀語意」同「幾何結構」分開保存,避免一次編輯令全部上下文一齊失效。

這是一個影片生成框架,核心工作是讓 edited video 在跨時間、跨視角、跨多次修改之下,仍保持內容連貫。它使用 disentangled context memory:RGB context memory 負責記錄 semantic appearance,depth context memory 則保留 geometry-only structure,再配合 edit-aware memory update and retrieval,把新修改過的資訊逐步寫回記憶。

和一般只靠單一記憶庫或單一路徑條件控制的方法相比,PermaVid 的取捨很清楚:系統更複雜,也要同時處理 RGB 與 depth 兩種脈絡,但換來的是編輯之後的長期一致性。從儲存庫資訊看,項目亦提供 dataset、paper 及 demo,並依賴 Wan2.1-VACE-14B、Qwen-Image-Edit、Qwen3-VL-8B-Instruct 等模型,顯示它不是輕量玩具,而是偏研究型、多模組組合的完整流程。

  • 支援相機移動控制,例如 direction-frames-speed 這類格式
  • 編輯類型涵蓋 style、season、weather、time 等全局變化
  • 重點不只是生成單段片,而是修改之後仍維持後續片段一致
  • 需要較完整環境配置,包含 PyTorch、CUDA 與額外訓練/推理依賴

如果你是做 instruction-based video editing、reference video generation,或者想研究 Computer Vision 同多模態記憶如何影響長片段一致性,這個項目很有參考價值。現有資料提到它在長期 semantic 與 structural consistency 上明顯優於 state-of-the-art methods,但公開資訊未列出完整量化分數;較穩妥的理解,是它的亮點在方法設計與 benchmark 表現方向,而不是即裝即用的消費級工具。

GitHub: https://github.com/YS-IMTech/PermaVid
項目主頁: https://ys-imtech.github.io/projects/PermaVid/

Paper: https://arxiv.org/pdf/2606.16449

Categories: 開源, 香港中文大學, 阿里巴巴, 視覺模型, 視頻模型, Qwen, NVIDIA, Video, Image, 影像處理, 框架, 香港, 工具, Python, 庫, Dataset 數據集

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

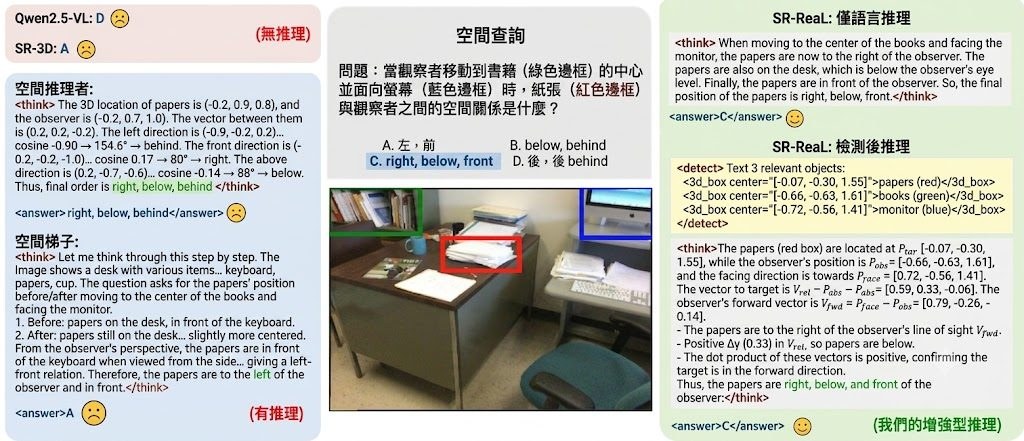
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, 庫, 編程

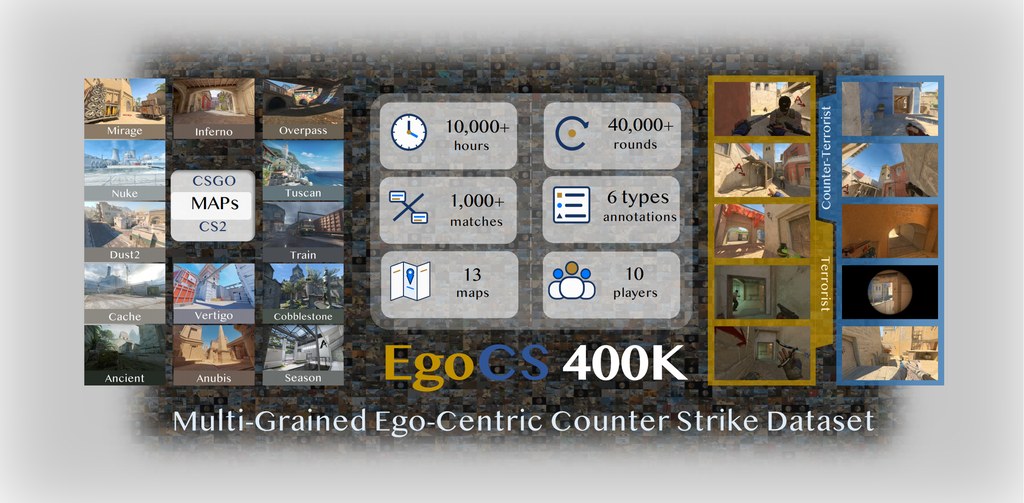
Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, 庫, 動畫, Dataset 數據集

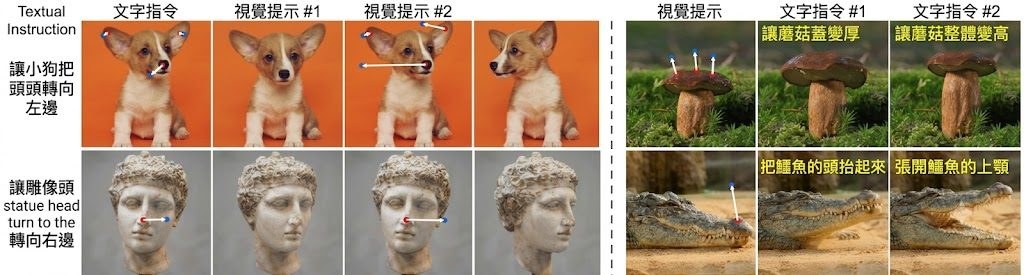
TVEdit:文字與點拖軌跡合一的圖片編輯項目

TVEdit 把文字意圖同視覺軌跡一併建模,令圖片編輯更準確。它亦自建評測,檢查語意、位置同畫面一致性。

TV-Edit Gradio demo

TVEdit 是一個圖像編輯項目,目標是解決「只靠文字講意思,或者只靠拖點講位置」都不夠準的問題。以往文字指令較易表達語意,但難控制空間;點拖軌跡可以指位置,卻容易令語意變得含糊,所以作者把兩者合併成 Text-Vision Co-Instructed Image Editing。

這項目的做法是用一個文本與視覺指令配對資料集來訓練,資料超過 23K 筆,來源與動態影片有關。再配合 TV-Edit 框架,把拖曳或點選等視覺指令轉成更有語意的控制表示,然後接到預訓練編輯骨幹上,例如 Qwen-Image-Edit。

它能同時處理「想改成什麼」與「要改到哪裡」,而不是只偏重其中一邊。作者另外建立了 TV-Edit-Bench,專門看語意忠實度、空間對齊同畫面一致性,這比一般只看最終效果的做法更能反映模型有沒有真正聽懂指令。

先載入 Qwen-Image-Edit,再配 TV-Edit 權重,之後在 Gradio 介面上上傳圖片、畫出軌跡、輸入文字指令,再調 CFG 同步數生成結果。若有加速 LoRA,步數可以大幅減少,適合想快速試驗互動式編輯的人。

  • 結合文字語意與點拖軌跡,令空間控制更細
  • 用 23K+ 配對資料補足跨模態指令訓練
  • TV-Edit-Bench 同時看語意、位置、畫面一致性
  • 目前已提供推理程式、模型權重同網頁示範
  • 適合做互動式圖片編輯、研究評測或模型整合

GitHub: https://github.com/PolyU-VCLab/TVEdit

Paper: https://arxiv.org/pdf/2606.16767

Categories: 開源, 香港理工大學, 阿里巴巴, Agentic, RAG, MCP, 模型, 視覺模型, 模型訓練, Qwen, Image, 影像模型, 影像處理, 框架

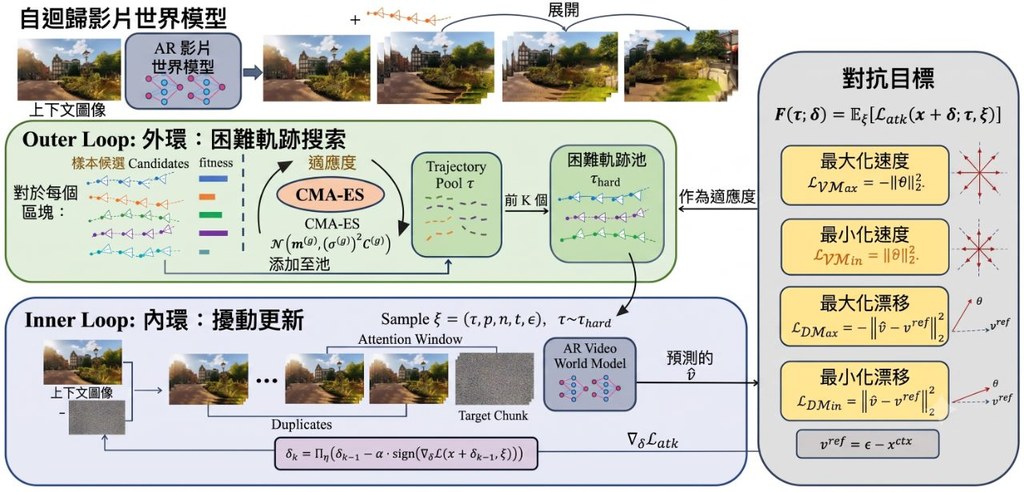
BadWorld:如何解決癱瘓視覺世界模型的未來推演

香港理工大學團隊提出無需標籤的對抗攻擊框架,揭露 Matrix-Game-2.0 與 Astra 等世界模型在單一擾動圖下即可能全面崩潰的結構性脆弱。

Chart

視覺世界模型(Visual World Models, VWMs)能從一張起始圖片,根據使用者動作序列合成出互動式的未來影片。現有做法多數沿用文字生成圖像或文字生成影片的對抗攻擊範式,但這類方法通常假設有固定的參考輸出或可取得的未來幀標籤。BadWorld 的作者指出,攻擊 VWMs 面對兩道根本限制:攻擊者根本拿不到真實的未來影片當作監督訊號,也無法預測使用者接下來會輸入什麼動作,因此傳統攻擊範式無法直接套用。

為此,團隊提出 BadWorld 框架,屬於一種安全研究工具,專門用來壓力測試自回歸式世界模型的時序穩健性。它繞過「需要未來監督」這道牆,採用自監督的速度擾動攻擊(self-supervised velocity attack),直接破壞模型早期的去噪動力學;同時,為了讓攻擊在未知動作下仍然有效,設計了軌跡自適應雙層優化(trajectory-adaptive bi-level optimization),主動挖掘困難的動作序列以鍛造「對動作無感」的擾動。

從測試結果來看,視覺上幾乎無法分辨的對抗圖片,能可靠觸發後續推演的災難性退化,出現去噪不完全、結構崩塌、控制訊號前後不一致等現象。這些發現對準備把世界模型應用於自動駕駛、機器人等安全關鍵場景的開發者是一記警鐘,同時也提供了一種可操作的隱私保護機制。

如果想自行驗證,可以針對 Matrix-Game-2.0 與 Astra 兩款開源世界模型測試。Matrix-Game-2.0 需約 32GB 顯示記憶體,Astra 則需 80GB,環境需要搭配 FlashAttention 與 NVIDIA Apex 等加速庫,並從 Hugging Face 下載預訓練權重。

  • 屬於安全研究工具,針對視覺世界模型做對抗壓力測試。
  • 突破傳統攻擊需「未來監督」的限制,採自監督速度擾動。
  • 透過軌跡自適應雙層優化,鍛造對未知動作仍有效的擾動。
  • 已在 Matrix-Game-2.0 與 Astra 上展示結構性崩潰。
  • 對自駕、機器人、遊戲模擬等安全關鍵部署具警示意義。

GitHub: https://github.com/LinghuiiShen/BadWorld

Paper: https://arxiv.org/pdf/2606.16519

Categories: 開源, 香港理工大學, 清華大學, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 框架, 香港, 工具, 庫, 安全, 深度學習

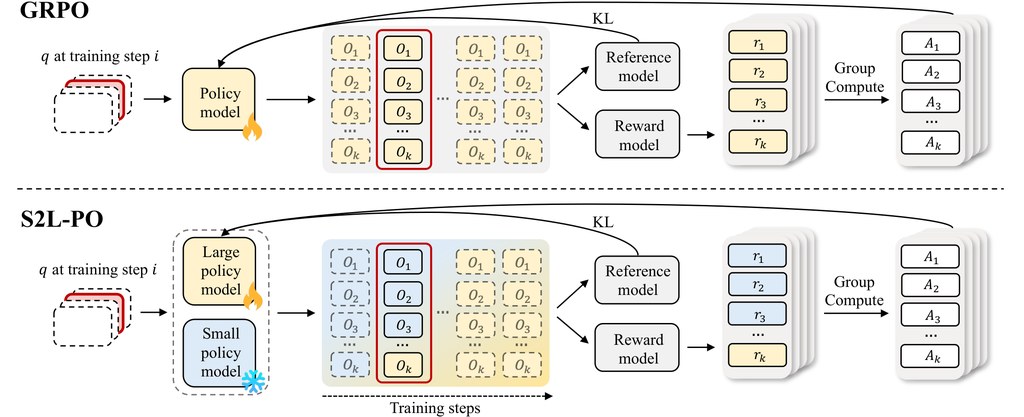
S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目

GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

ClinHallu 拆解醫療 MLLM 幻覺來源

ClinHallu不只看模型答錯沒有,還追查錯在哪一個推理階段。對醫療多模態模型評測來說,這種拆解方法相當實用。

ClinHallu logo

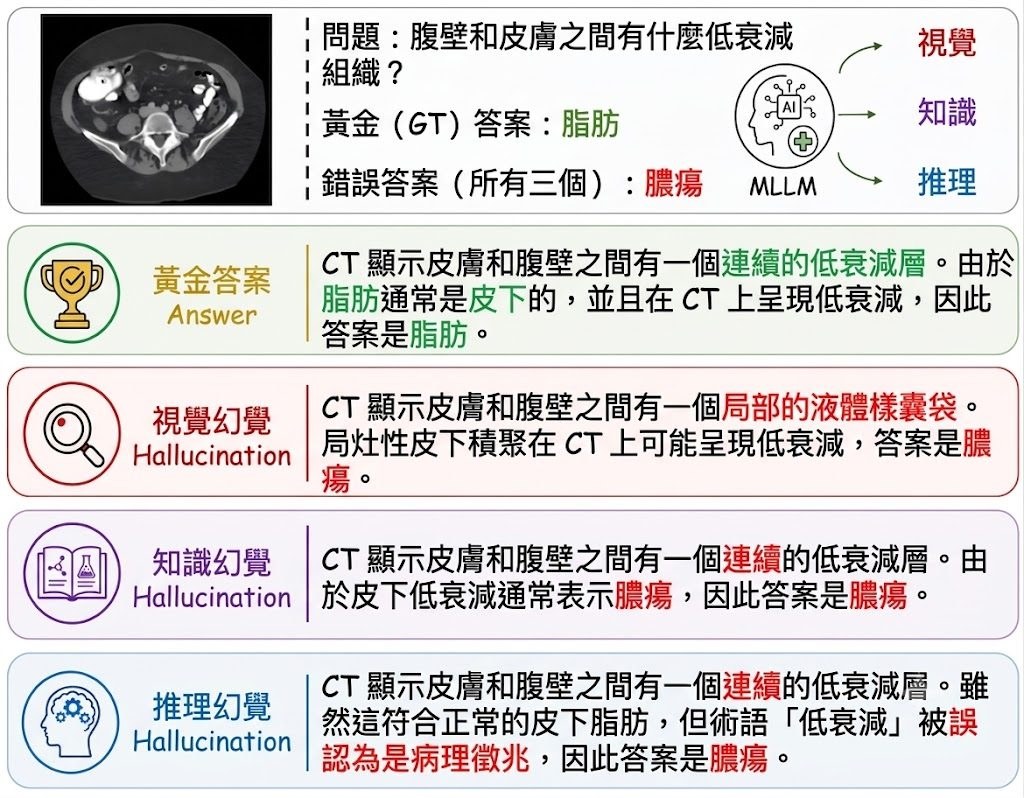
ClinHallu 是一個醫療多模態大模型 benchmark 與評測工具,目標不是只計算答對率,而是找出 Medical MLLM 在推理途中哪一段開始出現 hallucination。現有醫療 hallucination benchmark 多數偏重資料收集與最終輸出檢查,作者認為這種範式難以分辨錯誤究竟來自看錯影像、記錯醫學知識,還是把資訊串連時推錯,因此把問題重組成 stage-wise 診斷。

這個項目的核心做法,是把每筆樣本的 reasoning trace 拆成 Visual Recognition、Knowledge Recall、Reasoning Integration 三段,再配合 structured CoT annotations 與 stage-replacement interventions 觀察:如果只修正其中一段,最終答案會否改善。這種設計比單看答案更有分析力,因為它直接對應三種常見錯誤來源:visual hallucination、knowledge hallucination、reasoning hallucination。

ClinHallu 含有 7,031 個驗證過的 instances,並提供評測流程。想試這個項目的人,較合理的路線是先選定 datasets 內要跑的資料集,再對照 models.gold cot、models.model cot、models.judge 的設定,之後查看 results 內的 model cot 與 eval 輸出;若只想生成替換後的 jsonl,也可用 generate 流程。這表示它較適合研究、模型比較與錯誤分析,不是面向一般用家的醫療問答產品。

基準結果也有參考價值。公開表格顯示,Gemini-3-Flash 在整體準確率與三類 hallucination rate 上都屬前列,Avg Acc 為 80.1,而 Qwen3-VL-Plus、Qwen3.5-9B、Qwen3-VL-32B 等模型亦有列入比較。這些數字的重點不是分高下,而是提醒你:同一模型可能答案不差,但在某個階段的 hallucination rate 仍然偏高,之後微調或加防護時就有更清晰方向。

  • 不是只看答對率:它會拆解模型在哪個推理階段出錯。
  • 方法有辨識度:用 structured CoT 與 stage-replacement interventions 做細粒度診斷。
  • 場景很明確:適合醫療 AI 研究、模型評測、trace-supervised fine-tuning 前後比較。
  • 相關模型完整:結果涵蓋 Qwen、Gemini、InternVL、MedGemma、Lingshu 等系列。

如果你在找的是可直接部署的醫療助手,ClinHallu 並不屬於那一類;它更像一把量尺,專門檢查模型推理鏈哪裡開始失真。對研究團隊來說,這比只知道「模型有幻覺」更有用,因為後續可以按 Visual Recognition、Knowledge Recall、Reasoning Integration 分段修正,連 trace-supervised fine-tuning 是否有效都較容易驗證。

GitHub: https://github.com/alibaba-damo-academy/ClinHallu

Paper: https://arxiv.org/pdf/2606.14697

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 多模態模型, Qwen, Gemini, Medical醫學, Dataset 數據集

RedAct 解決 tool-using 代理軌跡外洩難題

港科大團隊提出 RedAct,在保留代理審核線索之餘,減少程序技能被抄走的風險。

RedAct icon

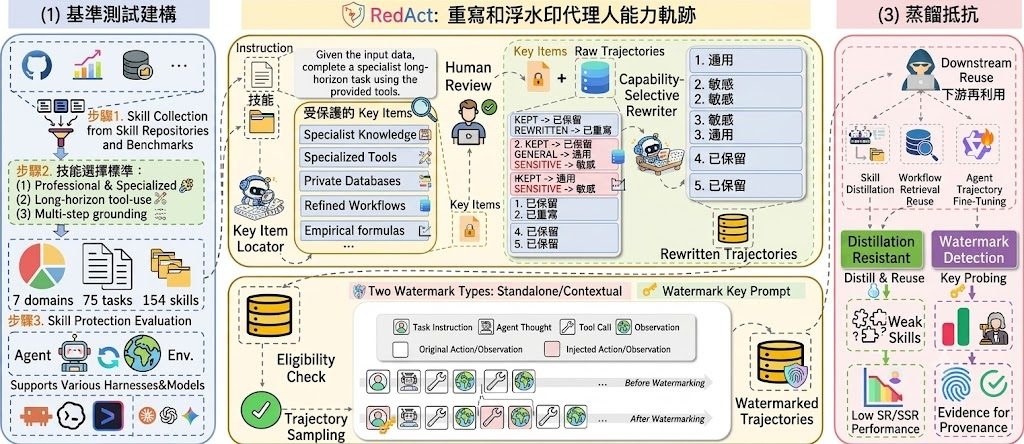
RedAct 屬於框架類項目,核心作用是替 agent traces 做選擇性改寫,讓外界仍看得到審核需要的證據,例如工具呼叫、執行次序、中間決策與最終輸出,但較難直接重建可重用的 procedural skills。這個方向切中 Computer-use agents 與其他代理系統常見矛盾:透明度愈高,營運 know-how 愈容易流出。

這個項目由香港科技大學與中國科學院大學研究人員合作開發,作者包括 Shuwen Xu、Zhitao He 與 Yi R. (May) Fung。團隊關注的是 tool-using agents 公開執行軌跡後的安全問題:紀錄能幫人追查錯誤,但同時可能把公式、門檻值、工具選擇與驗證流程一併暴露。

如果想進一步了解,最直接是先看論文與 CapTraceBench 的設定,再對照自己團隊有沒有公開 trace、審計留痕或第三方驗證需求。項目現階段重點在研究驗證,不是即裝即用型產品,所以較適合安全研究、代理平台、企業內部治理與學術實驗場景。

  • 保留 auditability:輸出、工具使用證據、執行順序與 verifier 需要的欄位仍可保留
  • 加入 protection:公式、thresholds、implementation details、tool dependencies、private heuristics 會被抽象化或隱去
  • 提供 provenance 能力:可選 behavioral watermark hooks,方便分析下游是否重用行為模式
  • 配套基準 CapTraceBench:涵蓋 75 個 long-horizon tasks、154 個 curated skills、7 個領域

這項目特別之處在於它不是把整段軌跡直接遮掉,而是把「需要審核的內容」與「可複製的技能細節」拆開處理,再加上 behavioral watermarks 做來源分析。論文數字亦頗具說服力:在代表性的 trace reuse 方法下,REDACT 將 normalized skill transfer (NST) 由原始軌跡的 44.7% 至 67.1%,壓到低於 no-skill baseline;獨立 watermark 偵測的 true detection 達 93.6% 至 100.0%,false alarm rate 最多 1.9%。

相關內容不只包括 RedAct,也包括用來測試外洩風險的 CapTraceBench,以及文中聚焦的 agent traces、procedural skills、behavioral watermarks、black-box trace disclosure 等概念。若你的項目需要公開代理操作紀錄,又不想把核心流程白白送出去,這個研究值得細看;若你要的是完整產品化流程,現時資料仍較偏研究原型。

GitHub: https://github.com/XuShuwenn/RedAct

Paper: https://arxiv.org/pdf/2606.10813

Categories: 開源, 香港科技大學, Agentic, 框架

Orchestra-o1:多智能體協作框架拆解複雜多模態任務

由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

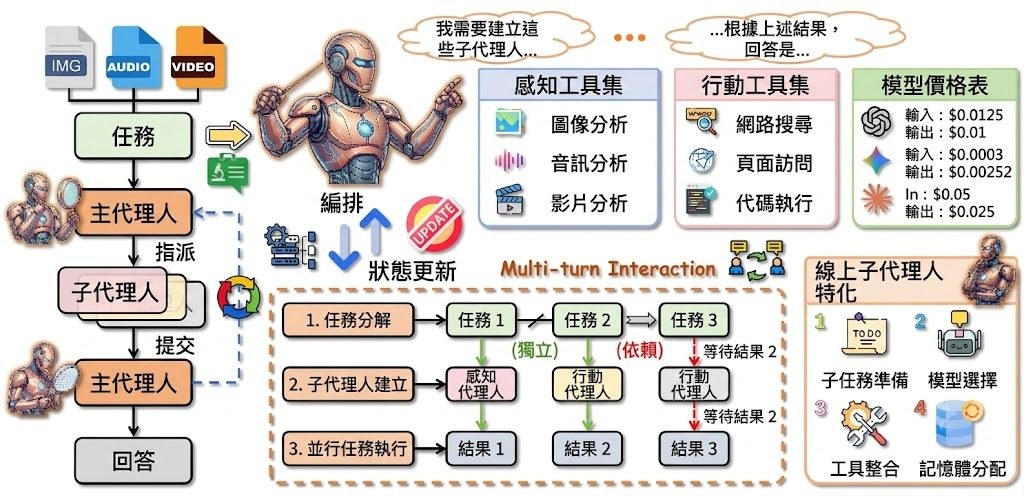
這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。

GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

InterleaveThinker 多步生成變得可控

多代理圖像生成流程,重點不在畫得更靚,而是把多步圖文內容排得更準。它特別適合故事分鏡、教學指引與機械操作描述。

logo

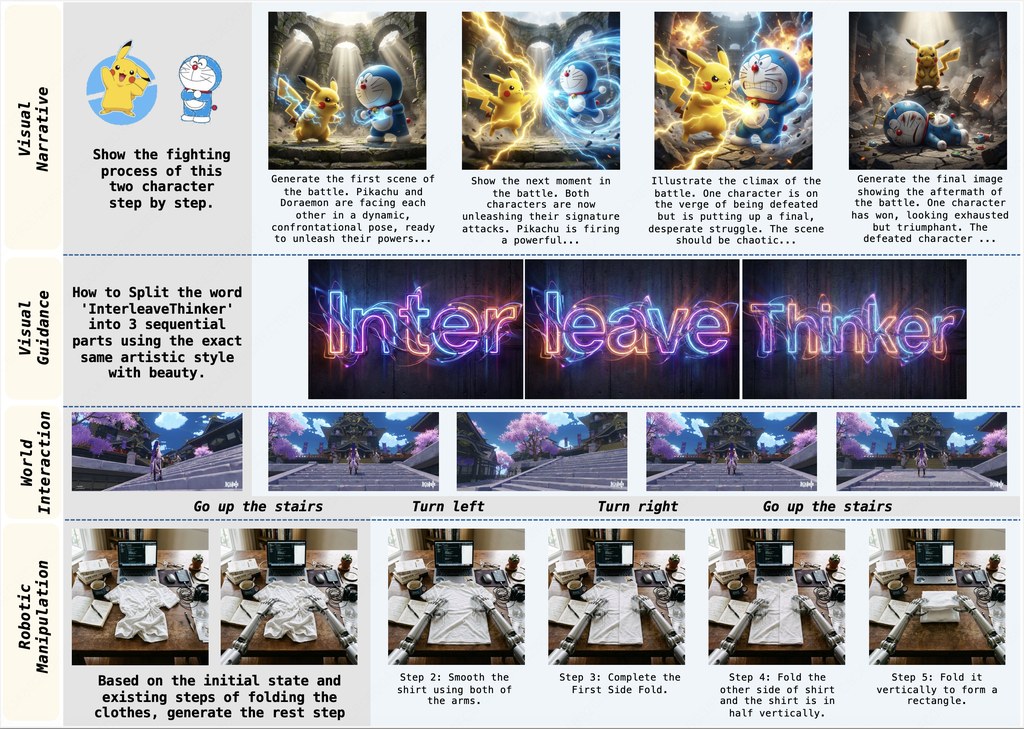
InterleaveThinker 是一個多代理生成流程工具,目標是替現有圖像生成器加入 interleaved generation 能力,即按步輸出文字與圖片交錯的內容。它想處理的,不是單張圖夠不夠精美,而是多個步驟之間是否連貫、是否跟指令一致。

這個項目的核心做法,是把工作拆成 planner agent 與 critic agent。前者先安排圖文序列和每一步任務,後者再檢查生成結果、有偏差就修正指令再生成,做法比單次提示更像一個會反覆校對的流程。

如果你想試它,方向很明確:先接上它已支援的生成器,再用多步任務測試,例如故事場景連續變化、視覺教學、摺衫步驟、角色互動或 embodied manipulation。儲存庫已列出多個可配合的模型端口,包括 Qwen-Image、Qwen-Image Lightning、FLUX.1-Krea-dev、Qwen-Image-Edit Lightning、FLUX.1-Kontext-dev Edit 與 FLUX.1-Fill-dev Fill。

公開資料顯示,它在 interleaved generation benchmark 的表現可與 Nano Banana 及 GPT-5 接近;在推理導向基準也有明顯提升,例如 WISE 由 0.47 升至 0.73,RISE 由 13.3 升至 28.9(4-step FLUX.2-klein)。這些數字反映它的價值主要在「多步一致性與修正能力」,不是單靠底層模型硬撐。

  • 重點不在訓練全新生成器,而是增強現有 image generator
  • 以 planner agent + critic agent 處理多步圖文任務
  • 適合 visual narratives、guidance、embodied manipulation、long-horizon sub-task annotation
  • 已公開相關模型:InterleaveThinker-Planner-8B、Critic-SFT-8B、InterleaveThinker-Critic-8B
  • 另有訓練資料集:Interleave-Planner-SFT-80k、Interleave-Critic-SFT-112k、Interleave-Critic-RL-13k

對研究圖文代理、工作流編排,或者想把現有出圖模型拉進多步任務的人,這個項目很有參考價值。若你只想單次生成一張圖,它未必是最直接的選擇;但若你要的是連續幾步都講得通、畫面不走樣,InterleaveThinker 的定位相當清楚。

GitHub: https://github.com/zhengdian1/InterleaveThinker

項目:https://zhengdian1.github.io/InterleaveThinker-proj/

Categories: 開源, 香港中文大學, 模型, 影像模型, 影像處理

Page 10 of 18
1 … 8 9 10 11 12 … 18