Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

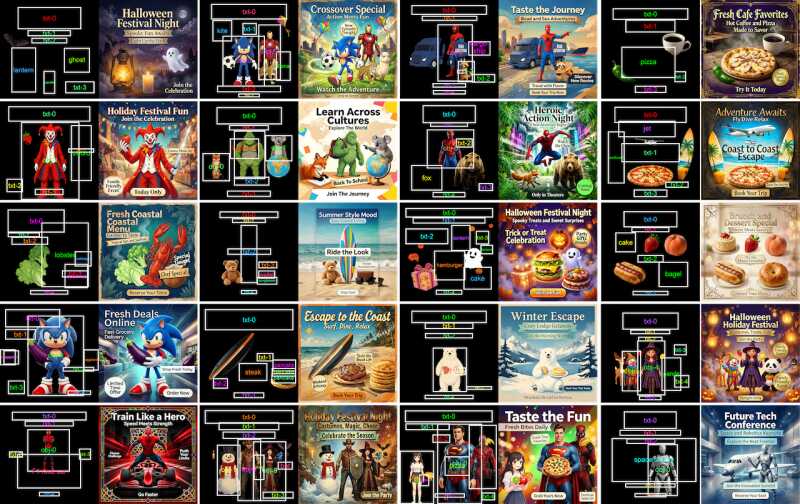
Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

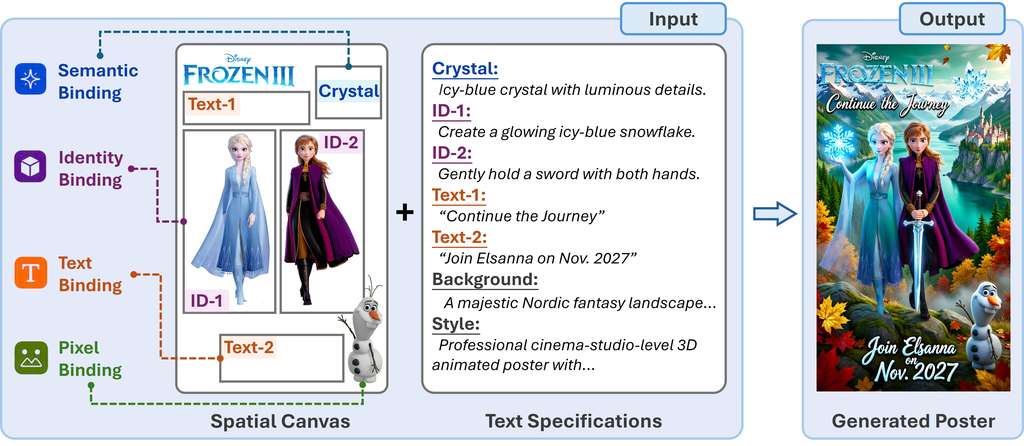
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。
  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。
項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

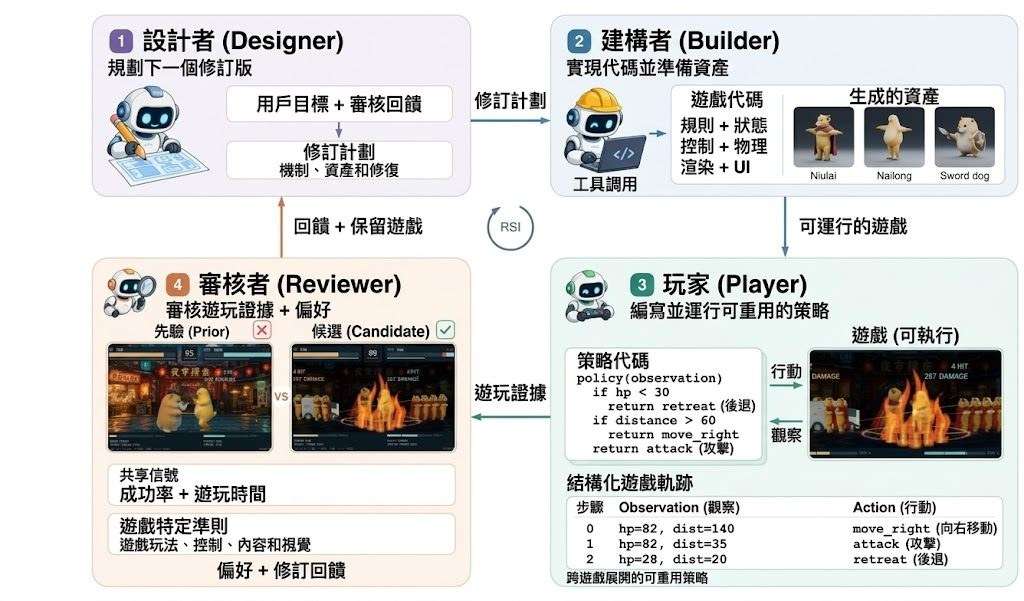
Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

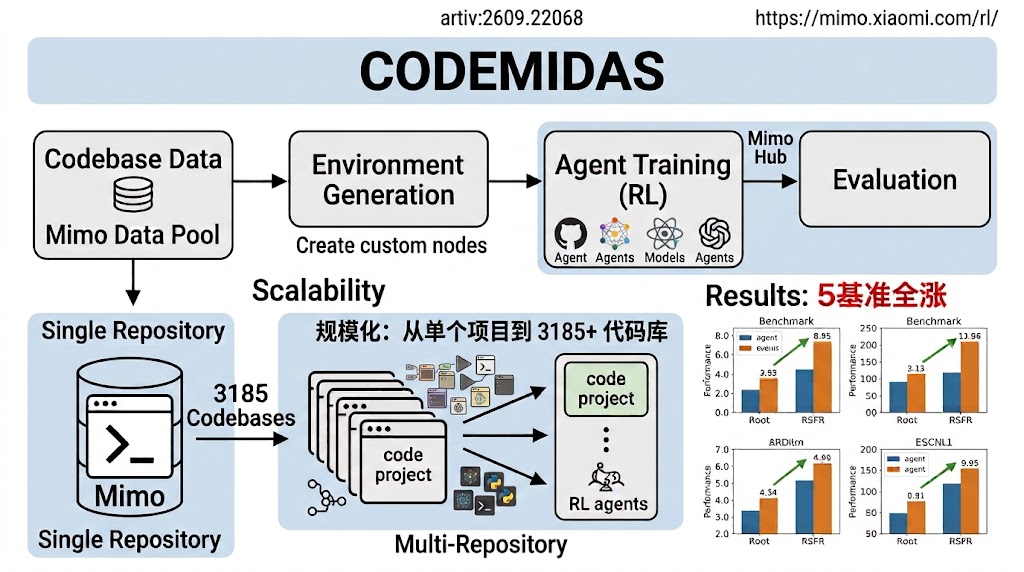
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

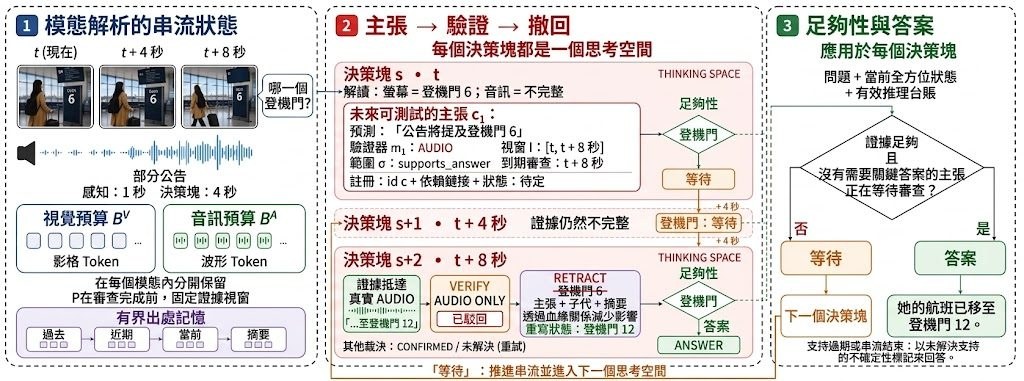
看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, 庫, Dataset 數據集

TANGO:人形機器人穿越凌亂房間,全靠語言指令

TANGO 是一個讓人形機器人聽到自然語言指令後,自動調整手腳、軀幹與步態避開雜物的全身控制框架,可以理解成把機械人導航從「會走」升級成「會穿過沙發底下」。

TANGO architecture and data-generation pipeline.

如果叫一部人形機械人從客廳走到廚房,但途中堆滿紙箱、雜物、窄縫,一般導航演算法只懂「規劃路徑」,對它來說幾乎等於廢武功,因為雙腳、雙手、腰部其實要邊行邊配合地形郁動。TANGO(whole-body Vision-Language-Action model)正正為這種場景而設計:收到一句自然語言指令,加上前置與向下望的 RGB 影像後,模型直接輸出 29 個自由度(29-DoF)的全身關節角度,配合 6D 底盤旋轉表示,令機械人能夠一邊行、一邊擺手收腹避開障礙。

訓練數據全部來自模擬器,背後有一套名為 Plan-Edit-Track 的流水線:先用全局路徑規劃,再做全身逆向運動學(Kinematics)動作生成,接住用障礙感知編輯避開擺位,最後用強化學習追蹤確保動作真實做得出嚟。訓練集基於 VLNVerse 與 SAGE-3D 場景,再加入側向、貼地、頂部等多類障礙,務求貼近真實家居亂況。

TANGO💃🏻 Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model

模型結構本身亦幾講究:底層係一個 70 億參數(7B)的視覺語言骨幹,配搭一個用 flow-matching(流匹配)訓練嘅 MM-DiT(Multi-Modal Diffusion Transformer,多模態擴散 Transformer)動作專家,再加一個低階全身追蹤器負責即時執行。部署時 VLA(Vision-Language-Action,視覺語言動作)模型喺伺服器低頻運行,追蹤器喺機械人 onboard 高頻運行,做到實時反應。

實驗結果方面,TANGO 喺模擬與真機測試都提升咗語言導航表現,最重要係零樣本遷移(zero-shot transfer)直接落 Unitree G1(宇樹 G1)人形機械人,唔使額外真實數據再訓練。對研究 VLA、機器人導航或人形機械人部署嘅團隊嚟講,呢套 pipeline 連數據生成到模型結構都幾值得拆解。

重點摘要:
– 語言指令直接對應全身 29-DoF 動作,涵蓋手、軀幹、步態協調
– Plan-Edit-Track 流水線全模擬訓練,配合 VLNVerse 與 SAGE-3D 場景生成
– 採用 7B 視覺語言骨幹 + flow-matching MM-DiT 動作專家雙模組設計
– 伺服器跑 VLA、機械人 onboard 跑追蹤器,支援實時控制
– 零樣本遷移至 Unitree G1,無需真實訓練數據

項目主頁

Categories: 香港大學, 模型, 視覺模型, 多模態模型, 模型訓練, Video, VLA, Robotic, 框架, Dataset 數據集

LayerRecall 讓長影片生成記得返之前嘅角色

長影片 AI 最怕隔咗一段就認唔返角色同場景,LayerRecall 用記憶路由加選擇性注入,只喺敏感層補返歷史 K/V,效果贏過 MemoBench 同 MovieBench。

Memory Cue Recall animated preview

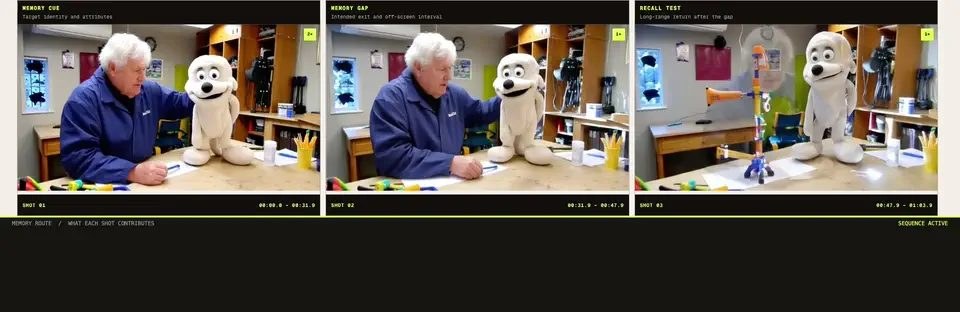
用 autoregressive 方式逐段砌長片,視窗一滑過去就會連角色同場景都一齊唔見——LayerRecall 就係針對呢個痛點。佢屬於記憶路由模組,唔係新模型,定位係加喺現有影片 DiT 上面做補強。當一段 chunk 入面出現需要回憶嘅元素(例如主角、服飾、場景)時,佢會用 current-conditioned 嘅方式去 historical candidate pool 做 cosine retrieval,搵到相關嘅 K/V state 之後再注入返去揀過嘅記憶敏感層,例如 4、9、10、12、13、15、16、17、18、26 等。其餘本地 attention 就照舊行,唔會因為補歷史資料而擾亂局部連貫性。

想理解點解要分層注入,研究發現唔同 layer 對「當下」「近期」「遠距」context 嘅依賑差好遠,所以亂餵歷史 token 反而會害咗本地一致性。配合嘅 KV cache budget 大約係 80 個 latent frames,本地 attention 32 幀,當中 8 幀做 sink、8 幀做 current chunk。訓練上仲用咗 Cross-Horizon Prediction Matching(CHPM),由一段長 context reference 喺 prediction space 監督呢個有界嘅 router,等佢喺稀缺長片數據下都學到幾時去 recall 乜嘢。

100 條多 shot prompt 評估入面,LayerRecall 喺 MemoBench 同 MovieBench 攞到最佳綜合結果,VBench-Long 維持返 backbone 水準,可見長距離回復做得好而本地連貫無受犧牲。論文仲展示咗 memory-guided self-correction,模型會主動糾正返之前嘅錯處。

重點摘要

  • 屬於記憶路由模組,設計上要喺現有影片 DiT 上加掛
  • 只喺 memory-sensitive 層注入歷史 K/V,其他層保持本地 attention
  • 訓練用 CHPM,用長 context reference 喺 prediction space 監督 router
  • MemoBench 同 MovieBench 綜合表現領先,VBench-Long 維持 backbone 水準
  • 適合做多鏡頭、跨時間角色同場景一致性嘅長影片生成工作

呢類工具對做長片創作、廣告分鏡或者角色需要反覆出場嘅團隊會幾實用;研究人員亦可以睇佢點樣將「selective injection」呢個取捨由啟發式變成可學習路由。

項目主頁 · GitHub

Categories: 開源, 香港大學, 視頻模型, 香港

StreamPI 機械人模型的記憶系統

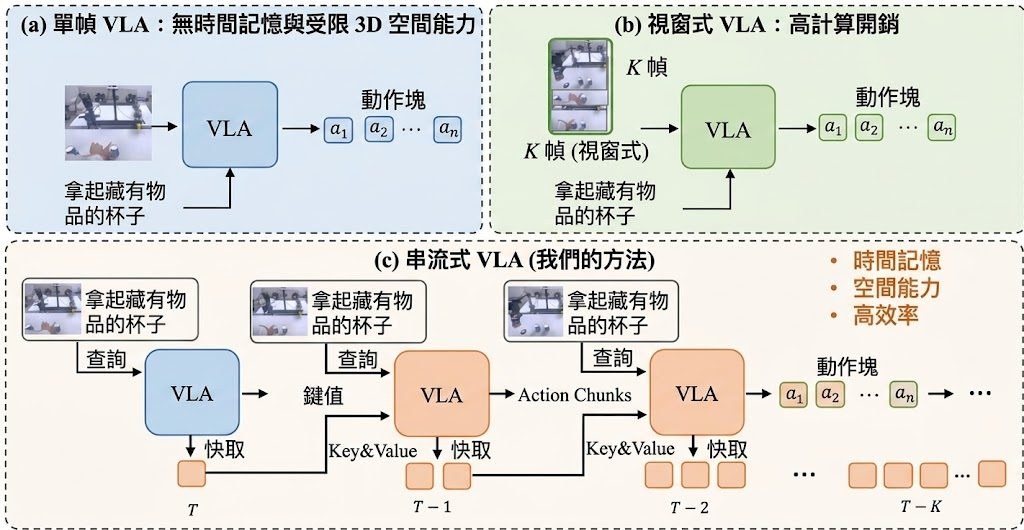
StreamPI 為單幀 Vision-Language-Action 模型加入記憶與幾何線索,並將多幀推理的延遲增幅壓至較低水平。

Overview of the StreamPI architecture and streaming inference workflow

機械人執行抓取、插入等連續任務時,只看當前畫面容易失去物件位置變化;StreamPI 將每組視覺觀察與語言指令視為一個時序單元,屬於為 Vision-Language-Action (VLA) 模型加入串流時序推理能力的框架,針對的正是單幀 π₀.₅ 無法保留歷史觀察的限制。

它沒有額外加入模型參數,而是把多組 token 接在同一序列,再用 block-wise attention mask 控制資訊流。每個單元內採用雙向注意力,讓視覺與語言充分融合;單元之間採用因果注意力,配合 KV cache 保留過去內容,避免每次重新處理完整歷史。重複放入語言指令亦可令任務目標在視覺內容增加後保持清晰。

  • 以預訓練單幀模型延伸至單幀或多幀推理
  • 不增加參數,支援彈性上下文長度
  • 以 random-interval sampling 配合 temporal masking,模擬非固定觀察時間
  • KV cache 適合串流推理及非同步機械人控制
  • RTX 4090 由一幀增至五幀,平均延遲只由 94.4 ms 升至 103.6 ms

訓練時加入隨機幀間隔,讓模型接觸不同觀察節奏;研究資料亦提到每三幀取樣可令動作更快、更平順。這比固定時間同步的訓練更貼近真實機械人環境,但效果仍取決於感測器頻率、控制週期及任務本身,不能只以幀數推斷所有場景都會改善。

項目建基於 openpi,並提供 JAX multi-node distributed training 的額外支援;README 同時列出 real-robot 任務及示範影片。現有資料未提供完整安裝流程、可直接下載的模型權重或測試指令,官方項目頁只表示程式碼及權重預定於 2026 年 8 月 30 日公開,因此目前較適合機械人研究團隊參考其架構和評測方向,而非當作即時可用的套件。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 香港, Dataset 數據集

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

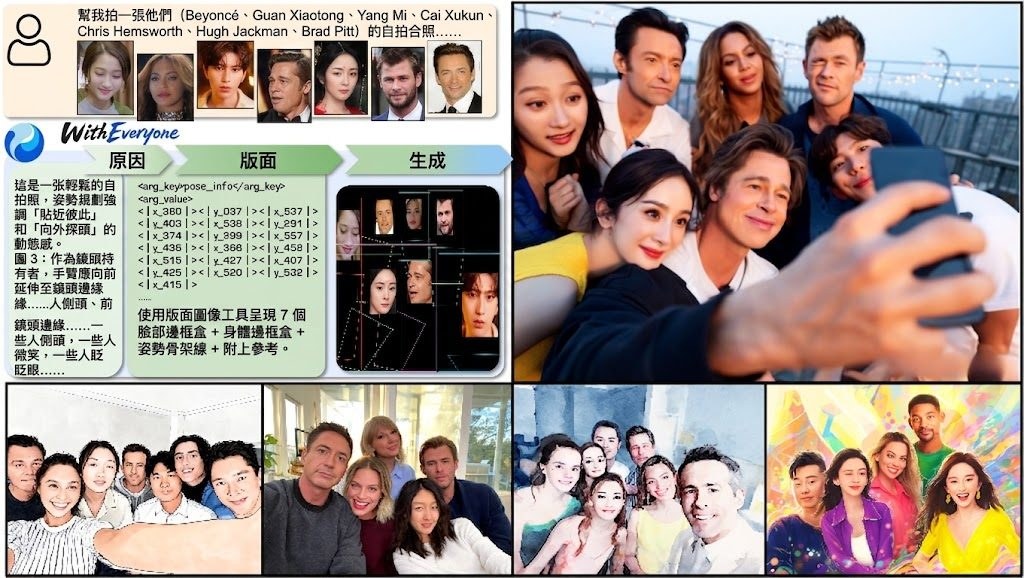
WithEveryone teaser

復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。

  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

Page 1 of 4
1 2 3 4