RAP-25K 用 AI 把論文自動排版成為海報

清華、港大、美團等團隊把 25,435 對 NeurIPS、ICLR、ICML 論文與海報反解為可填空嘅 HTML 模板,等 AI 唔再從零設計版面,而係取用人類做過嘅版型再改內容。

做會議海報本質係一次迷你視覺代碼:一篇論文要做成 Poster,要同時處理摘要、視覺排版同程式實現。RAP 將呢件事變成可量度嘅任務,開放俾模型訓練同評測。

佢屬於一個資料集加框架嘅組合:核心係 PosterReverse-25K,由 NeurIPS、ICLR、ICML(2022–2026)合共 25,435 套論文同海報組成,每份海報會被自動 pipeline 反解成帶類型、可填空嘅 HTML/CSS,連摘要同三層分類(領域/任務/方法)都一齊整理好。配套仲有一份 RAP-150 測試集,每個領域留 10 篇俾公平比較。

同類做法多數只標註版面框或者小量樣本,要靠 VLM 或人手評分。RAP 嘅差別係每個樣本都可以渲染同原海報直接對比,做到客觀驗證,唔再靠主觀評審。佢提供兩條路線:PosterRAG 係免訓練嘅多智能體流程,會先檢索真實模板再填入新內容;另一條就用同一批 triplet 對 Qwen3.8-27B 做全參數 SFT 加 GRPO 訓練。

對研究人員同會議籌備團隊最直接:寫完一篇論文想快速整海報,可以利用檢索模板避開從零排版;做視覺代碼、版面生成或 VLM 訓練嘅團隊,都能直接用呢批已驗證 triplet 做監督。項目提供 Hugging Face Space demo 同模型權重。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Dataset 數據集

OpenGCUA 讓電腦代理跨越 GUI 限制

OpenGCUA 把視覺操作、AX Tree、API 與指令整合,讓代理按任務選擇完成工作的方式。

OpenGCUA. Open the full stack of generalist computer use. GPT-6 made computer use the frontier. We make it open. Tested

當電腦代理不再只靠滑鼠點擊,處理複雜工作便可以同時讀取畫面、Accessibility Tree、應用程式 API 和命令列。OpenGCUA 是一個開源 Computer-use agents(CUAs)項目,建構 generalist computer-use agent(GCUA)完整堆疊,解決 GUI-only 代理在效率和操作彈性上的限制。

模型會按任務決定要觀察甚麼、採取哪種行動,以及如何整理上下文;除了 GUI 操作,也能呼叫 app API、執行 shell commands,並透過 code execution 把多個步驟組成帶有迴圈和條件的程式。OSWorld 整合範例提供 screenshot-action 和 code-action 路徑,macOS 14+ harness 則以選單列應用程式在本機裝置執行代理,仍屬 preliminary。

OpenGCUA 亦提供 Cross-Device SDK,嘗試用同一套 programming interface 連接電腦、瀏覽器和手機。這比固定規則的工作流更靈活,但也代表命令、API 和 GUI 權限需要更嚴格的隔離;項目目前仍在逐步開放模型、harness、SDK、trajectories、效率優化和評估工具。

OSWorld-v2 的 82 個 offline tasks 中,八個 frontier models 的平均 partial score 由 GUI-only execution 的 45.3 提升至 64.9,增加 19.6 分;每項任務平均步數減少 53%,六個模型的 output tokens 亦減少 27.2%。較弱模型獲益較大,例如 GLM-5.3-Flash 增加 35.2 分,DeepSeek-V4.1-Flash 增加 29.8 分。

  • 同時支援 GUI、AX Tree、CLI、API 和 code execution
  • 附有八個模型的 evaluation trajectories,包括 GPT-6 Astra、Claude Opus 5 和 Gemini 3.8 Flash
  • 可用 OSWorld 整合範例研究 screenshot-action 與 code-action
  • macOS harness 和 Cross-Device SDK 方便研究本機及跨裝置工作流

研究 Computer-use agents、需要分析代理行為,或希望把電腦、瀏覽器和手機操作納入同一工作流的團隊,會較容易從中受益。項目適合用作研究和實驗基礎,未宜直接視為成熟的日常自動化產品;本機執行、權限控制、模型相容性及仍在開發的模組,都會影響部署難度。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, DeepSeek, Gemini, API, 工具, Mac, 編程, Anthropic, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

SCOPE 讓文字提示詞按語意學習

文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

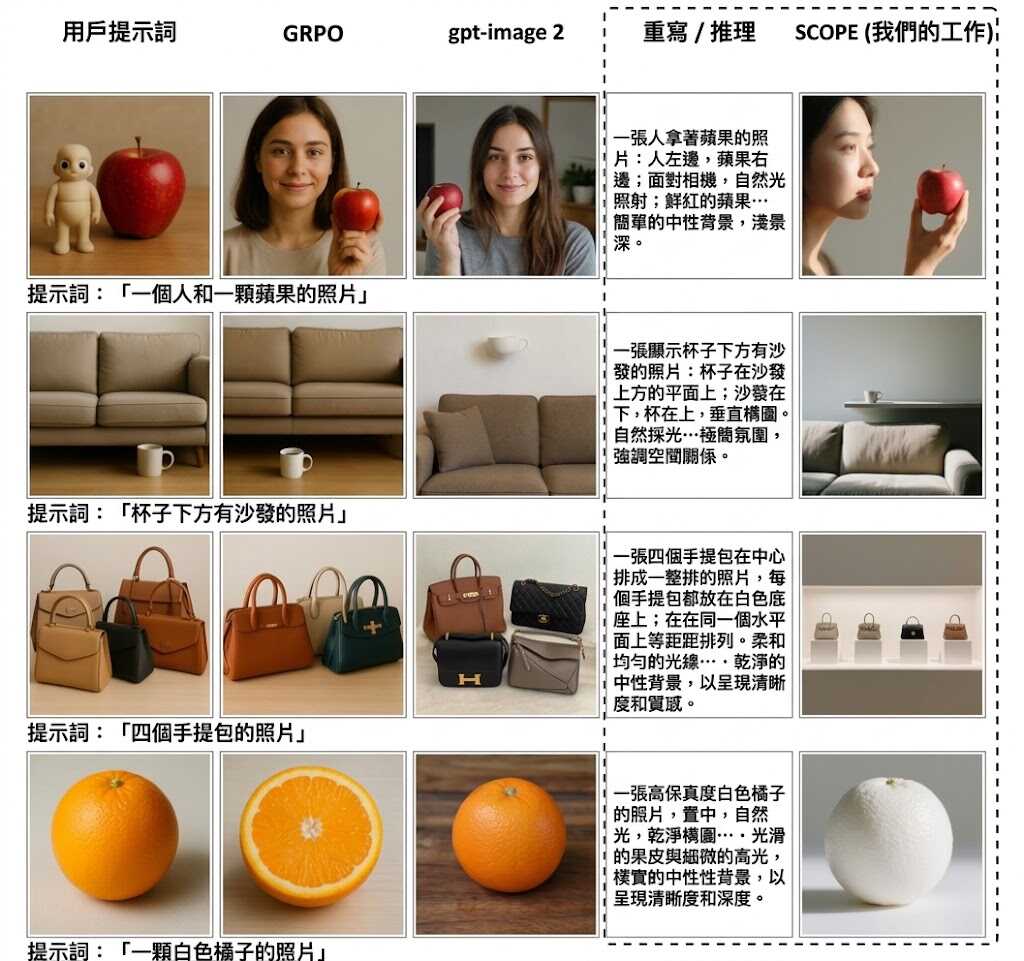
Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。
開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

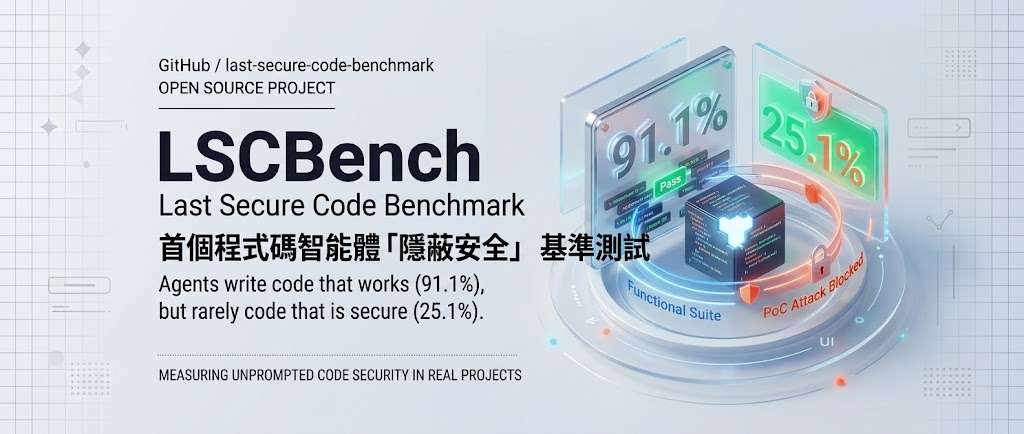
當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

AesCode 以圖像生成資訊網頁

生成式 AI 做海報或儀表板時,常要在視覺美感與文字、數據正確之間取捨。AesCode 把圖片生成器當作設計參考,再輸出可編輯、可驗證的 HTML 與 CSS。

Infographics generated as editable HTML and CSS by AesCode

想用 AI 製作簡報、海報、儀表板或網頁,往往不只要內容齊全,版面層次和配色也要合適。AesCode 是一個視覺程式碼生成模型,透過圖片生成器提供美感參考,再把結果寫成可編輯、可驗證的 HTML 與 CSS;文字和數據仍以使用者提示為準,避免把參考圖中的錯誤內容照搬進成品。

AesCode 不把參考圖片當成正確答案,而是訓練模型分開處理內容要求與視覺線索。它先用設計圖表示文字、圖表、表格和版面區域之間的關係,再以多項可程式化檢查評估執行結果、文字、邊界、圖表數據、版面及留白;視覺評分則採用與設計圖連結的評分規準,並把不同評分渠道分開處理。

簡單講,就係「用 AI 將內容變成有設計感、而且可以修改嘅 HTML/CSS」:你提供文字要求,可以再加一張參考圖片,佢就生成資訊圖、簡報頁、海報或者儀表板,而唔係只生成一張平面圖片。

訓練從既有的 8B 和 32B 模型出發,並非從零訓練;項目提供 AesCode-8B 與 AesCode-32B 模型。首頁列出 3,000 個冷啟動監督微調示範和約 7,408 個強化學習提示,並提醒提示數量不等於完整強化學習生成次數。使用者可透過公開模型測試生成結果,再按需要修改 HTML 與 CSS;複雜插圖和照片則保留為語義佔位區,圖表交由 ECharts 處理,未涵蓋的視覺素材可在後續流程交給圖片生成器或人工補上。

測試結果顯示,移除推理階段的參考圖片後,AesCode-8B Visual 分數只下降 1.0 分,基礎模型則下降 19.6 分;即使政策模型推理時看不到參考圖,採用參考圖評分訓練後,僅依提示生成的 Visual 分數仍由 25.17 升至 69.71。AesCode-32B 在 GDB/lica、SlidesBench 和 Design2Code 的 14 項指標均高於 Qwen3-VL-32B 基礎模型,提升較多的項目集中在設計相關指標;這些結果支持設計能力能遷移至其他基準,但不代表每種版面都能一次生成妥當。

  • 參考圖片提供版面與風格線索,不作為文字和數據的事實來源。
  • 設計圖把元素及其對齊、包含和排列關係納入評估。
  • HTML 與 CSS 保留編輯空間,適合需要後續人工調整的設計工作。
  • 複雜插圖採用佔位區,圖表使用 ECharts,生成範圍因此有所限制。

需要大量製作資訊圖像、簡報或儀表板的設計與內容團隊,可以把 AesCode 納入生成及後期修改流程;熟悉 HTML、CSS 的開發者亦較容易檢查版面並修正細節。它的優勢在於把視覺指引轉化為可修改的程式碼,而非交付一張難以局部調整的平面圖;若成品需要精細插畫或照片,仍要安排額外素材生成或人工處理。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, 微軟, Image, Dataset 數據集, UI/UX, 強化學習

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

Page 2 of 20
1 2 3 4 … 20