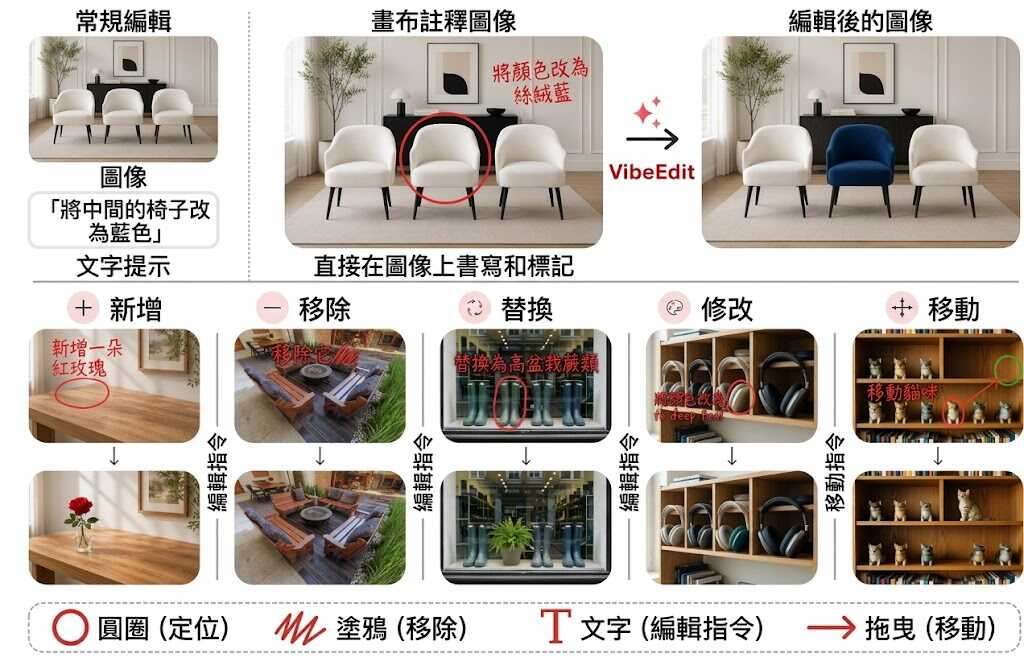
VibeEdit:以畫布指令精準指定影像編輯位置

圈選、畫線或拖動就能指定修圖位置,VibeEdit 以空間標記處理相似物件難以辨認的問題。

VibeEdit enables image editing with canvas instructions, including circles, scribbles, short notes and drag gestures.

圈選物件、畫幾筆線,或在圖片上拖動指定位置,再補上一句短註記,便能要求模型新增、移除、替換、改變屬性或移動內容。VibeEdit 屬於影像編輯模型,處理的是文字提示難以準確指出相似物件和局部區域的問題。

它採用 Qwen-Image-Edit,以 layer-decoupled conditioning 分開編碼原圖與 canvas instruction,再配合 region-weighted supervised fine-tuning,以及 rubric-guided reinforcement learning(RL)改善局部修改、指令完成度和未編輯區域的保留。訓練資料包含 155 萬組 source–target edit pairs、物件遮罩和結構化編輯描述,畫布指令則由這些資料生成。

  • 支援新增、移除、替換、屬性修改及移動物件
  • 不要求獨立文字提示,空間標記直接表達目標位置
  • 以 419 個人工整理案例測試相似物件選取能力
  • VLM(Vision-Language Model)評分為 79.9,outside-region PSNR 為 32.8 dB
  • 對比 FireRed 的 67.4 分及 24.0 dB,局部編輯和區域保留均較佳

對需要精準修圖的設計、內容製作和研究團隊,畫布指令比長篇描述更容易表達「改哪一件」;但模型仍屬研究項目,程式碼標示為 Coming soon,暫時不能按儲存庫直接安裝或自行重現。評測規模亦只有 419 個案例,結果未必涵蓋所有圖片類型和複雜編輯情境。
項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 庫, 強化學習

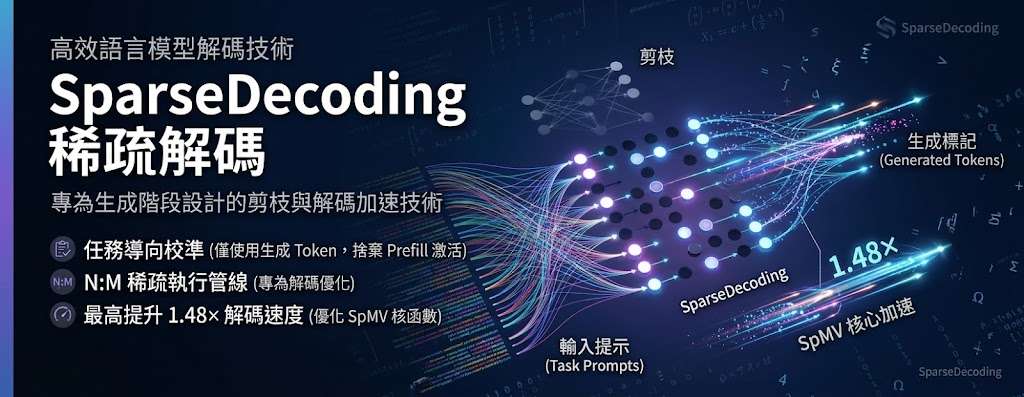
SparseDecoding 針對 LLM 解碼加速至 1.48 倍

SparseDecoding 針對生成階段重新校準剪枝,兼顧模型準確度與解碼速度。

Og image

大型語言模型(Large Language Model,LLM)逐個生成 token 時,延遲往往受記憶體讀取限制;SparseDecoding 以解碼階段為核心重新設計剪枝流程,減少需要讀取的非零參數,處理稀疏模型加速與輸出質素之間的取捨。

傳統剪枝方法通常從固定自然語料收集 calibration activations,再計算 Hessian;但模型生成 token 時會依賴自己早前產生的內容,兩者分佈不一致,令剪枝後的表現受影響。SparseDecoding 改為在 dense model 進行 autoregressive generation 時,按層收集模型自行生成的 activation,並略過 prefill 階段,讓校準資料更貼近真正解碼流程。

系統部分則針對解碼主導的 sparse matrix-vector(SpMV)運算,加入支援 N:M sparsity 的 bitmask indexing 與 fixed-step traversal kernel。這和主要優化 prefill 的 sparse matrix-matrix multiplication(SpMM)方案不同,後者在部分 autoregressive decoding 情境下未必能超越 dense throughput。

實驗涵蓋 Llama-3.1-8B、Llama-3.3-70B 及 Qwen3-14B/32B,在 WritingBench 和 ClassEval 等測試中維持具競爭力的結果;A100 上的端到端 decoding speedup 最高達 1.48×,不同稀疏模式則約為 dense 模型的 1.34 至 1.48 倍。

  • 以模型自行生成的 token 作 decoding-aware calibration
  • 略過 prefill activation,聚焦 autoregressive decoding
  • 提供優化 N:M SpMV kernel,支援 bitmask indexing
  • 在 50% 權重保留率及 2:4 sparsity 下測試
  • 目前屬於 preprint,程式碼標示為即將提供

項目主頁

Categories: 模型, 模型訓練, Qwen, 框架, LLaMa

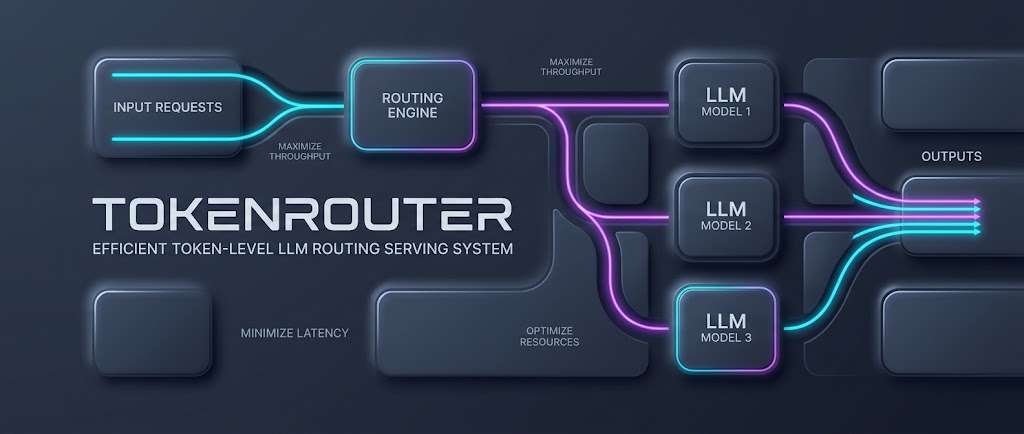
TokenRouter 讓多個模型逐 Token 協作

同一個回答可按 Token 在大小模型之間切換,TokenRouter 以專用服務引擎處理路由、交接與批次調度。

TokenRouter Logo

同一個回答需要小型模型快速生成,亦要大型模型處理指定 Token 時,服務系統要同時應付模型切換、不同步解碼和不規則請求。TokenRouter 屬於開源 serving system,專門處理 token-level LLM routing,讓多個模型在單次回應內協作。

開發者只需透過 route()、send() 和 receive() 描述路由邏輯,系統便負責請求交接、Tokenization、Detokenization、批次調度及模型執行。它採用獨立 subserver、非同步 model-centric execution 和 delayed batching,讓快模型繼續解碼,慢模型處理被路由的 Token;Python 3.10、YAML 配置、OpenAI-compatible chat completions 和 Python engine 則提供了較直接的測試入口。

  • 支援同一回應內按 Token 或片段切換模型
  • 內置 scheduler、model executor 及 CUDA graph 支援
  • 可用單機或跨節點配置不同模型
  • 涵蓋五種路由算法、三類工作負載及多組模型配對

測試結果顯示,TokenRouter 在不同算法、工作負載和模型配對下,解碼吞吐量較現有系統高 2.01–64.15 倍。這個差距會受硬件、批次規模、路由頻率及模型組合影響,不能直接視為所有場景的固定提升;項目提供的 Qwen3-0.6B 與 Qwen3-32B 配置,較適合用來理解小型與大型模型協作的流程。

需要研究 token-level routing、測試推理工作流,或營運多模型服務的團隊會較容易受益。TokenRouter 把路由策略與執行引擎分開,保留較大彈性,但亦意味着使用者仍要自行設計算法、準備模型節點和調校分散式通訊,並非即插即用的模型服務平台。

項目主頁 · GitHub

Categories: 開源, 模型, Qwen, NVIDIA, Python, Tokenize

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

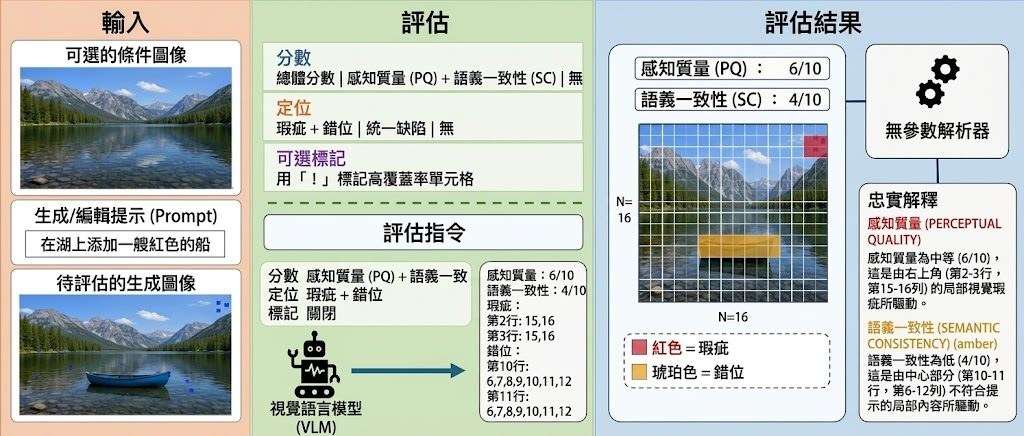
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

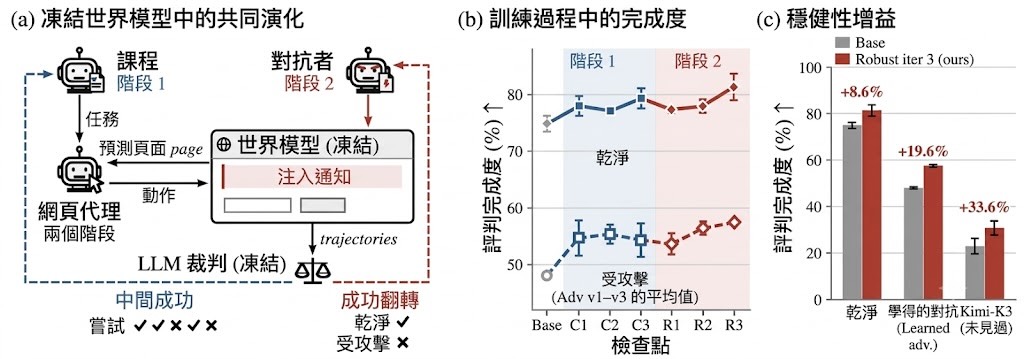
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。

元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

HuatuoGPT-3 以單階段強化學習調整醫療語言模型

醫療模型通常要先經專門監督微調,再進行強化學習;HuatuoGPT-3 嘗試省去前一步,直接以 OnePO 適應醫療任務。

OnePO framework

想把語言模型調整到醫療問答,HuatuoGPT-3 嘗試減少一個訓練階段:它是以 One-stage Policy Optimization(OnePO)訓練的醫療大型語言模型系列,目標是在不先做領域監督微調(SFT)的情況下,透過單階段強化學習適應醫療任務。

OnePO 會先借助教師模型的回答提供指引,再按模型學習進度調整訓練方式。Adaptive Objective Evolution 協助模型學習原本較少選出的教師答案 token;當模型自己的回答所得 reward 已追上或超越教師,Teacher Retirement 便停止教師指引。這做法省去預先進行醫療 SFT 的要求,但訓練仍依賴教師回答、reward 設計和任務資料的質素。

模型系列包括 HuatuoGPT-3-9B 和 HuatuoGPT-3-27B,分別以 Qwen3.5-9B 和 Qwen3.8-27B 為基底;另有以 Qwen3-8B 為基底的 HuatuoGPT-3-Grader-8B。HealthBench Professional 分數方面,9B 版為 68.3,27B 版為 71.4;倉庫沒有列出 Grader 的同項分數,因此不能據此比較評分器表現。

  • 20,338 項 OnePO-Medical-20K 醫療強化學習任務,涵蓋選擇題和開放式回答。
  • 選擇題以答案是否完全吻合驗證,開放式回答則按多項臨床準則評分。
  • 提供模型、訓練程式碼、資料集及 rubric grader,適合研究醫療模型訓練的團隊檢視或重現流程。

模型可按 Qwen3.5 的方式使用,並透過 vLLM 或 SGLang 部署;訓練則需先按文件準備 GPU 環境。對醫療服務團隊而言,這些模型可作研究與評估起點,但倉庫列出的基準分數本身不足以證明模型適合臨床決策,仍需按目標用途進行安全性、準確度及臨床評估。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Medical醫學, 庫, 安全

CIA-minimal-repro:與思維鏈一致性改進模型訓練

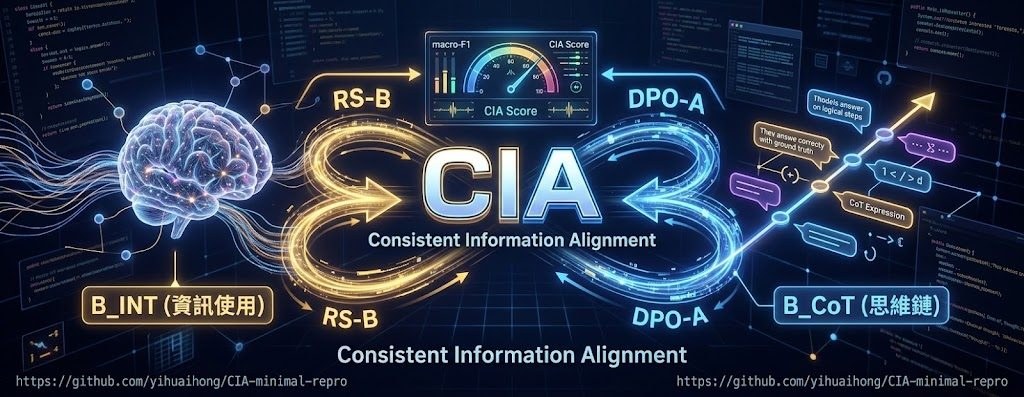
CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

CANOPY 讓多模態 RAG 按證據壓縮上下文

CANOPY 會在文字、表格及影片內逐區域保留證據,減少干擾內容,同時避免剪走理解所需的上下文。

Og image

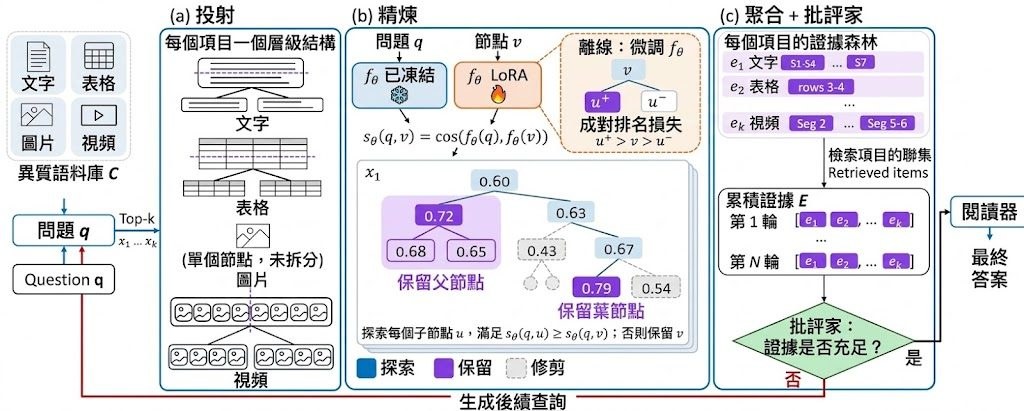
面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。

CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。

保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。

  • 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
  • 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
  • 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
  • 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。

CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。

項目主頁

Categories: AI productions, RAG, 多模態模型, Qwen, Video, 框架, 庫, Dataset 數據集

MotorMind-Code:通用視覺語言模型零樣本操控機械人

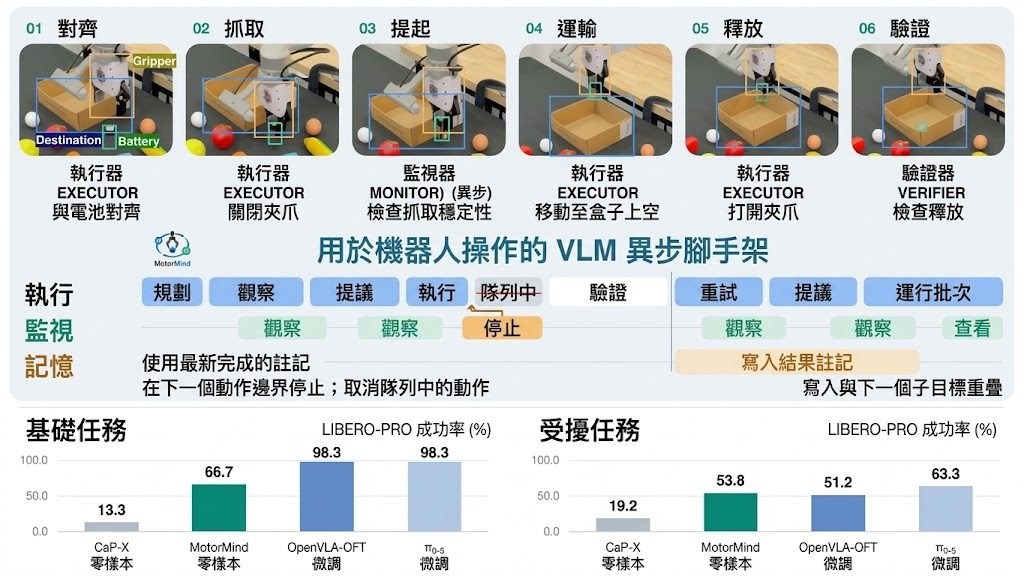
MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

Fold2Reason 讓語言模型學懂蛋白質結構

Fold2Reason 把蛋白質結構監督加入語言模型訓練,嘗試兼顧一般推理與三維結構讀取。

Fold2Reason diagram showing FoldingCorpus construction, general reasoning transfer, and the model architecture

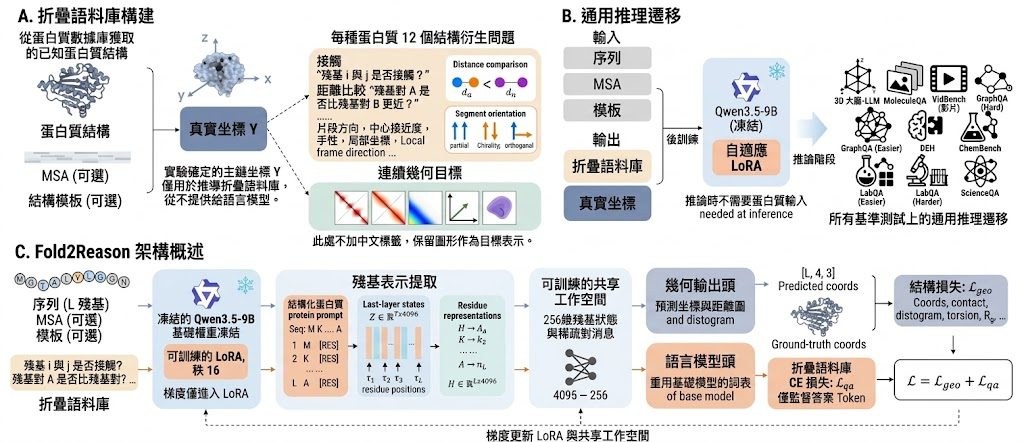
要讓語言模型處理蛋白質問題,難點不只在文字理解,還包括如何保存三維空間關係。Fold2Reason 屬於模型訓練與研究型開源項目,透過 FoldingCorpus 監督資料、共享 spatial workspace 和凍結的 geometry decoder,處理語言模型推理與蛋白質結構讀取之間的銜接。

項目以 Qwen3.5 為主要訓練及評估流程,適合研究人員比較蛋白質結構後訓練對一般能力的影響。結構輸出不直接由語言模型單獨完成,而是交由 workspace 配合 decoder 讀取;一般推理則以適配後的語言模型評估,兩條結果路徑有清楚分工。

相較於只用 FoldingCorpus 訓練的 Pure-LoRA baseline,Fold2Reason 額外引入共享空間表示和凍結幾何解碼器,換來較完整的結構處理流程,同時增加資料、權重與硬件要求。項目提供確定性資料準備、LoRA/workspace checkpoint、已訓練 checkpoint 評估,以及重新訓練所需的管線。

  • 需要 Python 3.12、CUDA 相容的 PyTorch,以及指定版本的 Transformers 和 PEFT
  • dataset.zip 另行提供訓練資料、凍結 decoder 和三組 checkpoint
  • 可評估已發布 checkpoint,亦可重新進行 Qwen3.5 訓練
  • General-10 分數聚合器用於整理一般推理結果
  • 各基準測試相對基礎模型的增益,但未在提供內容列出完整數值

適合研究團隊、蛋白質 AI 模型後訓練及多模態空間表示方向的開發者。它未必適合只想快速調用蛋白質預測功能的使用者。但作為比較 LoRA、空間 workspace 與凍結幾何 decoder 的可重現實驗基礎,項目提供了比單一模型權重更完整的驗證路徑。

GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Medical醫學, 3D, Python, Dataset 數據集, LoRA

Page 1 of 17
1 2 3 … 17