Page Assist 是一個瀏覽器外掛,透過 Ollama 於本機運行 AI 模型,Page Assist 提供了一個十分完善的 Ollama介面。Page Assist 強調不會收集個人資料,十分注重隱私。專案是由 MIT 授權。


Page Assist 是一個瀏覽器外掛,透過 Ollama 於本機運行 AI 模型,Page Assist 提供了一個十分完善的 Ollama介面。Page Assist 強調不會收集個人資料,十分注重隱私。專案是由 MIT 授權。
Page Assist 是一個瀏覽器外掛,透過 Ollama 於本機運行 AI 模型,Page Assist 提供了一個十分完善的 Ollama介面。Page Assist 強調不會收集個人資料,十分注重隱私。專案是由 MIT 授權。
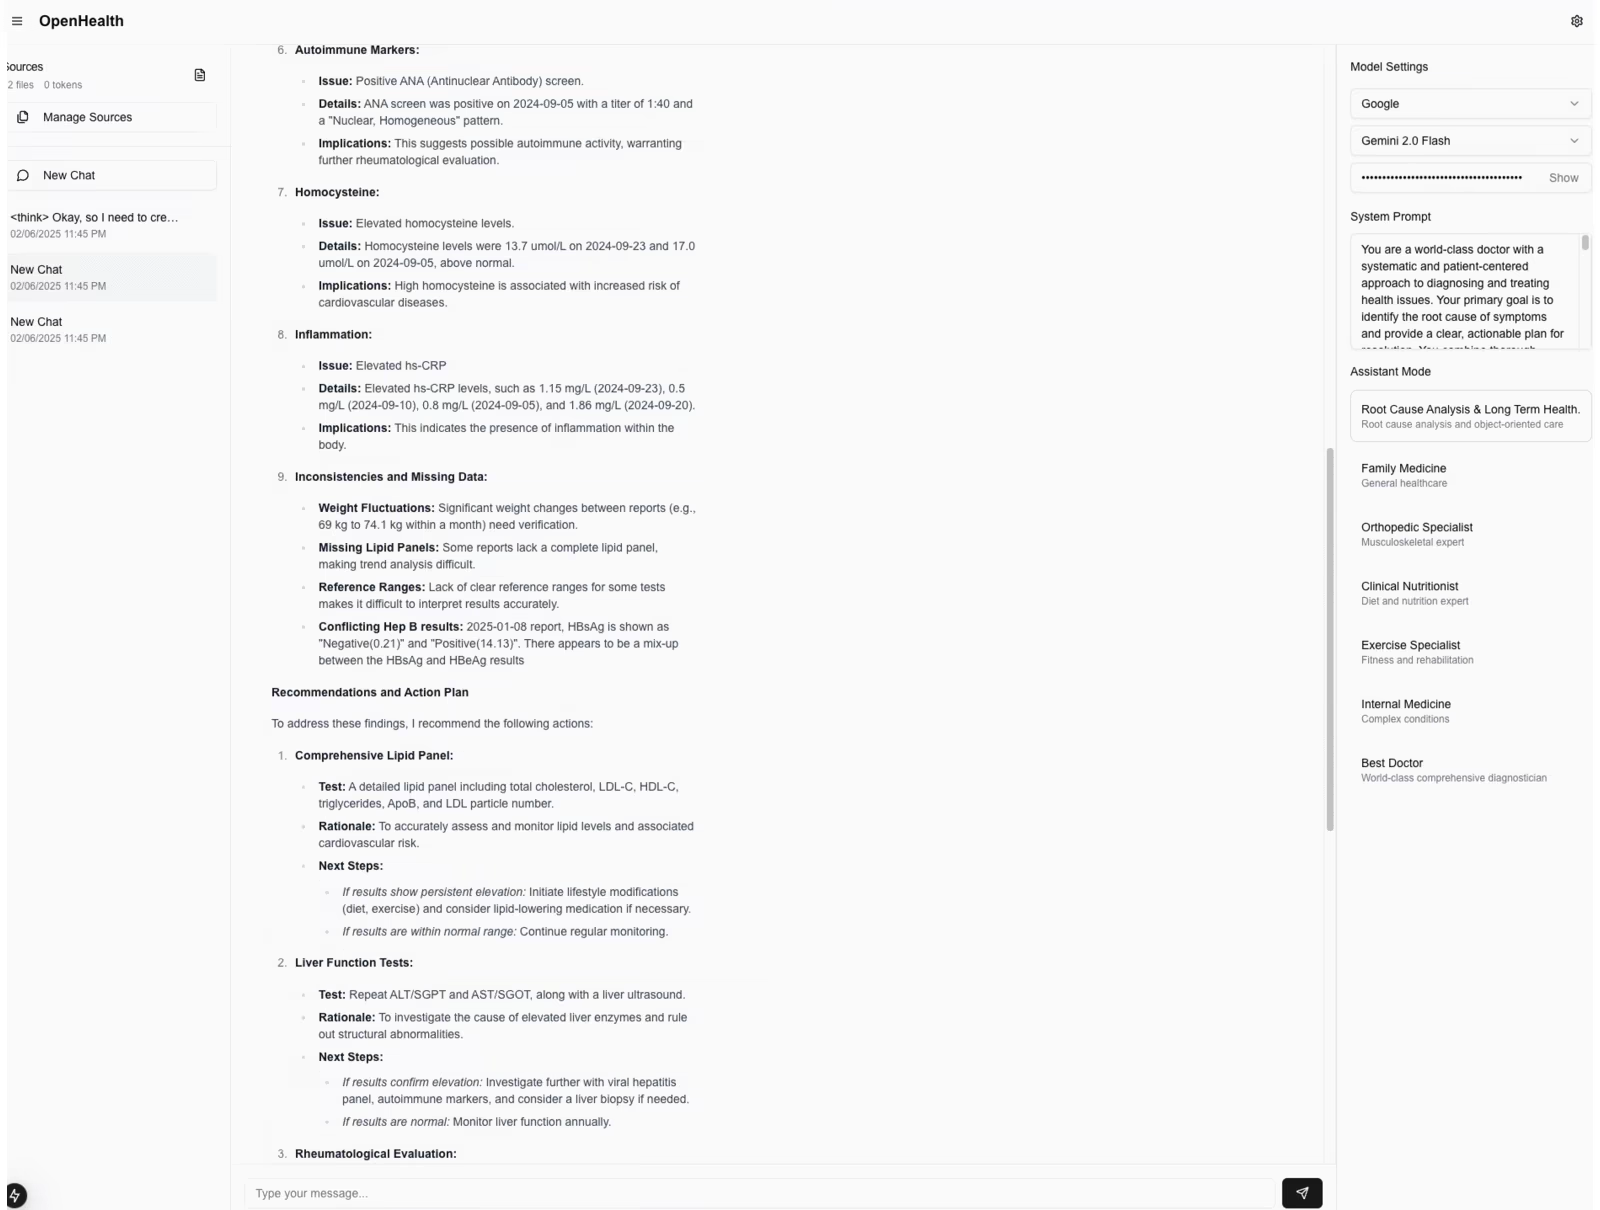
OpenHealth 專案是一個開源的 AI 健康助理,作者描述自己五年來花費超過十萬美元、看過三十多位醫生,卻無法確診自體免疫疾病的痛苦過程。 受到這個經歷的啟發,他開發了一個開源 AI 工具,可以幫助人們分析自己的醫療記錄,從不同的醫院提取並整理數據,並藉由 AI 模型進行分析,找出潛在的疾病。 這個工具的目的是解決醫療資訊分散的問題,讓患者能夠更全面地了解自己的健康狀況,並提供給醫生參考,但作者也強調,此工具僅為輔助診斷,不能取代專業醫療人員的判斷。
OpenHealth 專案是一個開源的 AI 健康助理,作者描述自己五年來花費超過十萬美元、看過三十多位醫生,卻無法確診自體免疫疾病的痛苦過程。 受到這個經歷的啟發,他開發了一個開源 AI 工具,可以幫助人們分析自己的醫療記錄,從不同的醫院提取並整理數據,並藉由 AI 模型進行分析,找出潛在的疾病。 這個工具的目的是解決醫療資訊分散的問題,讓患者能夠更全面地了解自己的健康狀況,並提供給醫生參考,但作者也強調,此工具僅為輔助診斷,不能取代專業醫療人員的判斷。
DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。
DeepSeek-VL2-small 是 DeepSeek-VL2 的小型版本,混合專家 (MoE) 視覺語言模型,旨在提升 DeepSeek-VL 的視覺效能。此模型在視覺問答、光學字元辨識和文件理解等多種任務上展現了卓越的能力。DeepSeek-VL2-small 擁有 28 億(2.8b)個參數,在效能上可與現有的其它開源模型競爭,甚至超越它們。模型的程式碼採用 MIT 許可證,模型本身的使用則受到 DeepSeek 模型許可證的約束,允許商業用途。

DeepRAG 的框架旨在解決大型語言模型(LLMs)在事實性知識上的不足,特別是它們容易產生幻覺的問題。DeepRAG 的核心思想是將檢索增強生成(RAG)視為一個馬可夫決策過程(MDP),使其能夠更策略性地進行檢索。透過分解式查詢,DeepRAG 可以動態決定是否要檢索外部知識或依賴模型自身的參數化推理,最終提升檢索效率和答案準確性。文中包含相關研究推薦、引用模型/數據集/Spaces 的情況以及論文收藏數量等資訊。
TokenVerse 提出一種基於預訓練文字轉圖像擴散模型的多概念個人化方法。它利用模型中的調製空間 (modulation space),從單張圖片中解開複雜的視覺元素和屬性,並能無縫地組合來自多張圖片的概念。不同於現有方法在概念類型或廣度上的限制,TokenVerse 能處理多張圖片的多種概念,包含物件、配件、材質、姿勢和光線等。核心方法是透過優化,為每個文字嵌入 (text embedding) 學習一個獨特的調製向量調整 (modulation vector adjustment),這些向量代表個人化的方向,可用於產生結合所需概念的新圖像。最後,論文展示了 TokenVerse 在具有挑戰性的個人化情境中的有效性,並突顯其優勢。
TokenVerse 提出一種基於預訓練文字轉圖像擴散模型的多概念個人化方法。它利用模型中的調製空間 (modulation space),從單張圖片中解開複雜的視覺元素和屬性,並能無縫地組合來自多張圖片的概念。不同於現有方法在概念類型或廣度上的限制,TokenVerse 能處理多張圖片的多種概念,包含物件、配件、材質、姿勢和光線等。核心方法是透過優化,為每個文字嵌入 (text embedding) 學習一個獨特的調製向量調整 (modulation vector adjustment),這些向量代表個人化的方向,可用於產生結合所需概念的新圖像。最後,論文展示了 TokenVerse 在具有挑戰性的個人化情境中的有效性,並突顯其優勢。

DreamCatalyst 是一個新穎的三維編輯架構,它改進了現有基於分數蒸餾採樣(SDS) 的方法,解決了訓練時間長和結果品質低的問題。DreamCatalyst 的關鍵在於將 SDS 視為三維編輯的擴散逆向過程,而不像現有方法那樣單純地蒸餾分數函數,使得更好地與擴散模型的採樣動態相協調。結果,DreamCatalyst 大幅縮短了訓練時間,並提升編輯品質,在速度和品質上都超越現有最先進的神經輻射場(NeRF) 和三維高斯散點(3DGS) 編輯方法,展現其快速且高品質的三維編輯能力。
DreamCatalyst 是一個新穎的三維編輯架構,它改進了現有基於分數蒸餾採樣(SDS) 的方法,解決了訓練時間長和結果品質低的問題。DreamCatalyst 的關鍵在於將 SDS 視為三維編輯的擴散逆向過程,而不像現有方法那樣單純地蒸餾分數函數,使得更好地與擴散模型的採樣動態相協調。結果,DreamCatalyst 大幅縮短了訓練時間,並提升編輯品質,在速度和品質上都超越現有最先進的神經輻射場(NeRF) 和三維高斯散點(3DGS) 編輯方法,展現其快速且高品質的三維編輯能力。

DiffuEraser 是個基於穩定擴散模型的開源影片修復模型。利用先驗資訊作為初始化,減少雜訊和幻覺,並藉由擴展時間以及利用影片擴散模型的時間平滑特性,提升長序列推論中的時間一致性。 DiffuEraser 透過結合鄰近影格資訊修復遮罩區域,展現比現有技術更佳的內容完整性和時間一致性,即使在處理複雜場景和長影片時也能產生細節豐富、結構完整且時間一致的結果,且無需文字提示。 其核心在於提升影片修復的生成能力與時間一致性。
DiffuEraser 是個基於穩定擴散模型的開源影片修復模型。利用先驗資訊作為初始化,減少雜訊和幻覺,並藉由擴展時間以及利用影片擴散模型的時間平滑特性,提升長序列推論中的時間一致性。 DiffuEraser 透過結合鄰近影格資訊修復遮罩區域,展現比現有技術更佳的內容完整性和時間一致性,即使在處理複雜場景和長影片時也能產生細節豐富、結構完整且時間一致的結果,且無需文字提示。 其核心在於提升影片修復的生成能力與時間一致性。

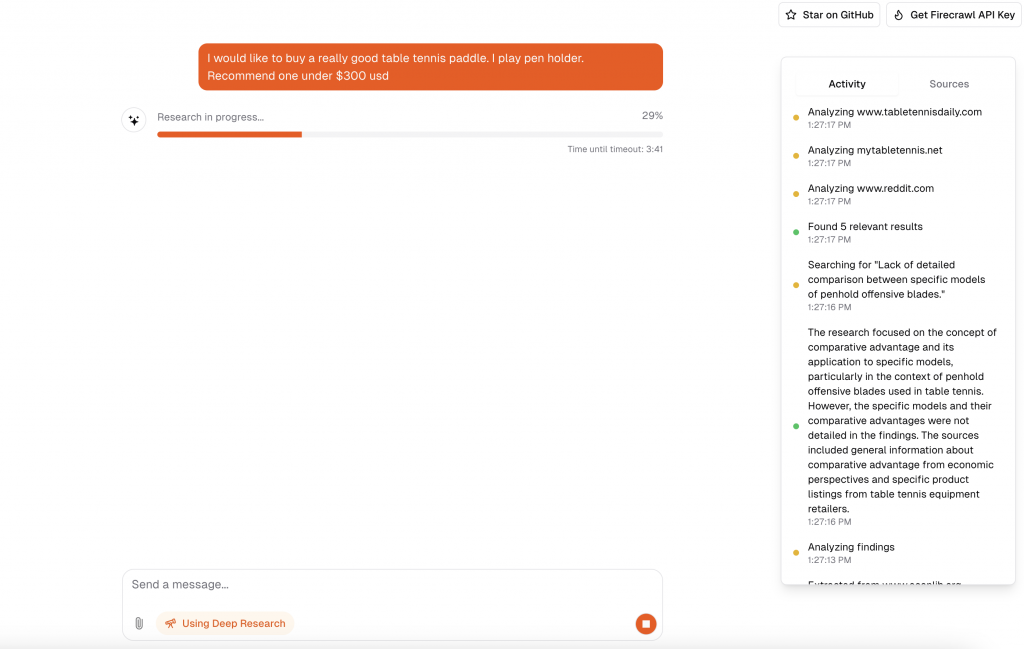
open-deep-research 是個開源的深度研究工具,模仿 OpenAI 的 Deep Research 實驗,但使用 Firecrawl 擷取和搜尋網頁資料,並結合推理模型,而非微調 o3 模型。 專案以Next.js建構,具有多種功能,包含即時資料饋送、結構化資料擷取、先進路由、支援多種大型語言模型(LLM)如 OpenAI、Anthropic 和 Cohere),當然亦 Support 免費的 Ollama 以及資料持久化機制。 提供本地部署和執行說明。 整體而言,它展示了一個強大的、可擴展的深度研究工具,並強調其開源和易於使用的特性。
open-deep-research 是個開源的深度研究工具,模仿 OpenAI 的 Deep Research 實驗,但使用 Firecrawl 擷取和搜尋網頁資料,並結合推理模型,而非微調 o3 模型。 專案以Next.js建構,具有多種功能,包含即時資料饋送、結構化資料擷取、先進路由、支援多種大型語言模型(LLM)如 OpenAI、Anthropic 和 Cohere),當然亦 Support 免費的 Ollama 以及資料持久化機制。 提供本地部署和執行說明。 整體而言,它展示了一個強大的、可擴展的深度研究工具,並強調其開源和易於使用的特性。
Janus 系列多模態理解和生成模型。核心是三個模型:Janus、Janus-Pro 和 JanusFlow,它們都基於單一 Transformer 架構,實現了統一的多模態理解和生成。Janus-Pro 是 Janus 的進階版,透過優化訓練策略、擴展數據和提升模型規模,顯著提升了性能。JanusFlow 則結合了自迴歸語言模型和修正流模型,在效能和多功能性上取得平衡。該資源提供了模型下載、快速入門指南,以及使用 Python 進行多模態理解和圖像生成的程式碼範例,並提供了 Hugging Face 線上演示和本地 Gradio/FastAPI 演示的說明。 最後,還列出了相關論文的引用資訊。
Janus 系列多模態理解和生成模型。核心是三個模型:Janus、Janus-Pro 和 JanusFlow,它們都基於單一 Transformer 架構,實現了統一的多模態理解和生成。Janus-Pro 是 Janus 的進階版,透過優化訓練策略、擴展數據和提升模型規模,顯著提升了性能。JanusFlow 則結合了自迴歸語言模型和修正流模型,在效能和多功能性上取得平衡。該資源提供了模型下載、快速入門指南,以及使用 Python 進行多模態理解和圖像生成的程式碼範例,並提供了 Hugging Face 線上演示和本地 Gradio/FastAPI 演示的說明。 最後,還列出了相關論文的引用資訊。

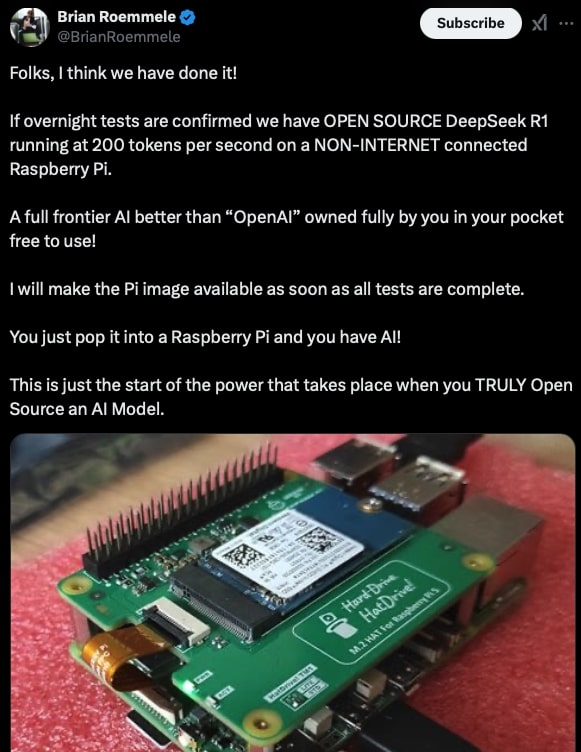
開源人工智慧模型 DeepSeek R1 在樹莓派上以每秒 200 個 token 的速度運作,這是個突破性進展。重點在於此模型的效能即使在資源受限的樹莓派上也能達到令人驚訝的表現,並超越某些商業模型,例如OpenAI的某些版本。文章同時比較了不同硬體平台(如樹莓派、桌上型電腦、高效能GPU)運行此模型的效能差異,並探討了其在遊戲NPC應用上的潛力,強調其離線運作、低延遲以及可定制性等優點。
開源人工智慧模型 DeepSeek R1 在樹莓派上以每秒 200 個 token 的速度運作,這是個突破性進展。重點在於此模型的效能即使在資源受限的樹莓派上也能達到令人驚訝的表現,並超越某些商業模型,例如OpenAI的某些版本。文章同時比較了不同硬體平台(如樹莓派、桌上型電腦、高效能GPU)運行此模型的效能差異,並探討了其在遊戲NPC應用上的潛力,強調其離線運作、低延遲以及可定制性等優點。