Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。
Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。
Google 推出了 Gemini CLI,一個免費的開源項目。它允許開發者透過自然語言指令在 Terminal 使用 Google 的 Gemini 2.5 Pro 模型。它可以編寫程式碼,亦能夠處理內容的生成、或者解決問題、甚至深入研究和任務管理等的多種任務。這個工具的設計目標是提升開發者在終端機中的工作效率,令 AI 成為日常工作流程的一部分。
影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。 影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。
影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。
影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。

在 Anthropic 最近的研究中,引入了一種追蹤大型語言模型思想的新方法。今天,他們開放該方法的源代碼,以便任何人都可以藉鑑我們的研究成果。 您可以造訪 Neuronpedia 介面 來產生和查看您選擇的提示的歸因圖。對於更複雜的使用和研究,您可以查看 程式碼庫。此版本使研究人員能夠:
在 Anthropic 最近的研究中,引入了一種追蹤大型語言模型思想的新方法。今天,他們開放該方法的源代碼,以便任何人都可以藉鑑我們的研究成果。
您可以造訪 Neuronpedia 介面 來產生和查看您選擇的提示的歸因圖。對於更複雜的使用和研究,您可以查看 程式碼庫。此版本使研究人員能夠:

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

Absolute Zero 是由清華大學主導的一項創新語言模型訓練方法。這個方法最顯著的特點是不再需要由人類提供的數據進行訓練,而是自動生成問題,然後嘗試自動解決問題來進行學習。過往的監督學習,或者強化學習,一般都是由人類設定目標進行監管,而 Absolute Zero 可以透過自我對弈機制。能夠在數學和程式設計的領域中自動提升推理能力。研究顯示,這種模型不僅在這些領域達到了最先進的性能,甚至超越了由人類策劃的數據去訓練的模型。
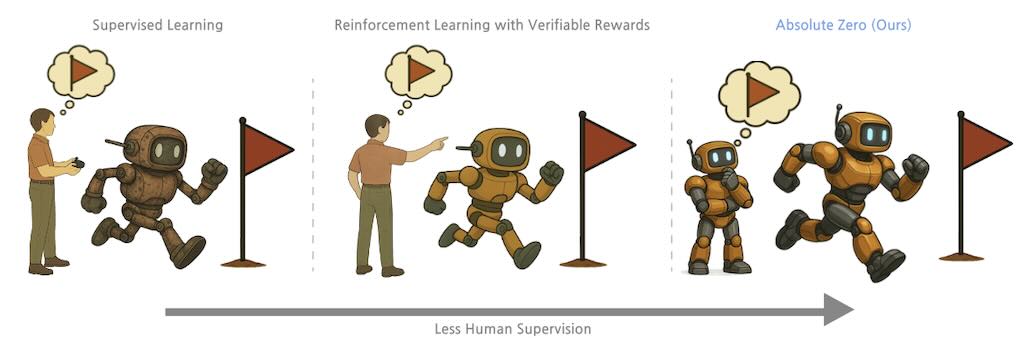
Absolute Zero 是由清華大學主導的一項創新語言模型訓練方法。這個方法最顯著的特點是不再需要由人類提供的數據進行訓練,而是自動生成問題,然後嘗試自動解決問題來進行學習。過往的監督學習,或者強化學習,一般都是由人類設定目標進行監管,而 Absolute Zero 可以透過自我對弈機制。能夠在數學和程式設計的領域中自動提升推理能力。研究顯示,這種模型不僅在這些領域達到了最先進的性能,甚至超越了由人類策劃的數據去訓練的模型。
nanoVLM 是一種極簡輕量級的視覺語言模型 (VLM),專為高效的訓練和實驗而設計。使用純 PyTorch 構建,整個模型架構和訓練邏輯大約需要 750 行程式碼。它將基於 ViT 的圖像編碼器(SigLIP-B/16-224-85M)與輕量級因果語言模型(SmolLM2-135M)相結合,形成了一個緊湊的 222M 參數模型。該模型使用來自 cauldron 資料集的 170 萬個樣本在單一 H100 GPU 上訓練約 6 小時後,在 MMStar 上實現了 35.3% 的準確率,這使其成為低資源 VLM 研究的強大基線。
💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感! 🔍 新功能1️⃣ YOLO NSFW過濾2️⃣ 多GPU支援3️⃣ FLAC音訊輸出4️⃣ 臉部選擇增強
💥 FaceFusion 3.2.0 更新不僅帶來了全新的GPU加速,還提升了不少效能與真實感!
🔍 新功能
1️⃣ YOLO NSFW過濾
2️⃣ 多GPU支援
3️⃣ FLAC音訊輸出
4️⃣ 臉部選擇增強

LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。 影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。
Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。
影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。

MiniMax 模型上下文協定 (MCP) 伺服器,可與強大的文字轉語音和視訊/圖像生成 API 進行互動。此伺服器允許 MCP 用戶端(如 Claude Desktop 、 Cursor 、 Windsurf 、 OpenAI Agents 等)產生語音、複製聲音、產生視訊、產生影像等。
MiniMax 模型上下文協定 (MCP) 伺服器,可與強大的文字轉語音和視訊/圖像生成 API 進行互動。此伺服器允許 MCP 用戶端(如 Claude Desktop 、 Cursor 、 Windsurf 、 OpenAI Agents 等)產生語音、複製聲音、產生視訊、產生影像等。