LISA:讓 ControlNet 訓練快 2.78 倍的正則化方法

香港科技大學團隊提出的 LISA 正則化技術,能在不增加推理成本的前提下,加速視覺條件可控生成模型的訓練並提升生成品質。

Arxiv

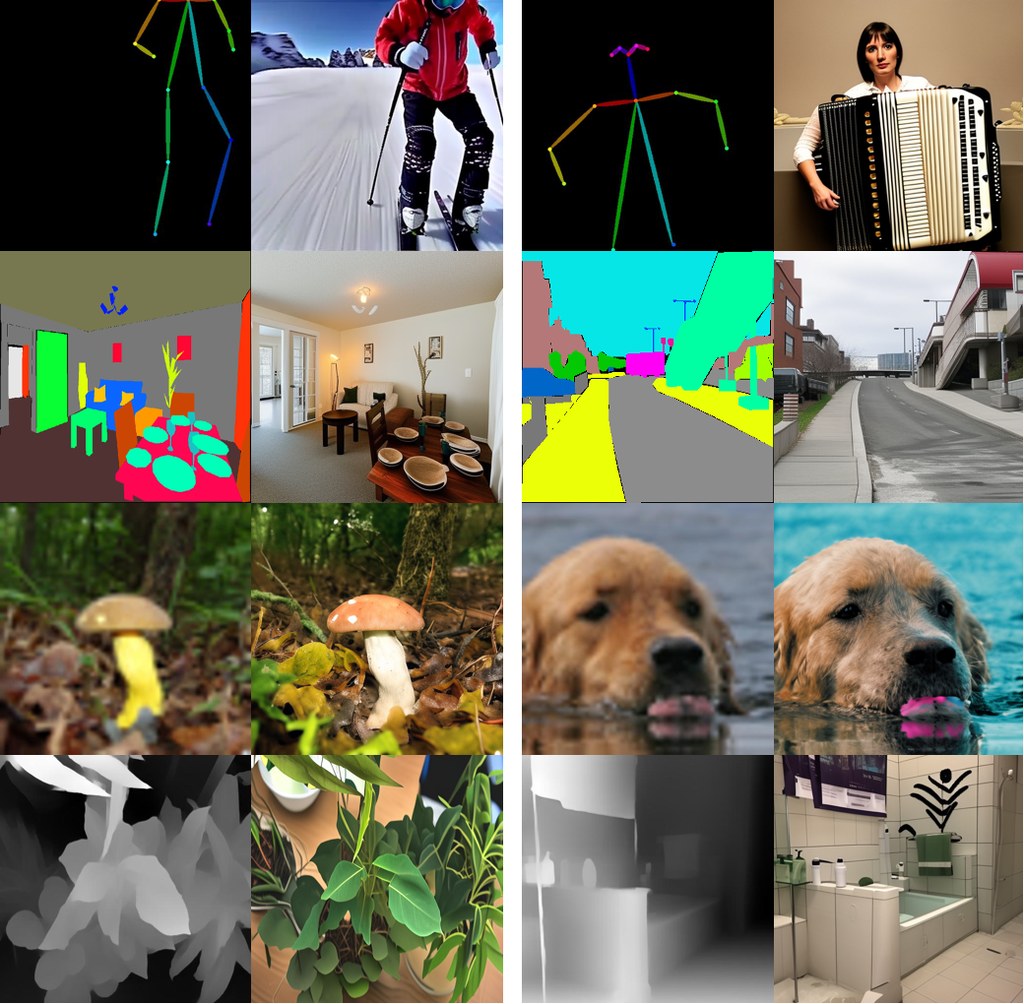
LISA(Likelihood Score Alignment)是一種訓練正則化方法,專門用於加速視覺條件可控生成模型(例如 ControlNet)的訓練過程,同時提升最終生成結果在感知品質與條件遵循度上的表現。

現有做法普遍採用「雙分支範式」(dual-branch paradigm):訓練一個側網絡(side network)來編碼視覺條件,再將其中間層特徵融合到凍結的預訓練主網絡中。這個範式雖然效果顯著,但側分支的角色定位與訓練效率長期未被深入研究。LISA 從基於分數的生成建模(score-based generative modeling)角度重新審視這個範式:主網絡負責提供先驗的無條件分數(unconditional score),側網絡則透過隱式方式貢獻似然分數(likelihood score)。

LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。

根據論文實驗結果,LISA 在多種圖像與影片任務、不同網絡架構(UNet/DiT)以及擴散與流匹配模型上均表現穩定,能夠實現超過 2.78 倍的訓練收斂加速(例如在 ControlNet 上),同時帶來可忽略的額外訓練成本與零推理成本。

這項技術特別適合需要快速迭代 ControlNet 或類似條件控制模型的團隊,例如從事姿態引導圖像生成、組合條件生成或可控影片生成的研究人員與開發者。

重點摘要:

  • 方法類型:訓練正則化技術,適用於雙分支視覺條件可控生成框架
  • 核心創新:將側網絡特徵對齊近似似然分數目標,取代純粹依賴擴散損失的訓練方式
  • 訓練效率:在 ControlNet 等場景實現超過 2.78 倍的收斂加速
  • 推理成本:零額外推理開銷,解碼器僅在訓練階段使用
  • 適用範圍:圖像與影片生成任務,兼容 UNet 與 DiT 架構,支援擴散與流匹配模型
GitHub · Paper

Categories: 開源, 香港科技大學, 華為, 模型, 視覺模型, 模型訓練, 框架, 香港, IDE, 深度學習

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

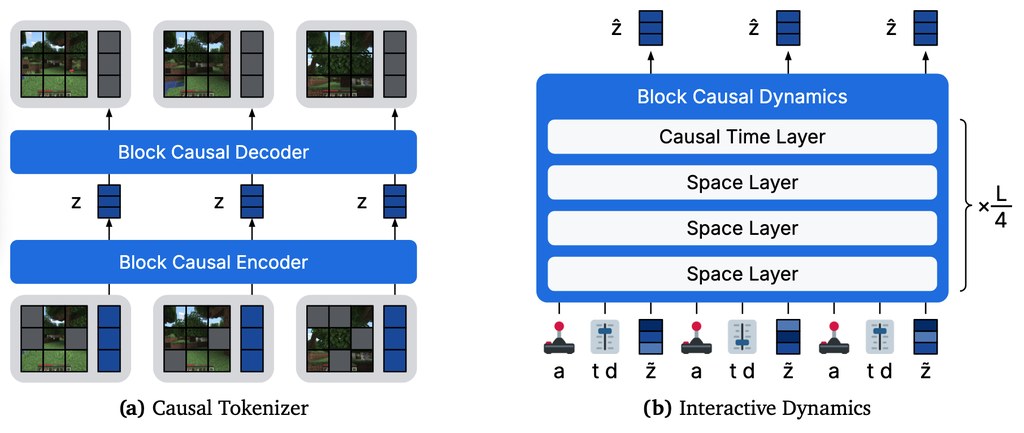
walker run

MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

OpenBioRQ 用未解醫學問題測試 AI 代理

這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。

Repository image for minstar/healthcare-research

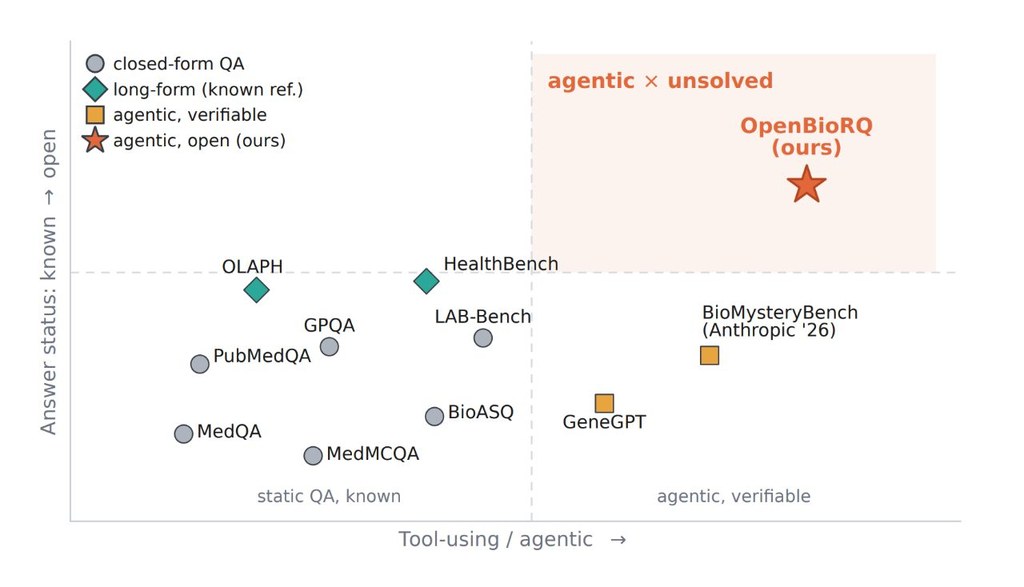
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。

現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。

項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。

它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。

  • 類型定位:屬於基準資料集加評測 pipeline,不是臨床決策系統
  • 主要價值:檢查 evidence retrieval、faithful citation 與 abstention,而非考模型背誦
  • 評測設計:用 per-question checklist rubrics 固定評分,inter-judge agreement 由 Spearman 0.35 升到 0.82
  • 資料可靠性:core 657 與 expand 483 均報告 contamination hard 0%
  • 相關模型:Google、Anthropic、OpenAI 三條獨立 lineage,以及 README 提到的 GLM-5.1、MiniLM-L6

受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, Medical醫學, Anthropic, Dataset 數據集

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

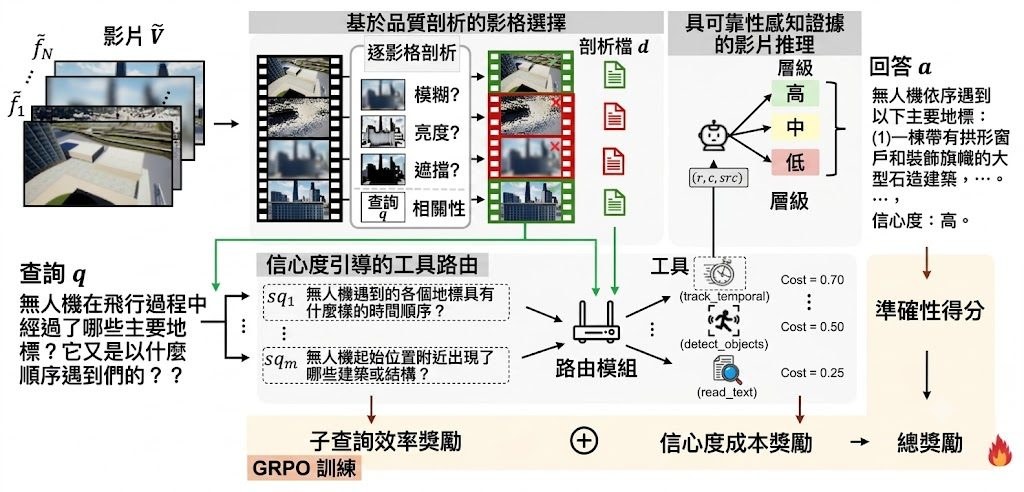
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

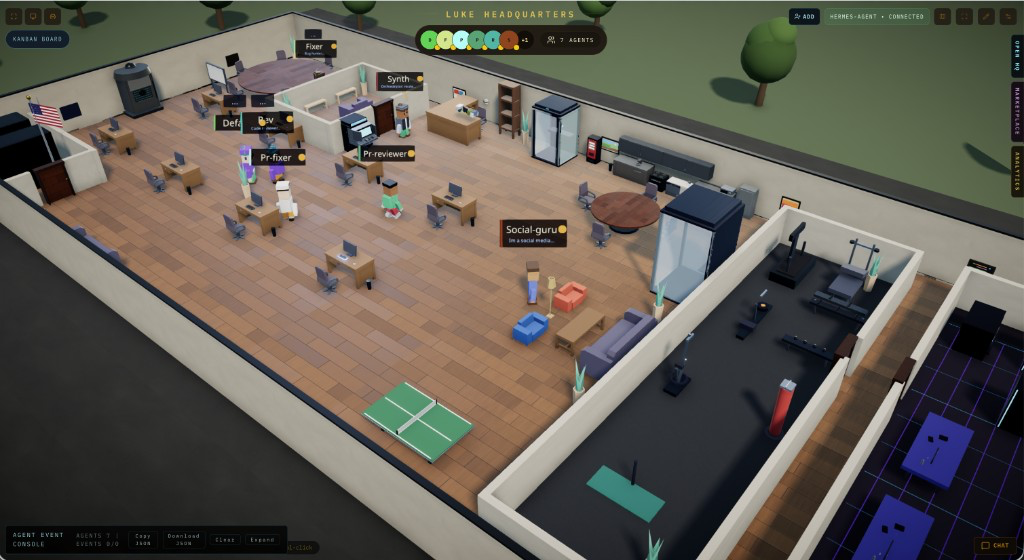
Hermes3D:把 AI 團隊放進 3D 辦公室協作

Hermes3D 將 AI agents 的工作流程搬入自建 3D 辦公室,讓協作、程式碼審查和 QA 監控變得可見。

Hermes3D

將 AI agents 的協作、standup、Pull Request 審查和 QA pipeline 放進同一個可行走的 3D 空間,Hermes3D 便是一個自建的 3D 虛擬辦公室項目,處理的是 AI 工作流程難以觀察和管理的問題。它把原本分散在 dashboard、GitHub、Jira 和 logs 的活動,集中到共享辦公室內呈現。

Hermes3D 本身只是 visualization and interaction layer,Gateway 則負責控制和連接後端。項目支援內置 Gateway adapter,讓 Hermes 透過 WebSocket 接入;亦可使用 direct HTTP custom runtime provider 連接其他 orchestrator-backed stacks,另有 built-in demo gateway,方便先探索辦公室功能而毋須接入真正的 agent framework。

使用者可先用 demo gateway 檢查 3D 辦公室、代理協作和介面流程,再按需要接駁 Hermes、GitHub、Jira 或自訂 HTTP runtime。README 暫未提供完整安裝步驟或效能基準,因此較適合視為仍在發展中的 self-hosted workspace,而不是可直接取代現有監控系統的成熟平台。

  • 以 3D 場景即時查看 AI agents 的工作狀態
  • 在辦公室內進行 standup、Pull Request 審查和 QA 監控
  • 透過 gym 訓練 agents 發展新技能
  • 以 janitor system 重設 session 和清理 context
  • 支援 Hermes、custom runtime 及 demo gateway

對管理多個 AI agents、需要追蹤程式碼交付流程,或希望資料留在自家基礎設施的個人開發者和小型團隊,Hermes3D 提供了比純文字 logs 更直觀的觀察方式。代價是 3D 顯示層會增加系統複雜度,是否適合正式工作流仍要以團隊自己的 runtime 和整合測試為準。

GitHub

Categories: 開源, Agentic, 框架, 3D

ViQ 想把影像變成更懂語意的離散碼

ViQ 是把影像量化成離散表示的研究框架,目標是在語意理解與細節保留之間取得平衡。它也支援任意解析度輸入,對多模態訓練效率有明顯吸引力。

hunyuan logo

ViQ 是一個視覺量化表示研究框架,也是把影像轉成離散 codes 的模型方法。它要解決的問題,是讓圖片像文字 token 一樣可交給多模態大模型處理,同時盡量不要在量化過程丟失太多語意與畫面細節。

現有做法常見兩條路:一類偏重重建,還原畫面能力較好,但語意資訊不足;另一類依賴 contrastive vision-language learning 的連續特徵,語意較強,卻不容易直接變成高品質離散表示。ViQ 的切入點是先做 Text-Aligned Pre-training,再做量化學習,把「先對齊語言語意、後逐步離散化」拆成清楚兩段。

它的核心設計有幾個辨識度很高的部件:以 pretrained language model 監督視覺編碼器、用 resized positional embedding 與 native patchify 支援 any-resolution input、再用 Proximal Representation Learning 配合 L∞-norm 約束,把特徵逐步推近量化錨點,最後交給 position-aware、head-wise FSQ(Finite Scalar Quantization)處理。論文亦提到基座可接 SigLIP2 vision tower、Qwen2.5 backbone,並透過 LoRA 等輕量組件訓練量化部分,而不是全面微調整個系統。

  • 支援任意解析度輸入,不用被固定尺寸綁死
  • 目標不是只重建圖片,而是兼顧語意理解與細節
  • 多模態訓練可直接吃離散視覺 codes,論文稱效率可提升約 20% 至 70%
  • 已公開訓練與推論程式,並提供 HuggingFace 權重

從部署與測試角度看,這個 GitHub 儲存庫較適合當研究實作與模型驗證項目來理解:可先用已公開權重跑 inference,觀察影像如何被編成離散 codes,再進一步重現單階段訓練示例,之後才嘗試論文中的兩階段 recipe。較受惠的會是做 MLLM、視覺 tokenization、影像重建或訓練加速的團隊;限制則是概念與訓練流程都不算輕,重點較偏研究價值,未必是即裝即用的通用工具。

GitHub: https://github.com/yuxumin/ViQ

Paper: https://arxiv.org/pdf/2606.27313

Categories: 開源, 清華大學, 騰訊, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架

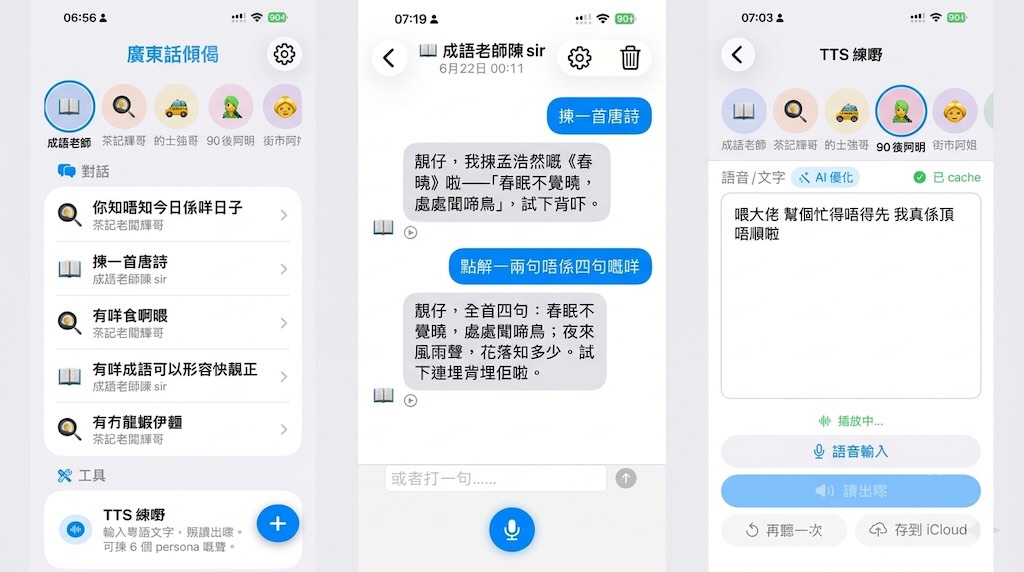
CantoneseChat:會聽聲調語氣的粵語聊天 App

一個針對粵語互動而做的 iOS 項目,把語音辨識、語氣調整同 TTS 串成完整對話流程。重點不只在聊天,而是回應更貼近香港人口吻。

Cantonese Chat iOS app demo — Home / Chat / TTS Lab

CantoneseChat 是一個 iOS 粵語語音聊天工具項目,核心目標不是做通用聊天介面,而是把 iPhone 收音、on-device 粵語 STT、MiniMax cloud 的 LLM + TTS,以及 persona 語氣控制接成一條完整流程。它實際解決的問題,是一般語音助手識到字,但未必講得似香港人,亦未必會按說話者特徵調整語氣。

這個項目最值得留意的地方,是它會先用 AVAudioEngine 收音,再把音訊 downsample 去 16kHz,用 autocorrelation 估 pitch,推斷 VoiceTypeGenderAgeGroup,之後把結果注入 LLM system prompt。這種做法不是高精度聲紋身份辨識,而是偏向 heuristic 的語氣適配,所以速度會較直接,代價是分類準確度很受環境噪音、聲線變化同 pitch 規則影響。

安裝與理解方式也算清晰:它是 iPhone 真機導向的 iOS App,因為核心功能依賴 mic、AVAudioEngine、本機語音輸入同雲端模型串接,單看資料已可判斷模擬器未必能完整反映效果。測試時應分開看幾部分:persona 對話是否有語氣差異、TTS Lab 經 AI 粵語優化後是否更口語、pronunciation_overrides.txt 能否修正讀音,以及 iCloud export 有沒有順利保存音頻。

  • 支援 6 個 persona,適合示範同比較不同說話風格
  • 用 pitch heuristic 分類 VoiceType,再推斷 GenderAgeGroup
  • 整合 on-device 粵語 STT、MiniMax cloud 的 LLM + TTS
  • 提供 pronunciation_overrides.txt 修正粵語讀音
  • 可將生成音頻匯出到 iCloud Drive

適合想做香港市場語音互動介面,例如客服示範、教育對話、角色語音內容,或者想研究粵語人機互動體驗的小團隊。若你重視可控語氣、多 persona 展示同本地口語感,它有明確方向;若你追求嚴格年齡性別判斷,這套規則式分類就應視為體驗輔助,而不是可靠的人口統計模型。

相關模型與模組包括 MiniMax cloud 的 LLMTTS、iOS on-device 粵語 STT,以及項目內以 pitch 為基礎的 VoiceType 分類流程。公開資訊未見標準基準測試或 OSWorld 這類評測結果,所以較合理的判斷方式,是把它看成一個完成度不錯、偏產品原型取向的粵語語音互動項目。

GitHub: https://github.com/elbartohub/CantoneseChat

Categories: 開源, 文字轉語音, Audio, 香港, 語音, 蘋果, MiniMax, 廣東話

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

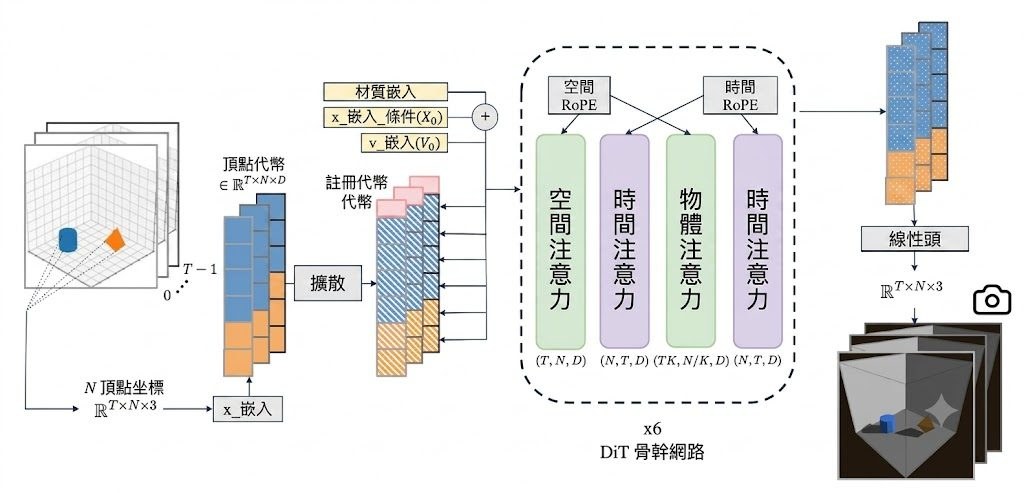
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

Page 44 of 92
1 42 43 44 45 46 92