RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。

RubatoCodec architecture

語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。
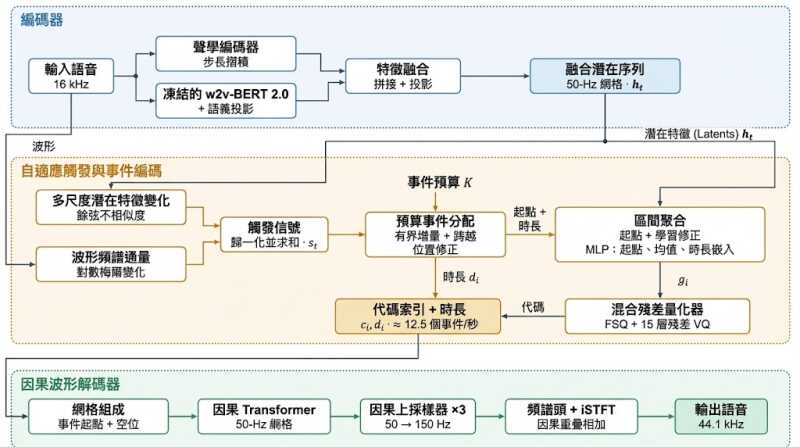
量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)
GitHub · 模型

Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

PawCT:分拆四聲部合唱

把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

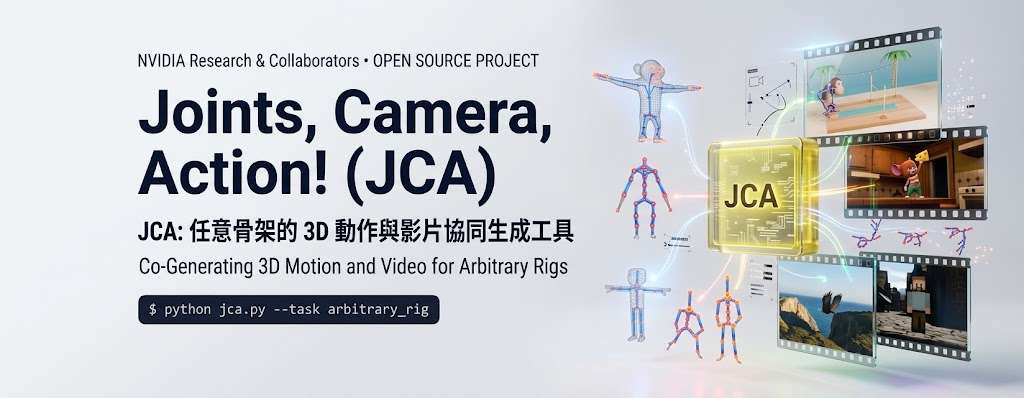
文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

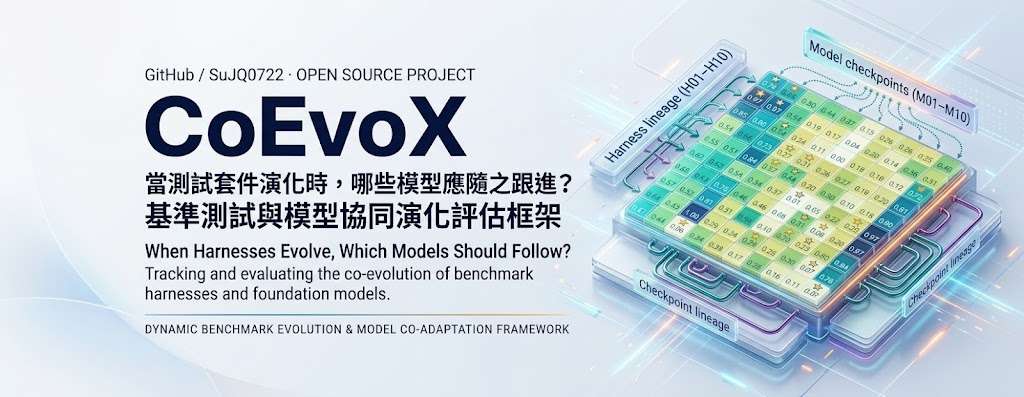
CoEvo-RSI:讓模型跟上會進化的 Agent Harness

CoEvoX 讓模型與執行框架同步演化,改善 AI Agent 的能力與工作流程互相錯配及自我進化(RSI - Recursive Self-Improving)的問題。

CoEvoX framework

當 Agent 的執行流程不斷改變,模型可能未學懂新要求,也可能因 Harness 限制而用不出原有能力。CoEvoX 屬於 LLM agent 的模型—Harness 共演框架,透過共同演化歷史檔案,協調模型檢查點、執行框架與實驗結果。

每輪流程由 meta-agent 編輯新 Harness,從歷史檔案選擇或合併模型 checkpoint,再用拒絕取樣軌跡進行 SFT;只有通過驗證的改善組合才會晉升。TIMR(Turn-level Interface Mismatch Rate)用來診斷逐回合的介面錯配,亦令模型選擇不再只看單一模型能力。

• Qwen3.5-9B 經 CoEvoX 調整後,部分失效歸因測試超越更大型模型
• 評估涵蓋多代理失效歸因、角色感知 text-to-SQL 及智能家居指令
• Held-out 測試避免同時參與訓練與演化選擇
• 結果並非全面領先,部分演算法生成或 When 指標仍落後其他方法

失效歸因結果中,CoEvoX 在 Hand-Crafted 的 Who、Pro 的 Who,以及 TraceElephant 的 Who 分別取得 68.39%、69.43% 和 70.78%,但在 TraceElephant When 只有 28.92%,低於 GSPO 的 38.36%。這反映共演化能改善特定工作分工,卻未必對所有推理步驟同樣有效。

項目較適合研究 recursive self-improving agents、模型訓練及 Harness 設計的團隊,用來測試模型與工作流程是否互相配合。提供的資料沒有完整安裝、執行指令或部署流程,亦不應直接假設可隨意下載;目前較合理的理解是把它視為附有實驗框架與評估方向的研究項目。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

StreamingSwap 把影片換臉推向 20 FPS 即時串流

StreamingSwap 針對長片換臉的身份穩定與速度取捨,透過較短上下文支援單卡即時處理。

StreamingSwap

長時間影片換臉最難維持的不是單幀效果,而是身份一致、原有動作和畫面細節能否一路穩定。StreamingSwap 是一個參考圖像引導的影片換臉模型框架,處理把來源身份轉移到目標影片、同時保留目標人物屬性與動態的問題。

它分兩個階段改善速度與穩定性。Face-RoI Generation 只集中處理臉部區域,配合按噪聲程度調整身份與重建比重的 Joint Rec-ID Loss;其後以 Short-Context Rollout Training 使用模型生成的歷史畫面,減少串流生成中的誤差累積。這套方法針對換臉只改變身份、其他視覺內容大致不變的特性,補足單靠 flow-matching supervision 對身份差異不夠敏感的問題。

提供的結果包括:
– 單張 NVIDIA RTX 4090 達到 21.174 FPS 的端到端吞吐量
– 評估影片最長達 10 分鐘,並展示 19 分鐘、20 FPS 取樣的直播串流測試
– HumanFaceVid 包含 1,000 小時電影風格訓練資料,以及各 200 段短片和長片評估集
– 研究結果在身份轉移和視覺質素之間取得具競爭力的平衡,但資料建構程式和訓練資料仍標示為準備中

電影後期、直播特效和長片角色替換等情境,較能受惠於這種空間與時間上下文都較節省的做法;單卡 RTX 4090 的測試結果亦令即時串流更接近可行範圍。項目提供的是研究模型與展示資料,原始資訊未交代完整安裝指令、未有直接下載的模型權重或訓練資料,因此不宜當成已可隨意下載使用的成品。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 框架, Dataset 數據集

SWIFT 把擴散模型的訓練誤差轉成性能優勢

有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

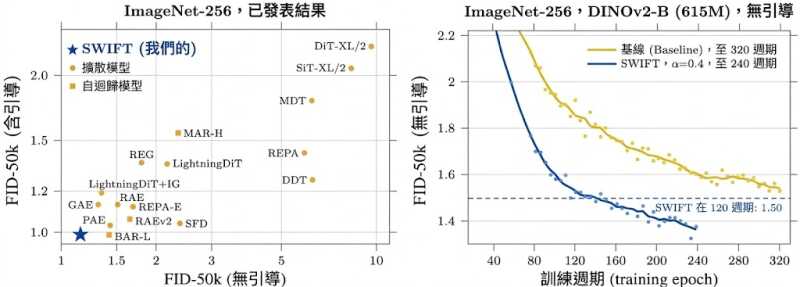
在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

PhysSkin++ 令 3D 模型郁得唔再硬掘掘!

PhysSkin 把靜態 3D 形狀轉成可泛化的物理動畫控制,減少每個模型重新訓練的成本。

teaser

不同模型形狀、網格密度甚至空間表示法各異,物理動畫往往要重新建立變形控制。PhysSkin 屬於 3D 動畫模型,透過自監督 Neural Skinning 學習連續 Skinning Fields,讓不同形狀可以共用即時物理動畫能力。

模型先用 transformer-based shape encoder 讀取形狀,再由 cross-attention field decoder 產生與形狀相關的變形子空間;physics-informed self-supervised objectives 則以物理約束和正交性要求取代完整模擬軌跡標註。這個組合針對的是泛化能力與運算速度之間的取捨,而不是單純追求更細緻的離線模擬。

README 提供 Python 3.11、PyTorch 2.7.1 等環境版本,以及資料目錄、physskin_vis.ipynb 視覺化筆記本和訓練流程。資料包含 (1, 256, 768) 的 float32 latents 與三維內部點,項目亦列出預訓練 checkpoint 路徑;原始資料沒有交代公開下載方式,不能因此假設模型可隨意取得。

  • 可跨不同形狀與 discretization 使用連續 Skinning Fields
  • 以自監督物理目標減少動畫標註依賴
  • 支援即時 physics-based animation 的研究與互動控制場景
  • README 沒有提供具體 FPS、誤差或同類方法差距

對動畫研究、3D 內容工具及需要碰撞互動的圖形團隊,PhysSkin 更適合用作研究原型或既有 rig 的物理補強。配套的 PhysSkin++ 描述進一步延伸至 meshes、point clouds、NeRFs 和 3D Gaussians,但這些能力不應直接當成本 GitHub 項目中同一 checkpoint 已完整提供的功能。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, 工具, 3D, Python, 動畫

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

FocusGUI 自動揀對的訊息做 GUI 代理

南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

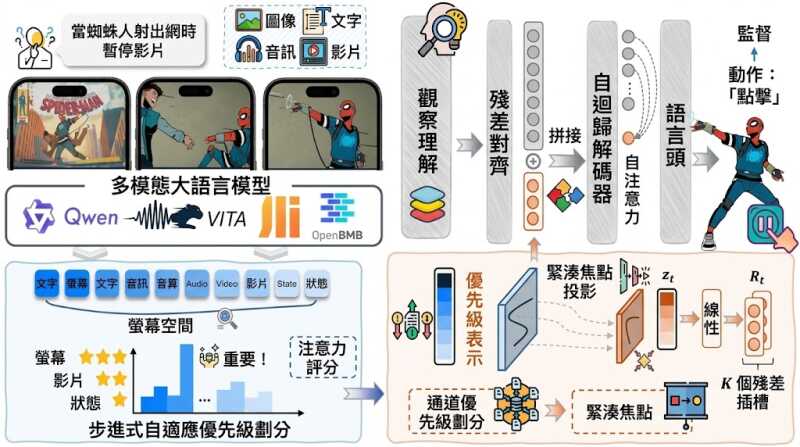
FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

Page 3 of 55
1 2 3 4 5 … 55