擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。
SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。
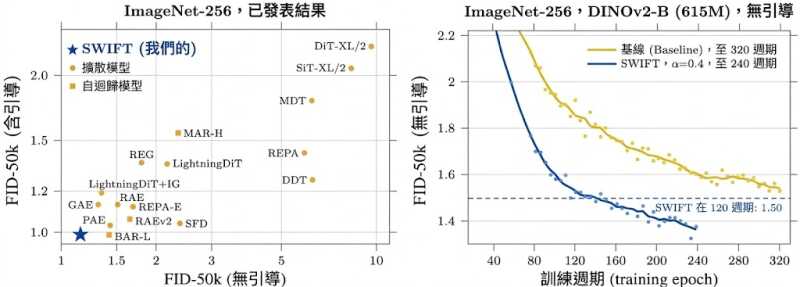
在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。
- 以凍結的弱去噪模型估計訓練偏差方向。
- 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
- 保留原有模型架構、損失設定及採樣器。
- ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。
這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。