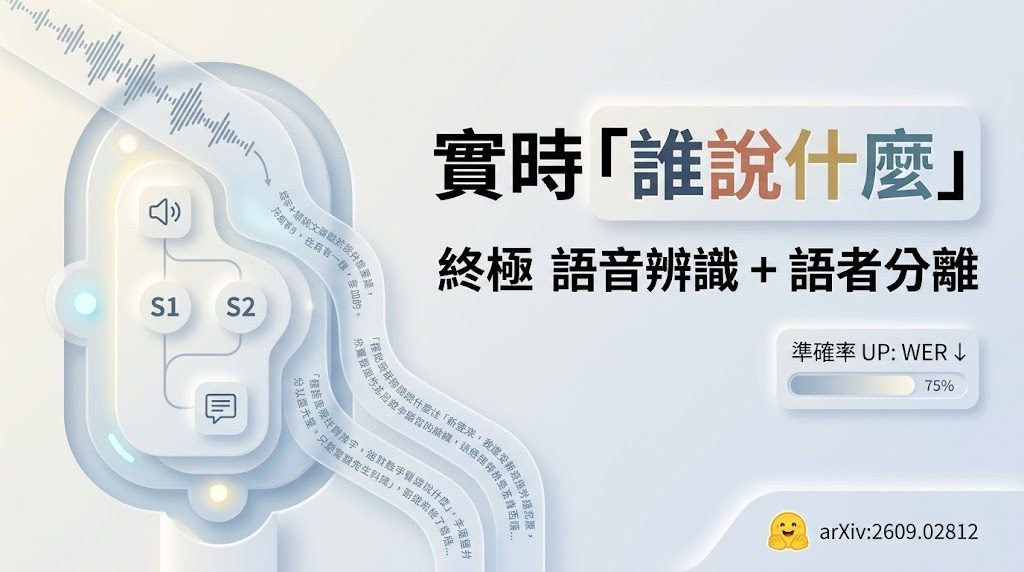
Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。
模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。
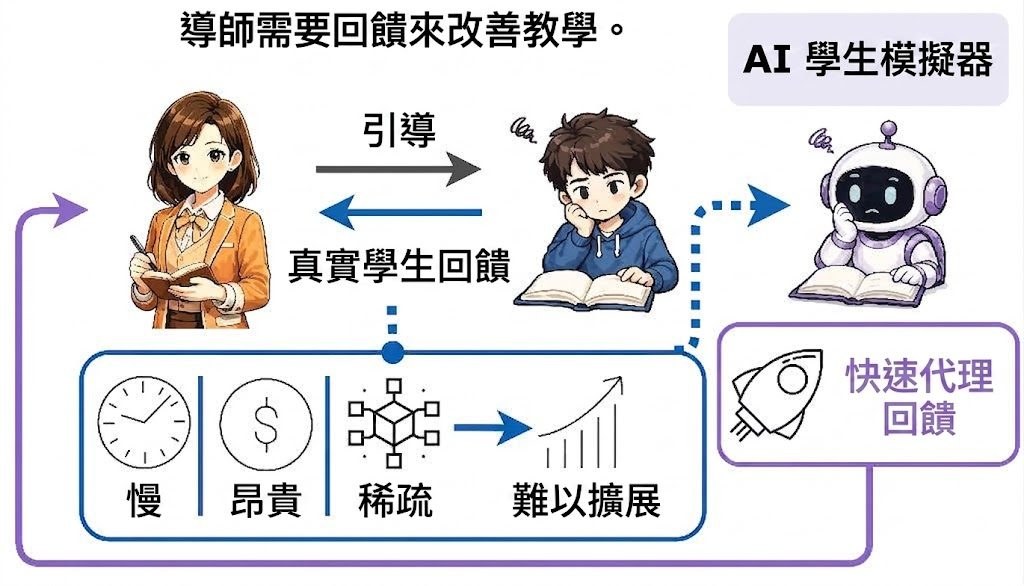
StudentSim 是一個由 Microsoft 研究的工具套件,核心是替每位學生建立獨立模擬器,解決「真實學生回饋太慢、太少、太貴」這個輔導優化難題。它先從多名學生的資料做 pooled training,再針對單一學生做 specialization,讓模擬器不只答得像,還要在收到指導後出現和原學生相近的變化。
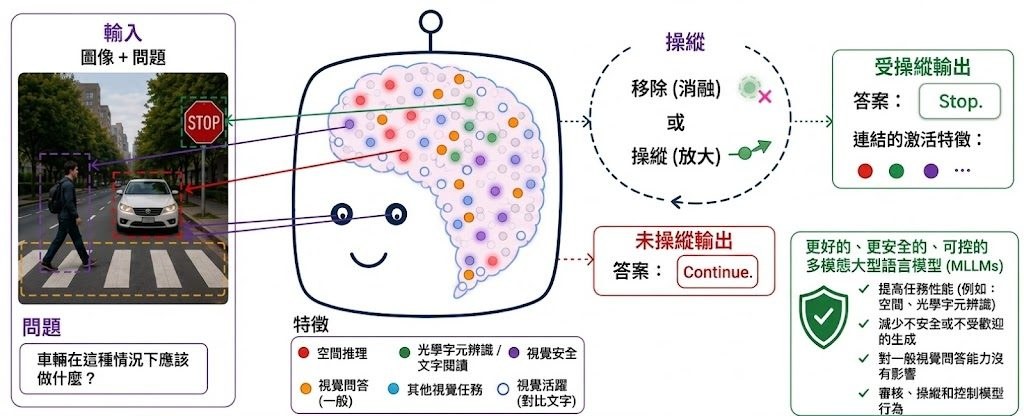
MMDiff(Multimodal Model Diffing)係一套研究型方法,處理嘅問題唔係再訓練模型,而係先睇清楚多模態大型語言模型(Multimodal Large Language Models, MLLMs)入面邊啲特徵因為視覺訓練而改變,再將呢啲特徵移除或引導。對要做審核、除錯、對齊行為嘅團隊,呢種做法比單靠黑盒輸出更實用。