VideoRLVR:教影片模型學會推理

這個項目把強化學習帶入影片推理訓練,重點是用可驗證獎勵提升解題能力。對想研究生成式影片與推理結合的人特別值得留意。

Repository image for luka-group/VideoRLVR

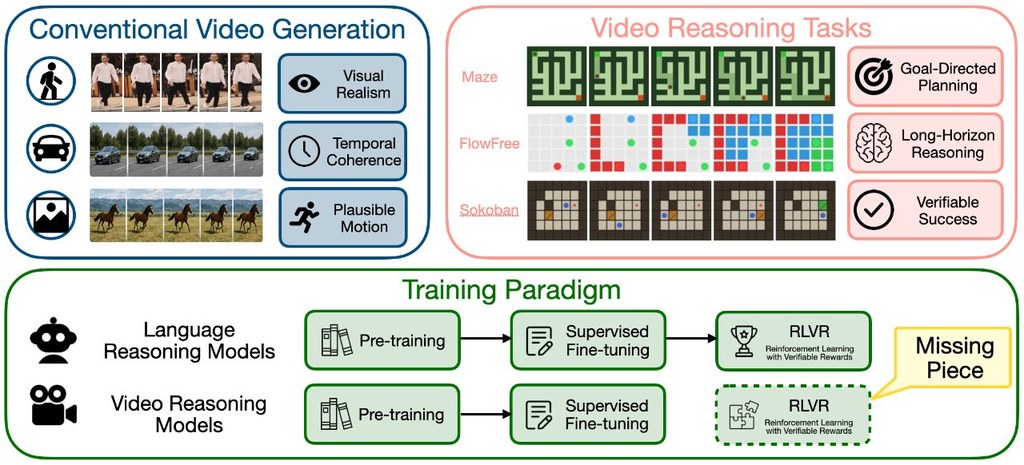
VideoRLVR 是一個用來訓練影片推理模型的項目,核心做法是把強化學習加入影片生成流程,並用「可驗證」的獎勵來判斷答案是否正確。簡單說,它不是只追求畫面像真,而是希望模型在生成影片時,連帶表現出可檢查的解題能力。

這個項目目前圍繞 Wan2.2-TI2V-5B 展開,並以 Maze、FlowFree、Sokoban 這類有明確規則的任務作為訓練與評估場景。這類設計的好處,是模型表現不只靠主觀觀感,而是可以透過任務成功與否來量度,對研究推理能力特別重要。

要理解這個項目,可先由它提供的資源入手:公開集合內有 SFT 與 RLVR 檢查點,也有訓練及測試資料。程式結構亦分開了訓練、推論與評估腳本,並提供多任務及單一任務版本,方便比較不同設定下的結果。

  • 重點放在可驗證獎勵,比只看主觀生成質素更易評估
  • 以 Wan2.2-TI2V-5B 為基礎,提供 SFT 與 RLVR 相關模型
  • 任務涵蓋 Maze、FlowFree、Sokoban,偏向規則清晰的推理測試
  • 已整理模型與資料集到 Hugging Face,查找資源較方便

這個項目的新意,在於把影片生成與可量化的推理訓練更緊密地結合,並且明確提供一套可重複的訓練配方。從 README 可見,它亦包含多任務訓練、純成功訊號版本,以及 OOD 推論與評估腳本,表示作者不只關心是否學會指定題目,也在意模型離開熟悉分佈後的表現。

適合留意這個項目的人,包括研究多模態模型、影片生成、強化學習,或想觀察模型如何在規則環境中表現推理能力的開發者。至於性能數字,這份儲存庫摘要未展示完整量化結果,因此較穩妥的看法是:它的價值目前更偏向研究方法、訓練流程與公開資源,而不是單靠一兩個分數定勝負。
GitHub: https://github.com/luka-group/VideoRLVR

Paper: https://arxiv.org/pdf/2605.15458

Categories: 開源, 視覺模型, 微軟, 深度學習

InsightTok:令生圖文字人臉更清晰

這個專案專注改善生成圖片中最易失真的文字與人臉細節。對已有自回歸生圖流程的人來說,特別有參考價值。

Method

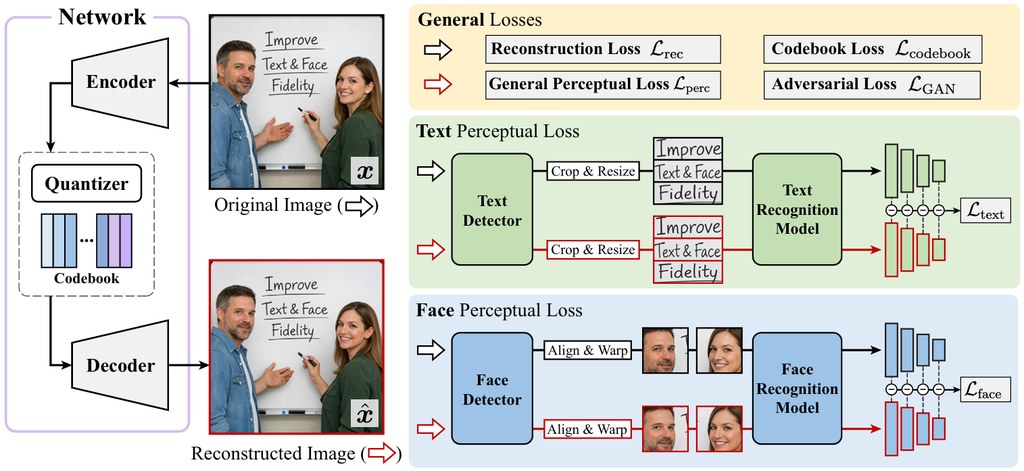
生成圖片時,最常令人出戲的往往不是背景,而是招牌上的字、海報上的字句,或者人臉五官的細節。InsightTok 針對的正正是這兩個難位:它不是直接改整個生圖模型,而是先改善圖片被「拆解成代碼」的方式,讓後續生成時更易保留重要內容。

實際使用上,這類專案較適合已經在做文字生成圖片、研究離散視覺 tokenization,或使用自回歸圖像生成流程的開發者與研究者。重點在於把原有流程中的視覺 tokenizer 換成 InsightTok 這一類方案,後面的生成模型理論上毋須大改,對現有管線算是較容易接入。

它的特別之處,在於沒有只用一般重建目標,而是更有意識地照顧局部而且重要的內容,例如文字區域與人臉區域。根據儲存庫提供的說明,它在相同壓縮率下,能做到更好的文字與人臉重建,同時只用 16× downsampling 和 16,384 個條目的 codebook,額外訓練成本亦相對有限。

  • 主要改善圖片中的文字可讀性人臉細節還原
  • 可兼容標準自回歸圖像生成流程,毋須連下游模型一併重寫
  • 在相同壓縮條件下,重建效果主打更清晰、更忠於原圖
  • 設計上延續 VQGAN 風格 tokenizer 思路,但加強重點區域 supervision
  • 相關脈絡包括離散視覺 tokenizer、VQGAN 風格方法,以及文字生成圖片模型

整體來看,InsightTok 吸引之處不在花巧功能,而在於它抓到生圖最常被批評的痛點,再用相對務實的方法補強。對一般讀者來說,可以把它理解成一個「令 AI 更識得保住字同樣貌」的底層零件;對技術團隊而言,它較像是一個可直接提升畫面可用性的基礎組件。

GitHub: https://github.com/LeapLabTHU/InsightTok

Paper: https://arxiv.org/pdf/2605.14333

Categories: 開源, 清華大學, 視覺模型, 視頻模型, 微軟, 中國

VibeVoice:前沿開源文字轉語音模型

VibeVoice 是一個開源,能將文字內容轉化為自然流暢、多角色對話音訊的框架工具。它擁有充滿情感與生命力的聲音。VibeVoice 不僅僅是一個文字轉語音 (TTS) 模型,它更是一個解決傳統 TTS 系統在可擴展性、說話者一致性及自然輪流對話方面重大挑戰的創新框架,特別適用於生成播客等長篇、多說話者的對話音訊。 VibeVoice 的核心創新之一,在於其採用了連續語音分詞器(聲學和語義),並以超低 7.5 Hz 的幀率運行。這些分詞器能有效地保留音訊保真度,同時顯著提升處理長序列的計算效率。此外,VibeVoice 採用了「下一詞元擴散」框架,巧妙地利用大型語言模型 (LLM) 來理解文本語境和對話流程,再透過擴散頭生成高保真度的聲學細節。這使得模型能夠合成長達 90 分鐘的語音,並支援多達 4 位不同的說話者,遠超許多先前模型通常僅限於 1-2 位說話者的限制。

VibeVoice 是一個開源,能將文字內容轉化為自然流暢、多角色對話音訊的框架工具。它擁有充滿情感與生命力的聲音。VibeVoice 不僅僅是一個文字轉語音 (TTS) 模型,它更是一個解決傳統 TTS 系統在可擴展性、說話者一致性及自然輪流對話方面重大挑戰的創新框架,特別適用於生成播客等長篇、多說話者的對話音訊。

VibeVoice 的核心創新之一,在於其採用了連續語音分詞器(聲學和語義),並以超低 7.5 Hz 的幀率運行。這些分詞器能有效地保留音訊保真度,同時顯著提升處理長序列的計算效率。此外,VibeVoice 採用了「下一詞元擴散」框架,巧妙地利用大型語言模型 (LLM) 來理解文本語境和對話流程,再透過擴散頭生成高保真度的聲學細節。這使得模型能夠合成長達 90 分鐘的語音,並支援多達 4 位不同的說話者,遠超許多先前模型通常僅限於 1-2 位說話者的限制。

(more…)
Categories: 開源, 微軟, 語音

MAI-Voice-1 微軟 AI 新紀元

MAI-Voice-1 是一種速度極快的語音生成模型,能夠在單個 GPU 上不到一秒的時間內生成一分鐘的音頻,使其成為當今最高效的語音系統之一。MAI-Voice-1 現已支援我們的 Copilot Daily 和 Podcasts 功能。也在 Copilot Labs 中推出MAI-Voice-1,您可以在那裡試用富有表現力的演講和故事演示。想像一下,只需一個簡單的提示,您就可以創作一個「選擇你自己的冒險」故事,或自訂一個有助於睡眠的引導式冥想。快來嘗試一下吧! 微軟從巨型模型到輕量級智慧,創新雙管齊下。正積極推動其基礎模型(foundation models)的創新,並為此推出了兩款重要的內部開發模型:超大型的 MAI-1,以及輕巧高效的 Phi-3 系列模型,展現了其在AI策略上的深遠佈局。

MAI-Voice-1 是一種速度極快的語音生成模型,能夠在單個 GPU 上不到一秒的時間內生成一分鐘的音頻,使其成為當今最高效的語音系統之一。MAI-Voice-1 現已支援我們的 Copilot Daily 和 Podcasts 功能。也在 Copilot Labs 中推出MAI-Voice-1,您可以在那裡試用富有表現力的演講和故事演示。想像一下,只需一個簡單的提示,您就可以創作一個「選擇你自己的冒險」故事,或自訂一個有助於睡眠的引導式冥想。快來嘗試一下吧!

微軟從巨型模型到輕量級智慧,創新雙管齊下。正積極推動其基礎模型(foundation models)的創新,並為此推出了兩款重要的內部開發模型:超大型的 MAI-1,以及輕巧高效的 Phi-3 系列模型,展現了其在AI策略上的深遠佈局。

Categories: 模型, 微軟, 語音

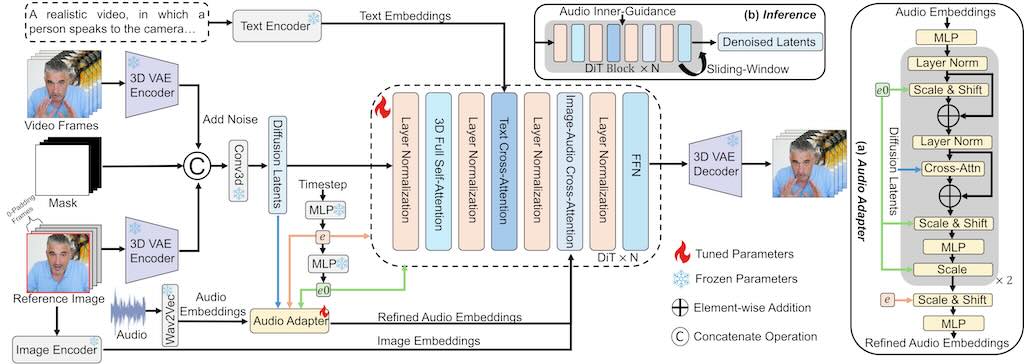
StableAvatar:無限長音訊驅動的頭像影片生成

用於音訊驅動頭像視訊產生的擴散模型難以合成具有自然音訊同步和身份一致性的長視訊。基於 Wan2.1-1.3B 的 StableAvatar 音訊驅動的頭像視訊效果,是首個端到端視訊擴散變換器,無需後製即可合成無限長的高品質視訊。

用於音訊驅動頭像視訊產生的擴散模型難以合成具有自然音訊同步和身份一致性的長視訊。基於 Wan2.1-1.3B 的 StableAvatar 音訊驅動的頭像視訊效果,是首個端到端視訊擴散變換器,無需後製即可合成無限長的高品質視訊。

Categories: 開源, 騰訊, 數字人, 微軟

Page 3 of 3
1 2 3