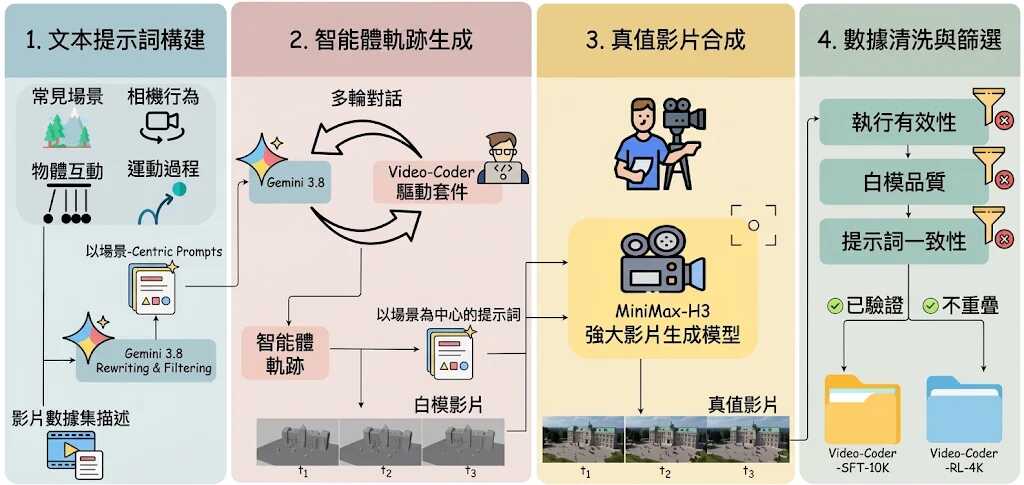
影片生成遇到物件互動、鏡頭運動或物理效果時,單靠文字直接生成往往難以穩定控制。Video-Coder 以 coding agent 身份編寫並執行 Blender Python,建立 3D 場景及 Draft Video,再把物件位置、動作和鏡頭資訊交給下游影片生成器;項目屬於影片生成代理項目,處理的是生成結果缺乏明確結構與物理約束的問題。
核心流程放在 Video-Coder Harness:代理會寫程式、執行、檢查結果,再按回饋修改程式。模型先以 supervised fine-tuning(SFT)訓練,之後接受 harness-native agentic reinforcement learning(RL);執行獎勵會逐步轉向影片獎勵,令程式能夠產生可用的場景草稿。Video-Coder-9B 建基於 Qwen3.5-9B,並可配合不同 Video generators。
- 以可執行 3D 程式補強直接文字生成
- Draft Video 提供結構、動作與鏡頭訊號
- 同時提供 SFT、RL 訓練流程及訓練資料
- Video-Coder-9B 配合 MiniMax-H3 可提升物理相關評分
評測結果顯示,Video-Coder-9B + MiniMax-H3 在 PhyGenBench 平均取得 0.67,高於 MiniMax-H3 的 0.61;VBench-2.0 平均為 78.19%,較單獨使用 MiniMax-H3 的 54.58% 高 23.61 個百分點。Mechanics 分數達 88.67%,但這些結果依賴特定模型組合,未必能直接代表所有影片生成器的效果。
項目提供 Video-Coder-9B、Video-Coder-SFT-9B 模型及 Video-Coder-train-data,並列出 SFT 和 RL 的 Python 3.12 環境設定方向;提供的資料未包含完整推理流程,訓練指令亦在輸入內容中截斷。研究團隊、影片模型開發者及需要精確控制物件互動的創作者,較容易從這套程式驅動流程受益,但使用者需要準備 Blender、模型推理及訓練所需的運算資源。