語音複製要落地,難處往往不在模型能否說話,而在聲音能否即時產生、私密保留,以及部署是否依賴昂貴伺服器。ZONOS3-Mini 是一款零樣本 Text-to-Speech(TTS,文字轉語音)模型,正把這些條件放到同一個較輕量的設計裡。
它的總參數量約 8 億,但每次推理約啟動 1 億個參數;架構結合 gated-DeltaNet 與每四層一組 global attention,再以 latent Mixture of Experts(MoE)節省計算。模型輸出 dual-codec 音訊碼,再由因果式 multi-resolution iSTFT 解碼器轉成 44.1 kHz 聲音。
- 聲音來源:可用短參考片段直接複製,也可配合 192 維 MECT-B2 speaker embedding。
- 文字處理:採用 SuperBPE 文字 token,支援多語言輸入及文字正規化。
- 部署路徑:NVIDIA GPU 可用 CUDA,Apple Silicon Mac 可用 MLX,一般裝置則可選 ggml。
- 瀏覽器版本:透過 WebGPU 在瀕覽器內執行,不需安裝伺服器。
- 介面統一:各後端沿用相同 HTTP API,可配合 Zonos Voice Studio 或離線 Python API。
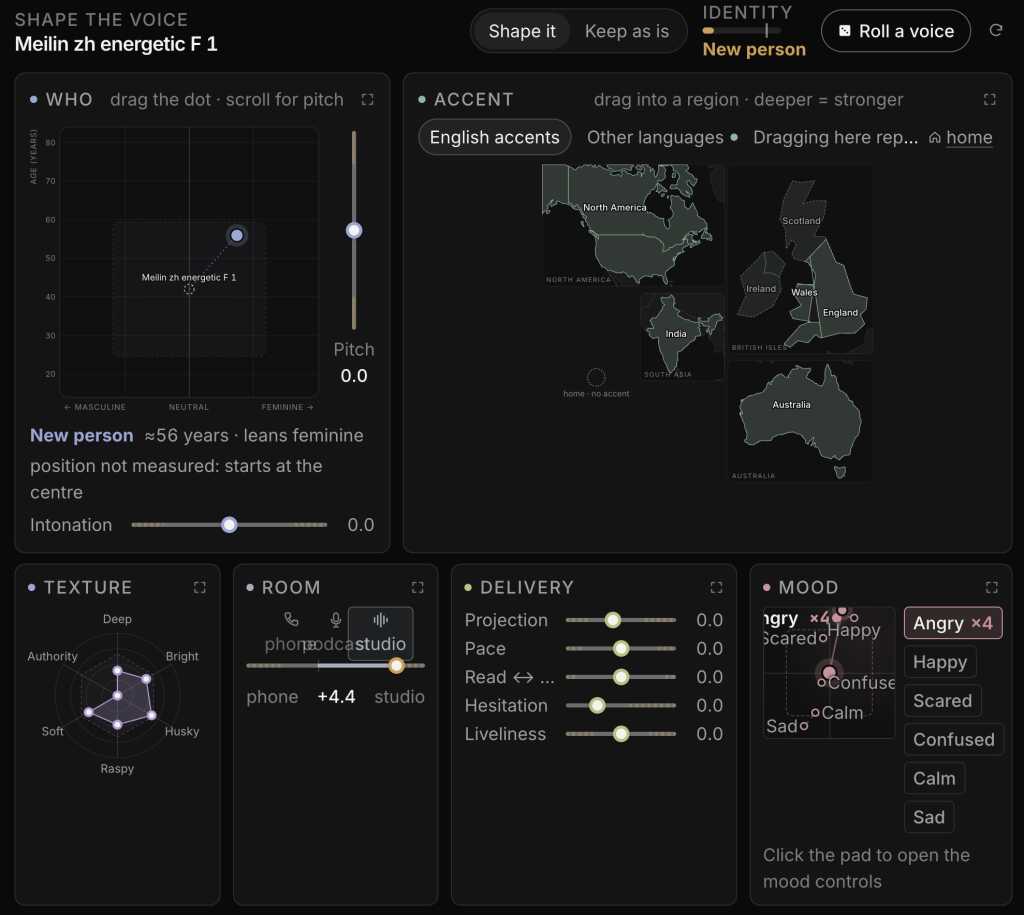
與 ZONOS2 相比,ZONOS3-Mini 的取捨很明顯:前者以 8B 參數及 86 Hz codec 換取品質與推理表現,新版則把總量、編碼頻率與運算成本一併壓低。代價是它仍屬較新的小模型,實際語氣、跨語言一致性與長時間朗讀質素,仍須按應用場景自行比較,而不能只靠模型規模判斷。
團隊稱模型使用 112 張 NVIDIA H100 訓練 2.5 天,並提供 ZTTS2-Eval 等評測入口。對內容製作、遊戲原型、語音助理及需要本機處理的團隊而言,ZONOS3-Mini 的吸引力在於聲音素材不必長期寄存在雲端;惟正式採用前仍應測試目標語言、版權與參考錄音品質。