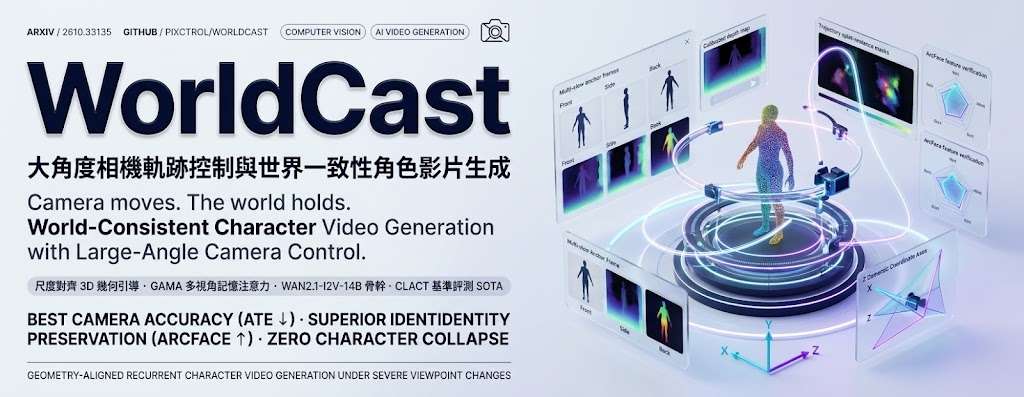
只提供一張參考圖、目標鏡頭軌跡,以及 1 至 4 張不同視角的角色錨點圖,WorldCast 便能生成跟隨多角度運鏡的角色影片,同時減少轉換視角時身份走樣。這個開源模型項目針對的是影片生成中「鏡頭要郁得大」與「角色外觀要保持」難以兼顧的問題。
它以 Wan2.1-I2V-14B-720P 作為基礎模型,再加入 scale-aligned geometric guidance 和 Geometry-Aligned Memory Attention(GAMA)。前者把初始畫面轉成具校準深度的彩色 3D 點雲,沿目標軌跡渲染出 RGB 引導與 coverage mask;後者透過 Umeyama alignment 對齊多視角角色記憶,將相關特徵注入影片 token,補足新視角內容。
- 支援 360° 鏡頭移動
- 使用多視角 anchor images 維持角色身份
- CLACT 包含 80,000 個訓練樣本及 42 個評測場景
- 以 ATE、MEt3R 和影像品質比較結果
GitHub 已提供 inference code 和示範案例,但 WorldCast checkpoint、CLACT dataset 及 training code 尚未公開,因此下載 Wan2.1 基礎權重後仍未能完整執行示範。推理建議使用 Python 3.10 或以上、bf16,以及至少 48 GB 顯存;解析度和影片幀數提高後,記憶體需求亦會增加。
結果以較低的 ATE 和 MEt3R 對應更準確的鏡頭控制及跨視角一致性,影像質素則維持具競爭力。電影預視、角色廣告、遊戲過場及需要指定運鏡的生成影片工作流較適合採用。