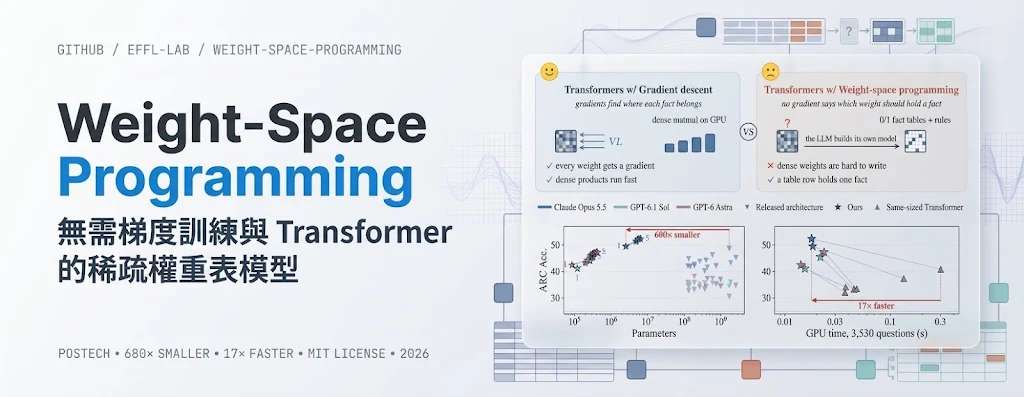
權重可以直接寫,卻未必需要 Transformer。Weight-Space Programming(WSP)是研究項目,讓大型語言模型(LLM)直接編寫目標模型的權重,不經 gradient training。研究把問題轉向知識如何存放:當權重由 LLM 決定,模型能否用更容易追查的結構回答問題?
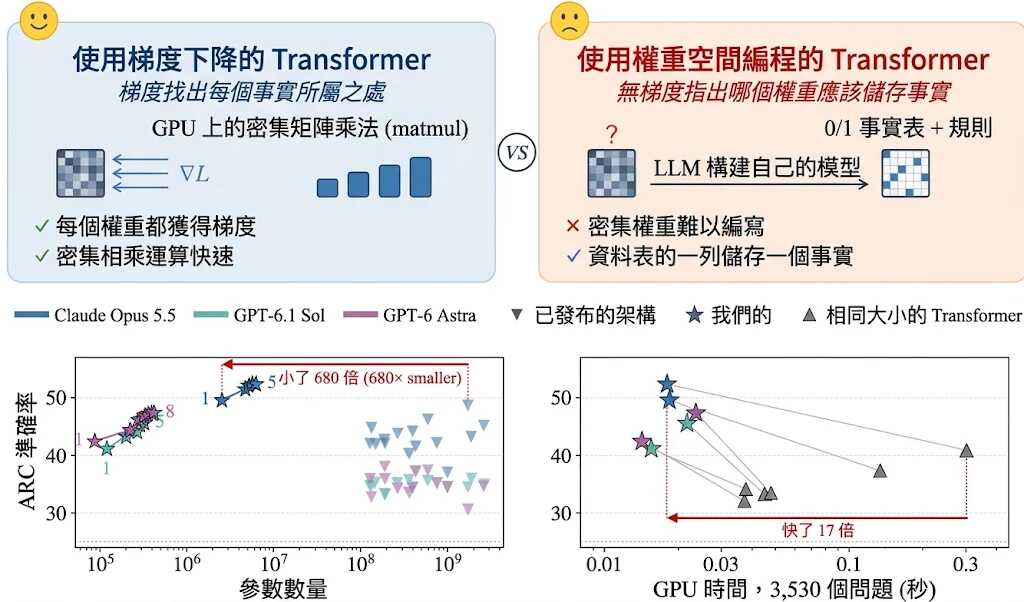
研究讓 Claude Opus 5.5、GPT-6.1 Sol 和 GPT-6 Astra 擔任 writer,即負責寫模型的一方。三者各獲十道附答案的 ARC 題目及 sandbox,這個隔離執行環境讓它們測試程式。實驗容許它們填寫固定架構的權重,或自行設計模型,藉此檢視限制是否來自指定架構。
| LLM(writer) | 自由設計模型的 ARC 準確率 | 主要差異 |
|---|---|---|
| Claude Opus 5.5 | 50.8% → 54.4% | 將一句事實同時作為 key 與 value |
| GPT-6.1 Sol | 44.6% → 47.4% | 寫成「線索 → 答案」配對 |
| GPT-6 Astra | 42.7% → 46.2% | 寫成「情境線索 + 支持/反駁答案」 |
設計時,三者都把詞語映射至 concepts,再將文字事實編譯成 sparse tables,即只記錄相關概念的稀疏表。回答時,模型為每個選項找出最匹配的幾行,再加入手寫規則評分。三者的資料分法不同:Claude 用同一句子兼作查找線索和內容,Sol 分開線索與答案,Astra 則記錄支持和反對哪些答案。writer 也會在 sandbox 自編練習題,檢查錯誤後補寫資料行或規則。
採用資料表的理由,是讓錯誤能追溯至具體一行,並檢查修改會否牽連其他答案。Claude 的模型每個選項只保留最佳資料行,表現仍接近完整模型;刪除一行平均改變 0.5 至 1.8 個答案。手寫 Transformer 的對應數字為 4.8 及更多,說明兩種結構的修改影響範圍不同,但資料表仍未做到修改完全互不影響。
- 權重由 LLM 直接編寫,目標模型不經 gradient training。
- 自由設計的模型以文字事實建表,再按題目與選項查找。
- 錯誤可追查至資料行,但刪改仍可能影響其他答案。
- 架構比較限於這套手寫權重流程,不能推廣至所有模型。
ARC test 包含 3,530 題,隨機猜測準確率為 25%。Claude 設計的模型在 generation 5 達到 54.4%;另有一個自由設計模型,超越同一 LLM 寫出的最高準確率 released Transformer,參數約少 1,800 倍。這個比較支持「手寫權重未必要沿用 Transformer」,但不能解讀成它勝過經一般訓練的 Transformer,因為比較對象同樣由 LLM 寫入權重。
模型在這批 ARC 題目中仍有相當部分答錯,不能直接當作可靠的科學問答服務。當題目需要表中未涵蓋的事實,或概念未能匹配,查表流程便可能失去足夠依據;項目沒有提供這類情況的獨立結果。需要逐條核對知識的研究團隊,可以從資料行追查問題,但仍須自行測試目標題目。
跑前要準備 Linux、Python 3.11、bubblewrap bwrap,以及 requirements.txt 指定的依賴。讀者可先用 harness.score_model 建立 models/ 內的模型,在隔離環境中對 ARC validation 和 test 評分,再核對 result.json。若要讓 writer 產生新模型,還需 Claude Code CLI 及已登入的 profile;WSP_DATA_ROOT 必須設定,否則首次使用會報錯。
硬體需求要按實驗路線分開看:edited lm-* checkpoints 的評分需要一張 CUDA GPU,而 2B 至 2.6B 模型的起始準備曾使用 64 GB RAM。