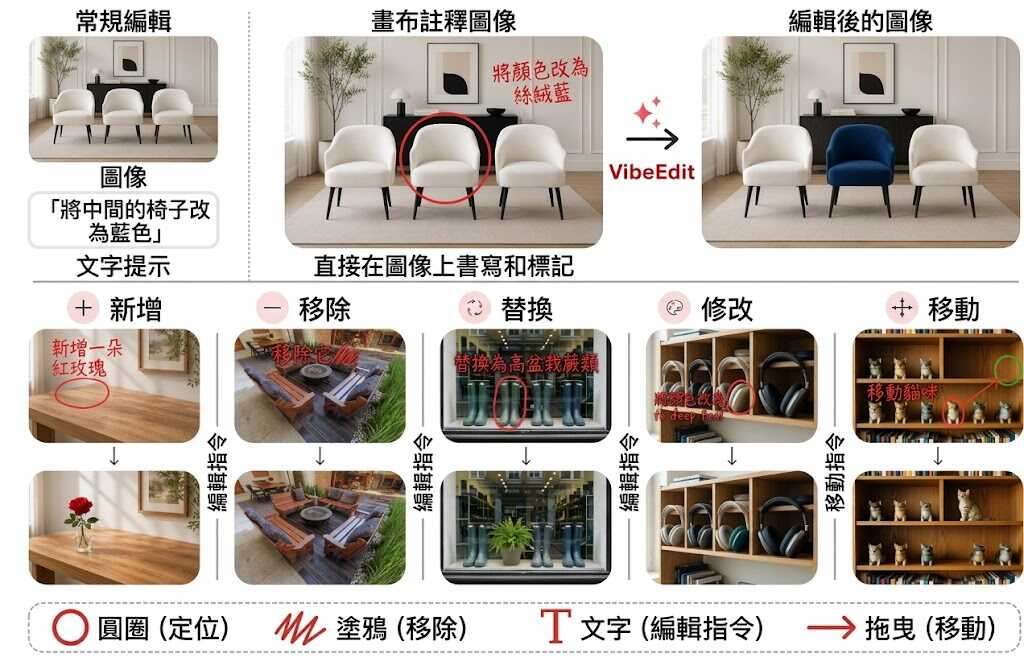
圈選物件、畫幾筆線,或在圖片上拖動指定位置,再補上一句短註記,便能要求模型新增、移除、替換、改變屬性或移動內容。VibeEdit 屬於影像編輯模型,處理的是文字提示難以準確指出相似物件和局部區域的問題。
它採用 Qwen-Image-Edit,以 layer-decoupled conditioning 分開編碼原圖與 canvas instruction,再配合 region-weighted supervised fine-tuning,以及 rubric-guided reinforcement learning(RL)改善局部修改、指令完成度和未編輯區域的保留。訓練資料包含 155 萬組 source–target edit pairs、物件遮罩和結構化編輯描述,畫布指令則由這些資料生成。
- 支援新增、移除、替換、屬性修改及移動物件
- 不要求獨立文字提示,空間標記直接表達目標位置
- 以 419 個人工整理案例測試相似物件選取能力
- VLM(Vision-Language Model)評分為 79.9,outside-region PSNR 為 32.8 dB
- 對比 FireRed 的 67.4 分及 24.0 dB,局部編輯和區域保留均較佳
對需要精準修圖的設計、內容製作和研究團隊,畫布指令比長篇描述更容易表達「改哪一件」;但模型仍屬研究項目,程式碼標示為 Coming soon,暫時不能按儲存庫直接安裝或自行重現。評測規模亦只有 419 個案例,結果未必涵蓋所有圖片類型和複雜編輯情境。