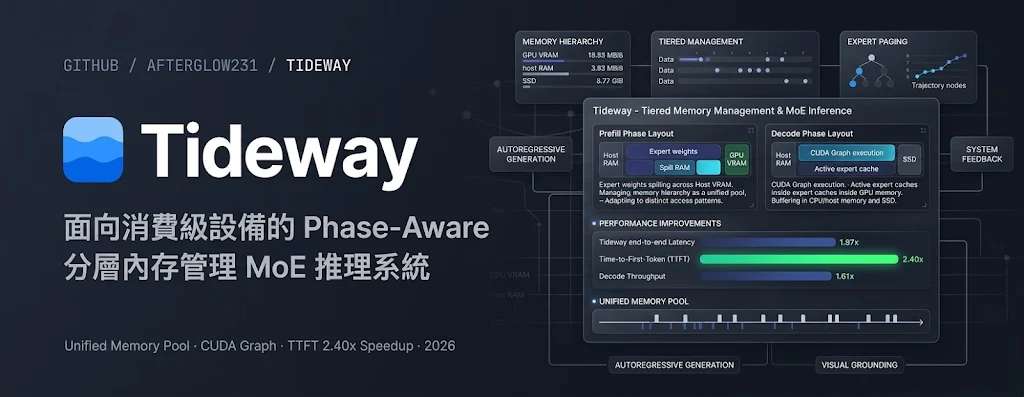
模型裝得下,回覆仍可能卡在搬運。Tideway 是面向個人電腦的推理系統,協調 GPU VRAM、主機 RAM 與 NVMe SSD,處理 MoE 模型權重超出記憶體的問題。在 RTX 5090、32 GB VRAM、48 GiB RAM 下,Qwen3.6-35B-A3B 的 TraceLab 全程加速達 3.14×,相對各設定最快 baseline,也是表內該欄最高值。
MoE 會按輸入選用不同 experts,即負責部分運算的模型組件。Tideway 改善的是組件搬運與執行安排,模型本身仍須另行提供。項目文件批評各層獨立 cache 加固定配置的做法:讀取長提示時反覆從 SSD 載入權重,逐字生成時又因缺少 expert,退回開銷較高的逐步執行。
項目測試涵蓋 Qwen3.6、Gemma4 及 DeepSeek-V4-Flash 的指定版本,並與 FreeToken、llama.cpp 等引擎比較。不過,提供的表格只有欄名,缺少各項結果,無法核對摘要所報加速幅度及各條件下的最快基準。
下面為 OpenMausBot + Remotion 根據原片做的中文版
Tideway 把 VRAM 與 RAM 當成由 SSD 支援的統一空間,先回收跨層重複副本。GPU 逐出某個 expert 時,系統也會利用閒置 PCIe 通道,選擇性將唯一副本送回 RAM。這樣安排是為了容納更多不同 experts,減少日後重新讀取 SSD;代價是系統必須持續管理組件位置與搬運時機。
讀取提示的 prefill 階段與逐字生成的 decode 階段,存取模式並不相同,因此系統會在兩者交界切換配置。prefill 會借用 VRAM 輪流載入權重,同時固定 RAM 內可重用的 experts,防止掃描整個模型時把它們逐出。進入 decode 後,系統解除固定,並把借用空間改回地址固定的 expert cache,讓生成階段按需要補入組件。
只減少 SSD 讀取仍不足以消除 GPU 等待。Tideway 在計算當前層時,同步傳送下一層權重;decode 則使用分段 CUDA Graphs,即重播預先記錄的 GPU 運算步驟。主機把缺少的 experts 搬入固定位置,再接續重播下一段,毋須因組件位置變動而重新記錄整套運算。
TraceLab 的多輪編程智能體測試,更接近反覆讀提示、生成答案的工作流。以下均使用 RTX 5090 的 32 GB VRAM,數字是相對各設定最快 baseline 的全程加速:Qwen3.6-35B-A3B 使用 BF16,權重為 67 GiB;RAM 為 64 GiB 時達 1.20×,48 GiB 時達 3.14×,32 GiB 時達 2.04×。因此,加速幅度並非隨 RAM 減少而持續增加,不能把最高值套用到所有桌面配置。
同一測試中的 Gemma4-26B-A4B 使用 BF16,權重為 48 GiB;RAM 為 48 GiB 時達 1.51×,32 GiB 時達 1.47×,16 GiB 時達 2.66×。DeepSeek-V4-Flash 使用 FP4,權重為 155 GiB;RAM 為 128 GiB 時達 1.31×,96 GiB 時達 1.64×,64 GiB 時達 1.69×。這些模型是測試對象,各自的權重大小與格式不同,不能把差距單純歸因於模型名稱或 RAM 容量。
比較組包括 FreeToken、llama.cpp、SSD-LLaMA 與 FlashMoE;後兩者是已發表機制的獨立實作。長提示令大量 experts 輪流被讀取、或生成時所需組件仍在 SSD,搬運就仍會直接拖慢回覆,Tideway 只能減輕這個瓶頸。資料未列明 NVMe SSD 型號、固定形狀測試的輸入輸出長度,以及各設定的絕對延遲,因此倍數不能直接換成使用者要等多少秒。
準備本地編程智能體測試的團隊,需要 Linux、Python 3.12+、NVIDIA GPU、CUDA 13 toolkit 與 GCC,並另備模型檔案及 NVMe SSD。安裝項目後還要編譯 backend,再於載入 FreeToken 前呼叫 tideway.activate_backend();隨附整合基於 FreeToken 0.1.2,提供資料未交代發布節奏或 issue 活躍度。下一步應用自己的提示與多輪任務測量完整等待時間,分開記錄開始回覆前及逐字生成時的延遲,再決定記憶體配置。