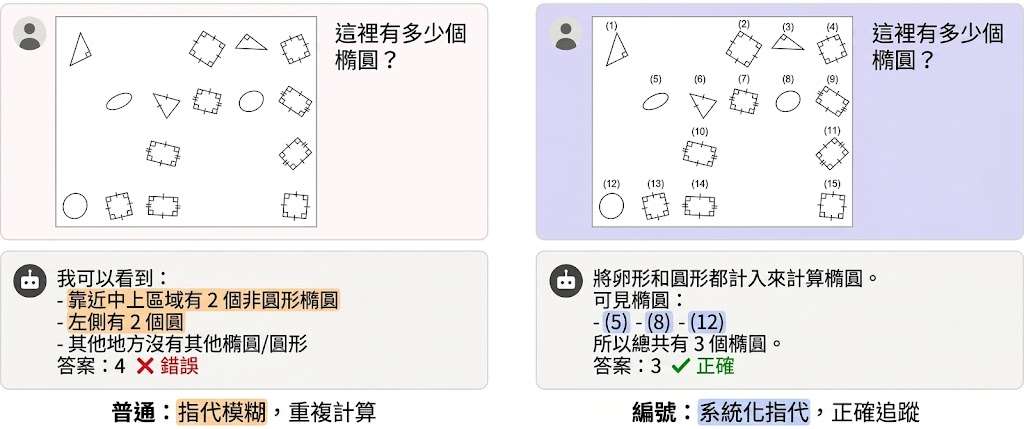
模型明明看見圖中所有物件,數數時卻會重複計算;ReGap-Bench 是一個針對 multimodal large language models(MLLMs)的資料集與評測項目,專門檢查語言推理能否正確對應視覺中的物件、區域和位置,並將問題命名為 reference gap。
它把同一場景、問題和答案固定,只更換額外參照,形成 paired reference-intervention benchmark。編號讓物件可以被索引,陰影標示有界區域,網格線則協助定位、追蹤邊界和比較位移;參照是否配合任務,會直接影響推理結果。
- 涵蓋 shape counting、angle ranking、size ranking、clock ranking 和 transformation prediction 五項任務
- 共 200 個場景及 3,400 張圖片,設有 plain、numbering、shading 和 grid 條件
- task-matched references 可令所有受測模型在所有任務提升,最高達 25%
- mismatched references 幫助有限,甚至會令表現下降
測試可用 OpenAI、Google Gemini API,亦可透過 vLLM 執行 Qwen3.5;後者需要 GPU,API 模型則只需設定相應金鑰。Python 3.10 環境和 requirements 已列明,輸出會保存到 outputs,方便比較同一模型在不同參照條件下的差異。
ReGap-Bench 的價值不在於再加一個總分,而是把視覺感知和語言推理之間的接合問題單獨拉出來。結果支持一個務實判斷:改善模型未必只靠更強的視覺編碼器,為任務建立合適的外部視覺參照,也可能成為不需重新訓練的 visual skill;不過參照錯配會反過來干擾模型,因此它更適合研究團隊、MLLM 評測人員和需要分析多步視覺推理失誤的開發者。