當新問題只改動日期、篩選條件或報表維度時,重新由自然語言生成整條 SQL 往往會重複消耗推理資源,也可能丟失原有的 join 或計算邏輯。MEM-SQL(Memory-Empowered Text-to-SQL)針對這個場景重用同一資料庫中已驗證的查詢歷史;它不是一個可直接下載的模型權重,而是一套配合 language models 運作的記憶式 Text-to-SQL 方法。項目文件沒有提供可確認的 base model、參數規模、微調方式或 GGUF 量化檔案,因此不能把它當作某個具體模型的 fine-tune 版本介紹。
它的價值集中在準確度與生成成本之間的取捨。HARE(History-AwaRe Text-to-SQL BEnchmark)包含 1,600 項請求,源自四個 datasets 中固定的 823 條已驗證查詢;每項註釋記錄保留了哪些查詢組件、需要哪些修改,並區分整條查詢改編與部分重用,讓測試不再只問「能否由零生成正確 SQL」。在六個 language models 上,Direct Generation 的平均執行準確度為 37.1%,MEM-SQL 提升至 50.0%,平均輸入 tokens 減少 76.6%,平均延遲降低 68.8%。
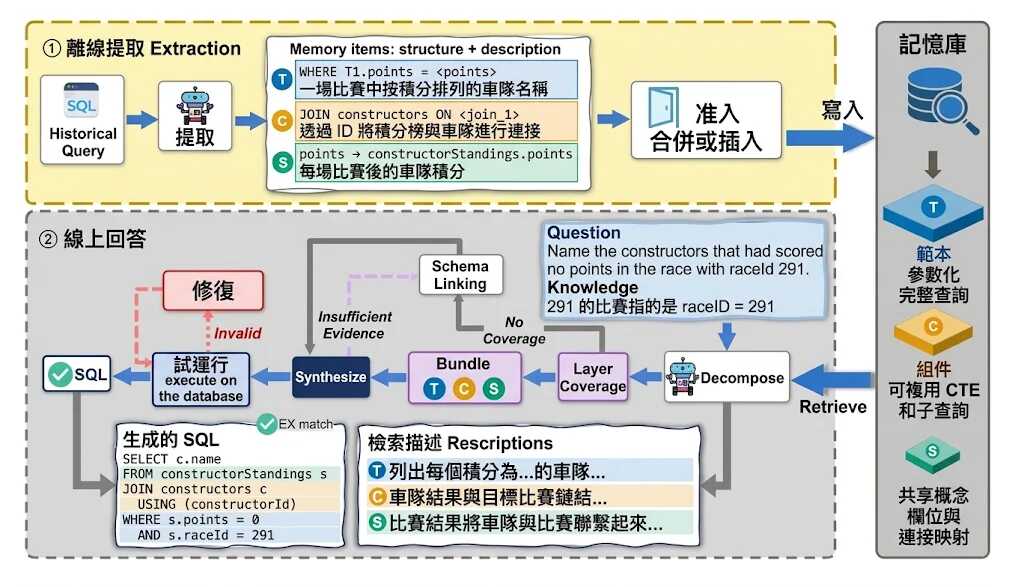
MEM-SQL 的記憶分成三類:整條查詢範本、可重用的 SQL 區塊,以及由領域概念對應至資料庫結構元素的映射。系統不會盲目採用最細碎的記憶,而是按層次檢查條件;只有當某一層所需的每項要求都找到高於該層門檻的匹配,才會使用該層。這個設計讓「整條查詢可以直接改編」與「只能抽取部分 join 或計算」有清楚區分,也減少把不完整證據硬塞進新查詢的風險。
OSL(On-demand Schema Linking)再補上一個按需要查閱資料庫結構的機制。當沒有任何記憶層符合條件,或生成器判斷檢索到的證據不足時,系統才會查閱 schema;換句話說,schema linking 不再預設覆蓋每個請求。研究把 OSL 套用到另外三種 memory designs,生成成本均有所下降,但準確度是否改善取決於記憶設計,顯示減少輸入內容並不必然帶來更可靠的 SQL。
- HARE 專門測量改編歷史 SQL 的準確度與成本,涵蓋整條查詢改編及部分重用。
- MEM-SQL 保存查詢範本、可重用 SQL 區塊,以及概念到 schema 元素的映射。
- 分層記憶只有在所有條件達到相應門檻時才會啟用。
- OSL 只在記憶不足或生成器判斷證據不夠時查閱資料庫結構。
- 平均準確度由 37.1% 升至 50.0%,輸入 tokens 減少 76.6%,延遲降低 68.8%。
MEM-SQL 適合資料庫固定、查詢歷史可靠,而且新請求經常延續既有報表邏輯的工作流。它證明已驗證歷史可以同時改善準確度和成本,但研究結果也清楚表明,記憶如何保存、何時查閱 schema,以及多個組件能否放進新的查詢結構,仍然決定了方法能否穩定擴展。