BrainCause:用因果測試重新看懂腦部視覺表徵

這項目不只看腦部活化強不強,還會追問反應是否真的由目標概念引起。它把受控圖像生成與 fMRI 驗證結合,減少誤判。

Og image

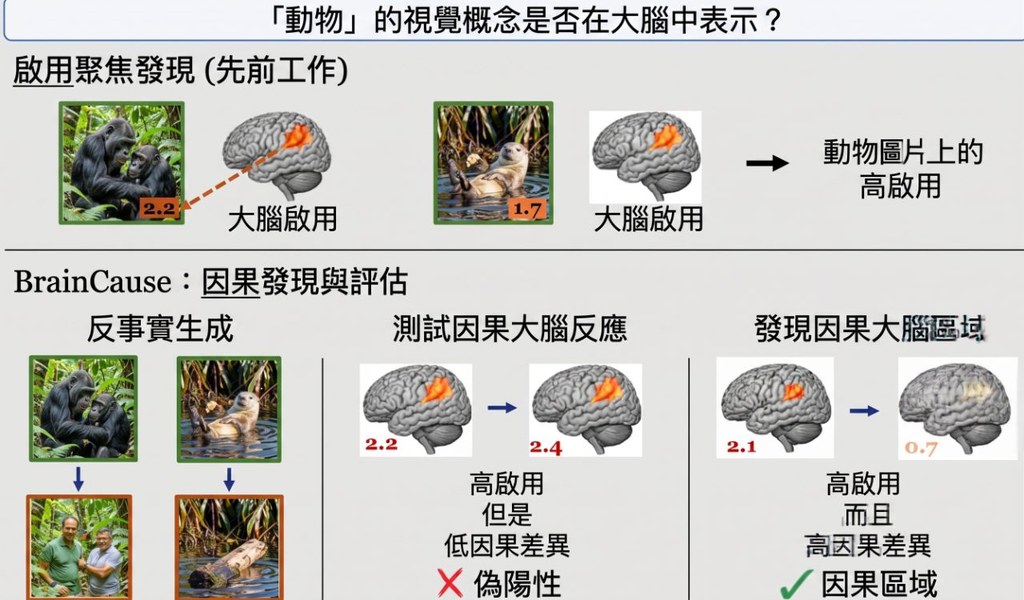
BrainCause 是一個針對神經科學與電腦視覺領域開發的自動化框架,用來尋找人腦視覺概念表徵的研究項目。它處理的核心問題是:某個腦區對圖片反應很強,未必代表它真的在表徵該概念,因為反應也可能只是被相關的視覺線索或語意線索帶動。

這個項目會先根據查詢概念建立一組受控刺激資料,包括目標概念圖片、保留其他內容但移除目標概念的 counterfactual edits,以及帶有相關干擾元素的圖片。然後再配合 brain models 與 fMRI 驗證,檢查腦區反應是否會隨概念移除而下降,藉此做 targeted causal testing。

重點在於,它不是只用 activation 來定位腦區,而是加入 causality 驗證。頁面內容指出,若只看 activation,很多定位結果都可能是假陽性;BrainCause 則會回傳經驗證的候選表徵,並提出後續 fMRI 實驗,用來進一步確認或擴展發現。

  • 針對指定概念自動建立 causal dataset
  • 使用 positive images、semantic negatives、counterfactual negatives 作比較
  • 減少只靠 activation 帶來的 false positives
  • 可找回已知功能定位,也能提出新的候選表徵
  • 已在 predicted 與 measured fMRI data 上驗證,涵蓋數十個概念

如果你關心神經科學、電腦視覺,或想了解生成模型如何協助腦科學研究,這個項目很有參考價值。頁面亦提供 Paper、Data 與 Code 入口,方便進一步了解方法與結果。
項目: https://yuvalgol123.github.io/BrainCause/

Categories: 開源, 框架, Medical醫學, Dataset 數據集

PaddleOCR 把圖片和 PDF 變成 LLM 吃得到的結構化資料

百度開源的 PaddleOCR 已累積逾 7 萬顆星,1.6 版輕量模型在 OmniDocBench 取得 96.33% 分數,為 RAG 與 Agent 應用提供高效率的文檔解析基礎。

Star-history

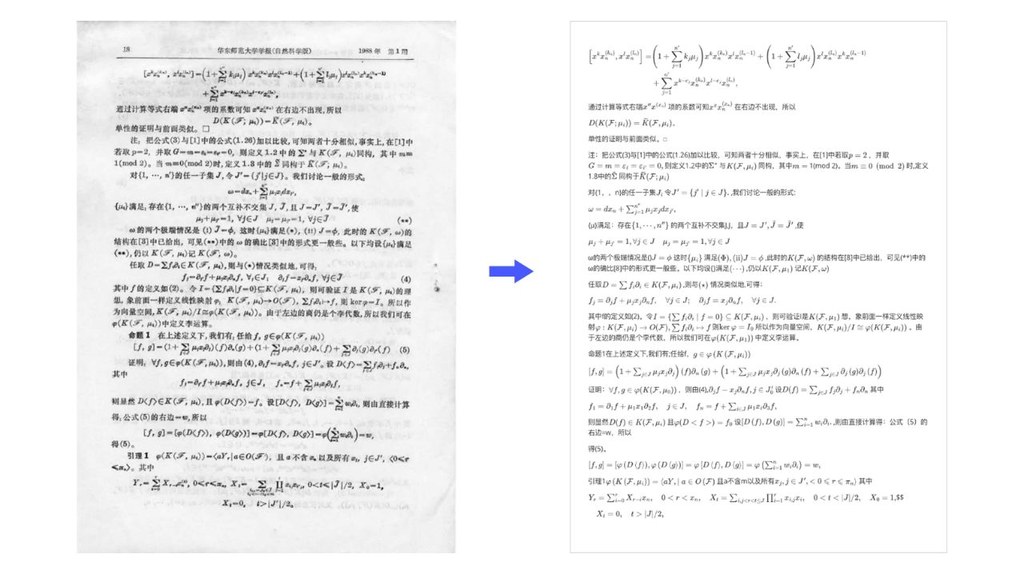
處理 PDF 和圖片一直是企業導入 LLM 應用時最頭痛的關卡,傳統 OCR 工具只會吐出零散文字,遇到表格、公式或多語言混排就頻頻出錯。PaddleOCR 由百度 PaddlePaddle 團隊開源,目標是把雜亂的掃描檔和圖片整理成 LLM 友善的 JSON 或 Markdown,後續無論餵給 RAG 檢索還是 Agent 流程都更順暢。

這個項目以兩個核心模型撐起整套能力。PaddleOCR-VL-1.6 是一款 0.9B 參數的視覺語言模型,專注文件解析,在 OmniDocBench v1.6 取得 96.33% 分數,對古文、罕見字、印章及圖表也有顯著強化。PP-StructureV3 則補足了另一條路線,提供表格儲存格、文字等更細粒度的座標資訊,方便需要版面重建的場景。最新版 PP-OCRv5 支援 100 多種語言,準確度較前代提升約 13%,同時保持輕量部署特性,可在 CPU、GPU、NPU 等不同硬體運行。

目前的 LLM-RAG 開源生態中,Dify、RAGFlow、Cherry Studio 等知名項目都採用 PaddleOCR 作為文件解析層,社群也累積超過 6,000 個依賴它的下游項目。對需要批次處理合約、研究論文、政府公文或多語文件的人來說,這套工具兼具商用級準確度與邊緣裝置可用的效率,動手前只要準備好 Python 3.8 至 3.12 環境即可開始試跑。

重點摘要

  • PaddleOCR-VL-1.6 (0.9B) 在 OmniDocBench v1.6 達到 96.33%,輕量卻具競爭力。
  • PP-StructureV3 補足細粒度座標,適合需要表格與版面重建的應用。
  • PP-OCRv5 支援逾 100 種語言,準確度較前代提升約 13%,硬體需求低。
  • 已被 Dify、RAGFlow、Cherry Studio 等 LLM 應用項目整合採用。
  • GitHub 逾 7 萬顆星、6,000 多個依賴項目,社群驗證度高。

GitHub: https://github.com/PaddlePaddle/PaddleOCR

Paper: https://arxiv.org/pdf/2606.03264

Categories: 開源, 模型, 視覺模型, 中國, Dataset 數據集, 百度

Crafter:把科研圖表交給多智能體助手

Crafter 以多智能體協作方式生成並可後續編輯的學術圖表,搭配 CraftBench 評測集,覆蓋多種類型與輸入條件。

crafter architecture

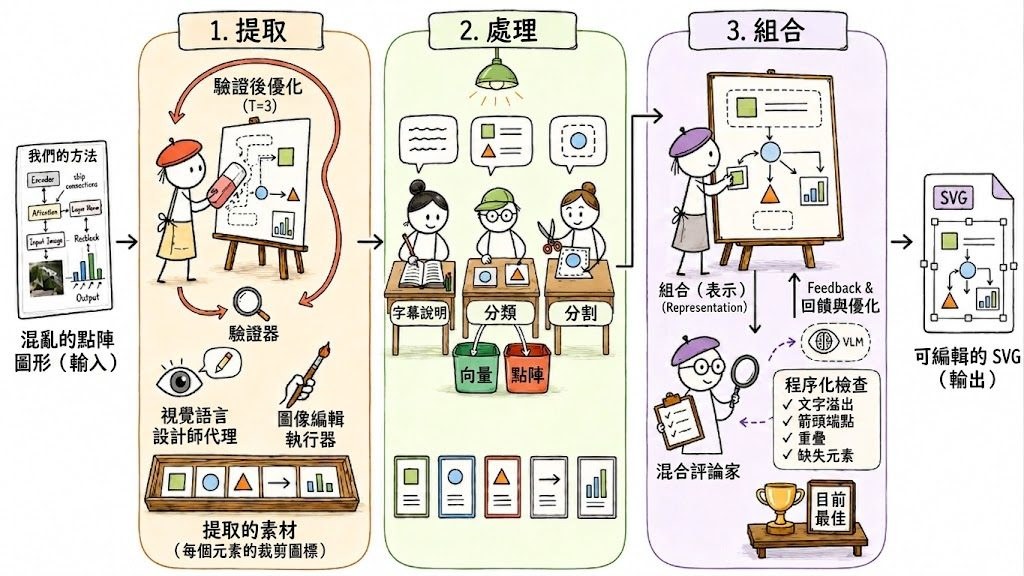
做研究的人都遇過這種困擾:論文裡的圖表要花好幾個小時排版、微調細節,市面上的 AI 生圖工具又常常「整體不錯、局部出錯」,改一個元素就把整張圖搞砸。Crafter 正是針對這個痛點而來,它不是把底層生成模型換得更強,而是在外面包了一層多智能體(multi-agent)協作框架,專門處理「結構化、由離散語意元件組成」的科研圖表。

這個項目分為兩個互補系統。Crafter 負責生成,覆蓋學術圖、海報、資訊圖三種類型,並支援文字生圖、遮罩補完、關鍵元素組合、草圖優化等四種輸入條件,不需要更動架構就能切換。CraftEditor 則把生成的點陣圖轉成「座標精準、可後續編輯」的 SVG 格式,研究者終於可以像在 Illustrator 裡那樣挑出單一元件修改。

為了評估效果,團隊同步釋出 CraftBench——一個 279 筆樣本的基準集,每個樣本都附有人工繪製的參考圖,跨越三種圖表類型與四種輸入條件。在 PaperBanana-Bench 與 CraftBench 上,Crafter 都明顯優於單一生成器與既有的 agentic 基線。CraftEditor 轉出的 SVG 在可編輯性上也勝過所有對照組。

生成部分只要設定 OpenAI 相容端點(例如 OpenRouter)即可跑範例;想啟用 CraftEditor 還需要額外架設一個 SAM3 語意分割伺服器。

重點摘要

  • 解決科研圖表「局部錯誤難修、難以再編輯」的問題
  • 採用多智能體協作框架,不需更換底層模型即可跨類型、跨輸入條件生成
  • 內建 Crafter 生成與 CraftEditor 點陣轉 SVG 兩套流程
  • 釋出 CraftBench 評測集,含 279 筆人工標註樣本
  • 適合需要大量產出與修改學術插圖的研究者、團隊與會議海報設計者

GitHub: https://github.com/HaozheZhao/Crafter

Paper: https://arxiv.org/pdf/2605.30611

Categories: 開源, 北京大學, 清華大學, 框架, 中國, Dataset 數據集

Anime.js 4 網頁特效的萬用引擎

想為網站加動感,但又唔想在 CSS、SVG 同互動事件之間來回拆件,Anime.js 4 提供咗一套幾完整嘅 JavaScript 動畫工作流。

Anime.js V4 logo animation

做網頁動效最麻煩嘅位,往往唔係寫出第一個 fade 或 rotate,而係當畫面同時牽涉 CSS transforms、SVG 路徑、滾動觸發同拖曳互動時,邏輯會好快分散。Anime.js 屬於 JavaScript 動畫庫,重點係用同一套 API 處理 CSS properties、SVG、DOM attributes 同 JavaScript Objects,令介面動畫、資料視覺化同品牌展示頁可以用較一致嘅方式編排。

相比只覆蓋單一動畫層的做法,Anime.js 4 的價值在於它唔止負責補間效果,仲連 timeline、stagger、Scroll Observer、SVG utilities 同 Draggable 都放入同一個工具箱。代價亦清楚:它比較適合本身已經用 JavaScript 控制互動節奏的前端項目,若果只需要極簡 hover 或過場,直接用 CSS 或 WAAPI 可能更輕。

Anime.js 通常會經 npm 納入前端項目,再按需要引入 animate、createTimeline、createDraggable 等模組;官方亦強調可按功能分開載入,方便控制 bundle size。由文件與首頁示例可見,最值得試的是把單一元素動畫、滾動同步、SVG 路徑跟隨與拖曳回彈放入同一頁,看看整體編排是否比你現有寫法更順手。

  • 同一套 API 覆蓋 CSS、SVG、DOM attributes 同 JavaScript Objects
  • 內建 Timeline、Stagger、Scroll Observer、Draggable,適合多步驟互動頁面
  • 支援 modular import,有助控制前端打包體積
  • 強項在複合型動效編排,不是追求最少抽象的微型工具

Anime.js 主打 fast、lightweight,同時保留足夠完整的動畫編排能力。對需要經常做行銷頁、產品展示、資料互動介面或設計系統微動效的團隊來說,Anime.js 吸引力不在單一特效,而在於它把原本容易四散的動畫控制集中成一條可維護的工作流。

項目主頁 · GitHub

Categories: 開源, API, 庫, 編程, UI/UX

從腦部訊號到影像問答:Brain-IT-VQA 框架解碼大腦視覺理解

Brain-IT-VQA 結合 Brain Interaction Transformer 與預訓練視覺語言模型,直接從 fMRI 訊號生成影像描述與回答問題,並發佈全新 NSD-VQA 數據集。

Weizmann Institute of Science

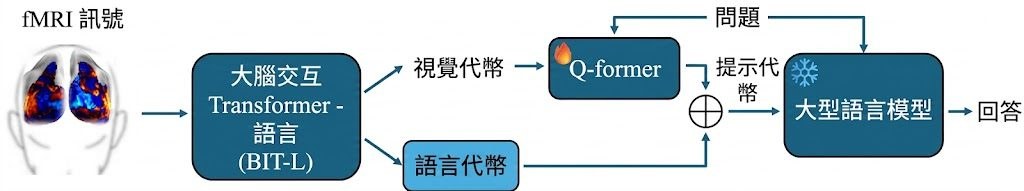
Brain-IT-VQA 是一套從 fMRI(功能性磁共振造影)腦部訊號出發,自動回答「圖片中看到什麼」這類問題的框架。研究團隊建基於 Brain Interaction Transformer(Brain-IT),把腦部活動轉換成語言條件表徵,再交由預訓練的視覺語言模型生成答案,全程毋須先把腦部訊號重建成影像。

這項工作解決了一個長期難題:過去從 fMRI 解讀視覺內容的研究,大多只能產生粗略描述,而且準確度有限;更少有模型被用來分析大腦內部如何處理視覺資訊。Brain-IT-VQA 在多項基準上明顯超越以往的 fMRI 影像描述與 VQA(Visual Question Answering,視覺問答)方法,同時提供拆解視覺理解層次的工具。

團隊同步發佈 NSD-VQA 數據集,以 Natural Scenes Dataset(NSD)為基礎,平均每張影像提供約 20 題,涵蓋 20 個受控問題類別。這些類別覆蓋物件辨識、空間關係、語意判斷等不同層次,方便研究者細緻評估模型在各種視覺與語意任務上的表現。

透過「解碼貢獻分析」,框架可揭示不同腦區對各類問題的貢獻分布,協助神經科學家理解大腦處理視覺資訊的空間分佈特徵。頁面亦設有互動示範,讓訪客在從未參與訓練的 NSD 測試影像上,瀏覽模型生成的描述與問答結果。

重點摘要

  • 直接從 fMRI 解碼語言:把腦部活動轉成語言條件表徵,由預訓練視覺語言模型生成描述與答案,毋須影像重建步驟。
  • 公開 NSD-VQA 數據集:每張影像平均 20 題、20 個受控類別,提供更細緻的 VQA 評估基準。
  • 顯著超越先前方法:在 fMRI 影像描述與視覺問答任務上,明顯優於過往同類模型。
  • 支援腦區貢獻分析:可拆解不同腦區在各類視覺問題中的參與程度,輔助神經科學研究。
  • 附設互動示範:容許瀏覽者在 NSD 測試影像上查看模型的預測輸出。

這個項目最適合從事腦部解碼、視覺語言模型、神經科學與認知計算的研究人員與研究生。對希望了解 AI 與人類視覺如何結合的工程師而言,NSD-VQA 與開源代碼亦提供了一個具挑戰性的新基準。

研究單位:
Weizmann Institute of Science (魏茨曼科學研究所)在以色列的雷霍沃特(Rehovot),大約在特拉維夫以南。

魏茨曼科學研究所一般被視為世界頂尖的基礎研究機構之一;在你這次查到的資料裡,它在萊頓排名中被列到全球前十,2021 年為第 8 名。

它的重點研究領域主要集中在 生物學/生物化學、化學、物理、數學與電腦科學,也有跨學科方向。

項目: https://mcosarinsky.github.io/brain-it-vqa/

Categories: Medical醫學, Dataset 數據集

Claude Code + Remotion 在2026年能做到的一切

AI 幫你把傳統剪片拆成可編程流程。核心係先用自然語言定義內容,再令 Claude Code 寫出可重複、可修改、可批量渲染嘅 Remotion 影片專案 。

AI 幫你把傳統剪片拆成可編程流程。核心係先用自然語言定義內容,再令 Claude Code 寫出可重複、可修改、可批量渲染嘅 Remotion 影片專案 。

Everything Claude Code + Remotion Can Do in 2026 (Full Animation Breakdown)
Categories: 教學

JetBrains 推出 Mellum 2:專為即時推論而生的輕量語言模型

Mellum 是 JetBrains 推出的輕量語言模型系列,主打低延遲與高效能推論,特別適合需要即時回應的 AI 應用場景。

Og image

Mellum 2 是 JetBrains 推出的一系列輕量級語言模型,設計目標是讓 AI 推論過程更快、更省資源。相較於一般大型語言模型龐雜的體積,Mellum 走的是精簡路線,能在保持表現的同時,大幅降低回應時間,這對於需要即時互動的應用來說相當關鍵。

Mellum 2 是開放權重的 120 億參數混合專家 (MoE) 語言模型,每個詞元有 25 億個活躍參數。

這項目主要解決一個核心問題:如何在不犧牲太多準確度的前提下,讓語言模型的回應速度快到可以整合進日常工具中。例如 IDE(Integrated Development Environment,整合式開發環境)內的自動補全、程式碼提示等功能,往往需要模型在幾十毫秒內就給出結果,傳統大型模型很難做到這一點。

Mellum 2 的主要創新在於針對低延遲推論(ultra-low-latency inference)進行了架構與訓練流程的最佳化,讓模型在邊緣裝置或本地端環境也能順暢運行。JetBrains 將其定位為「real-world AI workloads」,意思是它不是只為研究而生的模型,而是真正要部署到生產環境的工具。

這套模型最適合的場景包括:需要即時回應的開發工具、需要本地端 AI 能力的企業應用,以及對成本敏感的批次處理任務。開發者可以透過 JetBrains 提供的資源將 Mellum 整合到自己的系統中,而無需依賴雲端的大型模型服務。

以下是 Mellum 2 的重點摘要:

  • 輕量架構:模型體積小,適合在本地端或資源有限的環境運行。
  • 低延遲推論:針對即時回應需求設計,回應速度遠快於一般大型語言模型。
  • 生產導向:專為實際部署與整合而打造,非純研究用途。
  • JetBrains 背書:由 IDE 領域知名團隊推出,與開發者工具生態有良好銜接。

整體而言,Mellum 2 代表了語言模型走向「小而快」的趨勢,讓更多場景能以合理成本享受到 AI 帶來的便利。

項目: https://www.jetbrains.com/mellum/

Categories: 開源, 模型

TaskMem:教多模態智能體學會選擇性記憶

ByteDance Seed 與復旦大學提出 TaskMem,以強化學習訓練智能體的記憶策略,在三個串流基準上明顯提升多模態問答表現。

Og image

多模態智能體在持續觀察環境時,會接收海量且不斷累積的視覺與語言資訊。若把所有內容都存進長期記憶,既不實際也容易雜訊過多。Task-Focused Memorization for Multimodal Agents 這份研究,把焦點放在一個根本問題:智能體到底應該記住什麼?

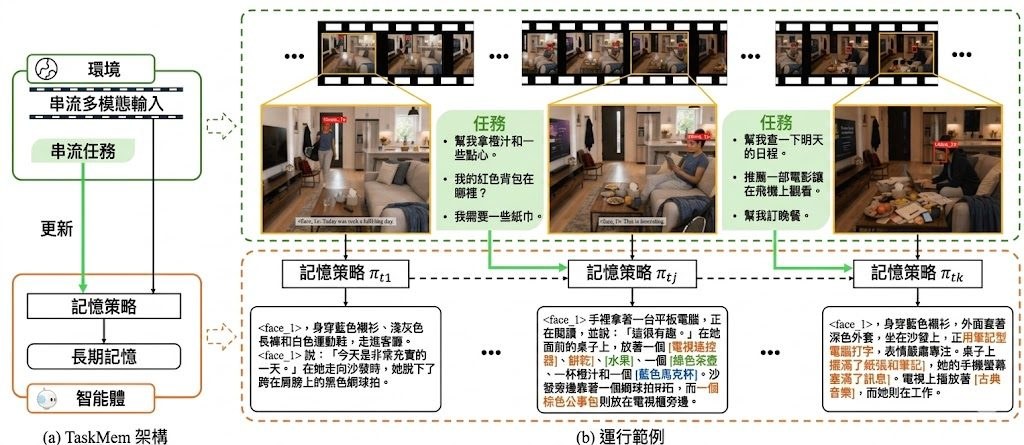
來自 ByteDance Seed 與復旦大學的作者群提出名為 TaskMem(Task-focused Memorization Policy Learning) 的框架,把記憶生成視為一項可學習的策略。系統採用兩階段訓練:第一階段先學習怎樣記得準確,第二階段則在部署後,根據近期遇到的任務調整一個 adapter,使基礎多模態大型語言模型(MLLM)偏向記錄與任務相關的內容。整個過程以強化學習驅動,獎勵訊號來自真實任務的表現。

為了評估記憶品質,研究團隊將 VideoMME、EgoLife 與 EgoTempo 改造成串流基準,模擬智能體邊觀察邊回答的場景,且回答時只能依賴記憶,不能翻看原始影片。基於 Qwen3-VL-30B-A3B,TaskMem 在三個基準的 VQA 準確率分別提升 6.3%、7.0% 與 5.3%,並在多項指標上超越 Gemini-2.5-Pro、GPT-5.2 等大型模型。

這項工作對從事多模態智能體、機器人記錄系統或長期對話助手開發的研究者特別有參考價值,因為它把「該記什麼」變成可優化的決策,而非寫死規則。對於關注世界模型與持續學習(continual learning)的團隊,TaskMem 亦提供了一個結合任務回饋與記憶策略的可行路徑。

重點摘要:

  • 核心問題:多模態智能體面對資訊洪流,需要學會選擇性記憶。
  • 方法:以強化學習訓練記憶策略,分為基礎保真度與任務相關性兩階段。
  • 評估方式:將三個影片基準改造成串流設定,僅以記憶回答問題。
  • 成效:在 VideoMME、EgoLife、EgoTempo 上 VQA 準確率提升 5.3% 至 7.0%。
  • 適用對象:研究多模態智能體、機器人記憶與持續學習的開發者與學者。

項目: https://taskmem.github.io/

Categories: 開源, 字節跳動, Agentic, 框架, OpenClaw

GUI 智能體總是自己犯錯?RoTS 用樹狀軌跡合成教它如何自救

阿里雲發布的 RoTS 項目,為 GUI 智能體補上「犯錯後恢復」的能力短板,並在 OSWorld 基準上刷新開源模型表現。

Repository image for AlibabaResearch/RoTS

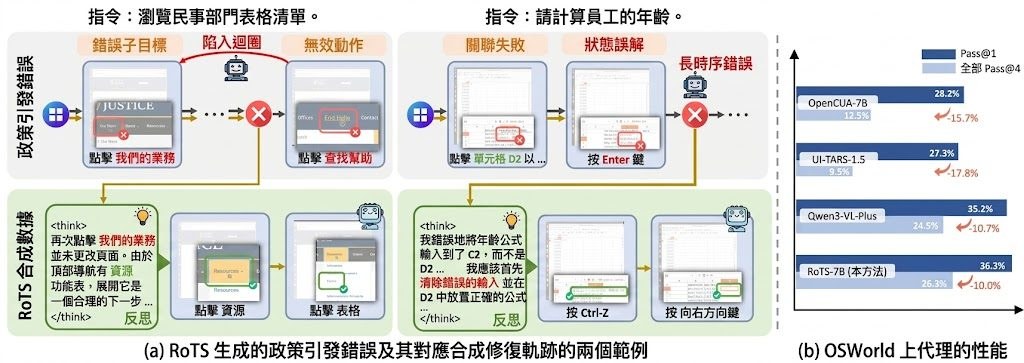
近年 GUI agents(圖形介面智能體)雖然進步神速,但只要自己點錯一個按鈕、誤判畫面狀態,往往就會卡住無法完成任務。這項由阿里雲團隊撰寫、入選 ICML 2026 Spotlight 的工作,正是針對這個「自己造成的錯誤」痛點,從評估與訓練數據兩端同時入手。

他們先推出了 GUI-RobustEval 基準,收錄 1,216 個可執行測試案例,涵蓋 11 種錯誤類型與 4 種錯誤深度,讓開發者能系統化量測智能體的「自救」能力。接著提出 RoTS 框架,以樹狀結構(tree-based)在線生成 80 萬條訓練軌跡,主動探索不同錯誤模式並合成對應的恢復步驟。

基於這批數據微調而成的 RoTS-7B 與 RoTS-32B,在 OSWorld 上於開源權重模型中取得領先表現,其中 RoTS-32B 達到 47.4% 成功率與 33.8% All-Pass@4 分數。研究團隊指出,這些分數顯示長時程錯誤恢復能力,同時提升了整體任務表現。

對從事電腦使用代理(Computer-use agents, CUAs)研究、開源 VLM 微調,或關注 GUI 自動化在真實環境穩定性的團隊而言,這是一份值得追蹤的成果。論文與數據集已公開,但程式碼與評估工具仍在整理中,有興趣的人可先閱讀論文並關注後續釋出。

重點摘要:

  • 解決 GUI agents 因自身策略錯誤而無法恢復的部署瓶頸
  • GUI-RobustEval 提供 1,216 個測試案例,覆蓋 11 種錯誤類型
  • RoTS 以樹狀在線合成框架產出 80 萬條高品質訓練軌跡
  • RoTS-7B 與 RoTS-32B 於 OSWorld 開源模型中表現領先
  • 程式碼與數據集仍在整理階段,論文已於 arXiv 公開

GitHub: https://github.com/AlibabaResearch/RoTS

Paper: https://arxiv.org/pdf/2605.29447

Categories: 開源, Agentic, 框架, OpenClaw

GGT-100K:用十萬對真實影像 拓寬圖像修復的泛化邊界

香港理工大學與 OPPO 研究院聯手發布 GGT-100K 數據集,從 MFM 模型生成十萬對低品質與高品質影像配對,協助圖像修復模型在真實場景中表現更穩定。

GGT-100K logo

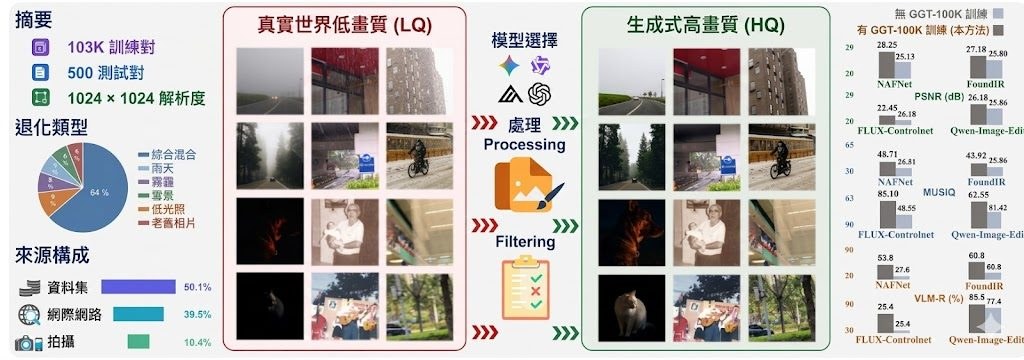
過去訓練圖像修復模型時,開發者往往受限於合成數據與真實場景之間的差距;模型在實驗室數據集表現亮眼,遇到街拍、手機夜拍等真實退化影像就大打折扣。GGT-100K 正是為了解決這個落差而生,由香港理工大學 OPPO 研究院共同推出,主打從 MFM(Multimodal Foundation Models)直接生成十萬對 LQ-HQ 配對資料,覆蓋更貼近日常的真實退化類型。

這個項目的核心想法是「讓高品質影像本身充當 Ground Truth(GT)」,再利用 MFM 推演對應的低品質版本,省去繁瑣的人工蒐集與標註。GGT-100K 並附帶 baseline 訓練程式碼與 checkpoint,研究者只需在自有的修復模型上加掛 LoRA 或重新微調,就能測試跨域泛化效果;對工程團隊而言,等於取得一條快速驗證真實世界表現的捷徑。

GGT-100K 重點摘要

  • 提供十萬對從 MFM 生成的 LQ-HQ 影像配對,涵蓋多元真實退化情境。
  • 內建 baseline 訓練與推論程式碼,支援主流修復模型微調。
  • 透過 Generative GT 策略,免除傳統人工蒐集配對的高昂成本。
  • 數據集可從 Hugging Face 或百度雲下載,附完整 Construction Process 說明。
  • 實驗結果顯示,模型在跨域真實退化測試中的泛化能力有明顯提升。

至於性能表現,作者在多個 SOTA(State-of-the-Art)MFM 上進行了修復評估,結果顯示加入 GGT-100K 訓練後,模型對未見過的真實退化樣本有更佳的適應力;具體的數值比較已收錄在 Experimental Results 區段與論文 arXiv 2605.31039 之中。如果你是從事影像修復、攝影 App 開發,或是想評估自家模型在真實世界表現的團隊,這份開源資源值得花時間一試。

GitHub: https://github.com/PolyU-VCLab/GGT-100K

項目: https://polyu-vclab.github.io/GGT-100K/

Categories: 開源, 香港理工大學, 模型, 視覺模型, 模型訓練, 影像處理, Dataset 數據集

Page 98 of 184
1 … 96 97 98 99 100 … 184