DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。
項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

AI agents 正接手企業故障追查

當系統愈來愈複雜,單靠工程師逐層查 root cause analysis 已經太慢。企業而家更想交畀 AI agents 先做調查,再由人決定下一步。

當服務一出問題,最花時間往往唔係修復,而係先搵出 root cause analysis。呢篇內容聚焦企業 observability 點樣由 Generative AI 同 agentic AI 推進,令 AI agents 開始負責調查、整理線索同縮窄問題範圍,減少工程團隊喺大量 telemetry 同 log 之間來回切換。

文章提到,企業採用速度已經相當快,約 85% 組織正使用相關 AI 能力,而 Elastic 亦預期多數企業會喺兩年內,將 root cause analysis 更大程度交畀 AI agents。吸引力唔只在於自動化,而係將原本只有少數資深工程師先能處理的觀察與排障流程,慢慢變成更多團隊都可用的能力。

同常見做法相比,分別在於 AI agents 唔止回應查詢,仲會主動串連資料、追查異常脈絡,並以較接近調查員嘅方式處理 incident。呢種模式有機會改善資料存取門檻過高、工具過多同訊號過散嘅問題,但前提仍然係企業要信任結果,並保留人手覆核關鍵判斷。

  • 重點放在 observability、incident investigation 同 root cause analysis
  • Generative AI 與 agentic AI 正由輔助查詢走向主動調查
  • 約 85% 組織已採用相關 AI 能力,企業導入已進入加速期
  • 目標係降低排障門檻,令更多團隊可直接理解系統狀態

對平台工程、SRE、DevOps 同需要處理大型分散式系統嘅團隊,呢種方向尤其有用。現階段最值得留意嘅唔係模型規格,而係 AI agents 能否喺真實企業環境中提供可追溯、可驗證、又足夠穩定嘅調查流程,呢點會直接影響大規模 adoption。

項目主頁

Categories: Agentic, 軟件, 中國

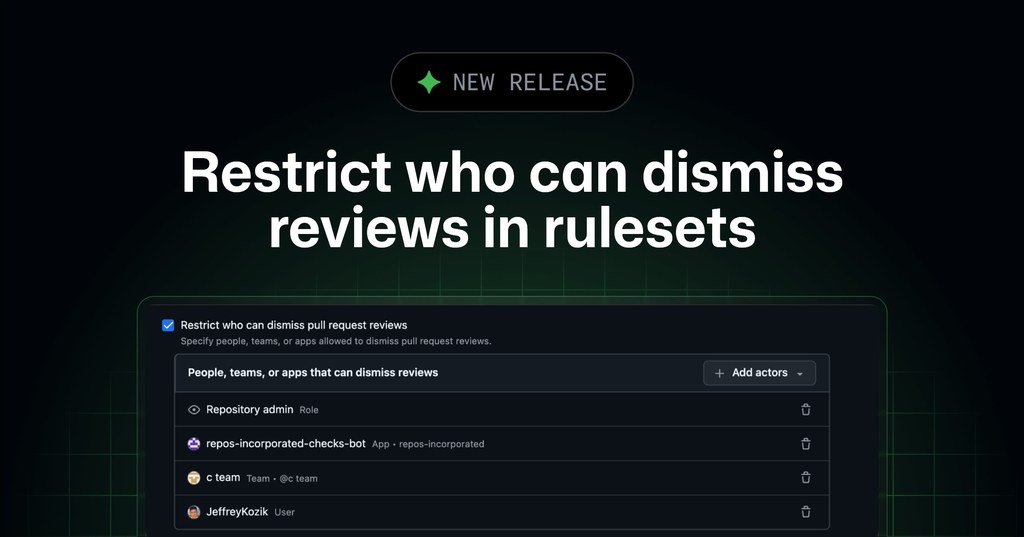
GitHub 規則集新增審核撤銷權限控制

團隊而家可以直接限制邊啲人有權撤銷 pull request 審核。對需要嚴格合併流程嘅項目,呢個更新可減少誤操作同權限過闊帶來嘅風險。

Og image

當團隊依賴 pull request 審核去把關程式碼質素時,最怕唔係冇人批核,而係批核已經完成後,任何唔合適嘅人都可以把審核撤銷。GitHub 今次更新屬於 repository rulesets 功能強化,處理嘅正正係合併前權限邊界唔夠細緻呢個問題。

新設定放入 Require a pull request before merging 規則之中,管理者可以直接指定邊啲 users、teams 同 apps 能夠 dismiss reviews。對比以往較寬鬆或者分散嘅管控方式,呢種做法將審核撤銷權限收返去規則集內統一管理,分支保護流程會更清晰。

重點整理:
– 可限制特定 users、teams、apps 撤銷 pull request reviews
– 設定位置已整合到 repository rulesets 既有審核規則內
– 可透過 UI、REST API 同 GraphQL 配置
– 功能已經 generally available,適用於 github.com 上嘅 repository rulesets

呢個更新最適合有多人協作、需要明確審批責任,或者要配合內部治理要求嘅開發團隊。Rulesets 本身已經係 GitHub 建議用來保護 branches 嘅方式,而家再加上審核撤銷限制,等項目喺合併前多一層可追蹤、可控嘅流程保護。

使用上做法唔複雜,只要打開 repository-level ruleset,啟用 Require a pull request before merging,再選擇 Restrict who can dismiss reviews 就可以。呢類更新唔係花巧功能,而係直接改善日常協作入面最常見嘅權限管理細節。

項目主頁

Categories: 開源, 微軟, API, 教學, 軟件, 安全

Qwen-Image-Bench:難分高下的是細節

生成圖像模型愈做愈靚,真正難分高下的是細節表現。Qwen-Image-Bench 把評分拆得更細,較容易看清模型在哪些創作場景會失手。

Qwen-Image-Bench dimension framework and representative model outputs

只看一張圖夠唔夠靚,已經不足以判斷 text-to-image (T2I) 模型值唔值得放入創作流程。Qwen-Image-Bench 把焦點放到更貼近創作工作的檢查方式:它屬於評測工具包,同時連同 benchmark dataset 同 judge model,一併處理生成圖像模型難以客觀比較的問題。

這個項目的可取之處,在於它唔係只計語意對齊或整體畫質,而是用 fine-tuned 的 Q-Judger(Qwen3.6-27B)按 5 個階層維度評分,包括 Quality、Aesthetics、Alignment、Real-world Fidelity、Creative Generation,並細分到 56 個 facets。對做品牌視覺、遊戲美術、漫畫分鏡或者要處理文字渲染的人來說,呢種拆法比單一總分更有參考價值,因為你會直接見到模型係構圖、真實感、創意約束,定係文字生成出問題。

部署理解上,它唔係即開即用的網頁服務,而是偏研究與團隊驗證流程的 Python 工具。你要準備好虛擬環境、PyTorch,同埋包含 prompt、image_path、ID 的 CSV/JSON/JSONL 輸入,再透過 judge.py 跑 Qwen/Qwen-Image-Bench;另一條路線是直接用已公開的 benchmark responses 重現排行榜分數。底層推理沿用 ms-swift,跟釋出 benchmark 結果時的設定一致,這點有助減少評測流程前後不一。

  • 支援替任何 T2I 模型打分,較適合做橫向比較
  • 分數結構比一般 benchmark 細,方便定位失誤位置
  • 可重現公開資料集結果,適合研究或團隊內部驗證
  • 使用門檻偏技術向,需要本地推理環境與整理輸入格式

它的取向也很清楚:重點不是提供生成能力,而是提供一把較細緻的尺。代價是評測仍依賴 judge model,本身並不是人手審稿,也未必完全等同最終用戶審美;但對需要批量比較模型、整理回歸測試、追蹤版本變化的團隊,這種一致而可重跑的框架反而更實用。相關模型與資源包括 Q-Judger(Qwen3.6-27B)、Hugging Face 上的 Qwen/Qwen-Image-Bench,以及配套 benchmark dataset。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, txt2img, 工具, Python, Dataset 數據集


OmniRoute:免費 AI 路由閘道值唔值得用

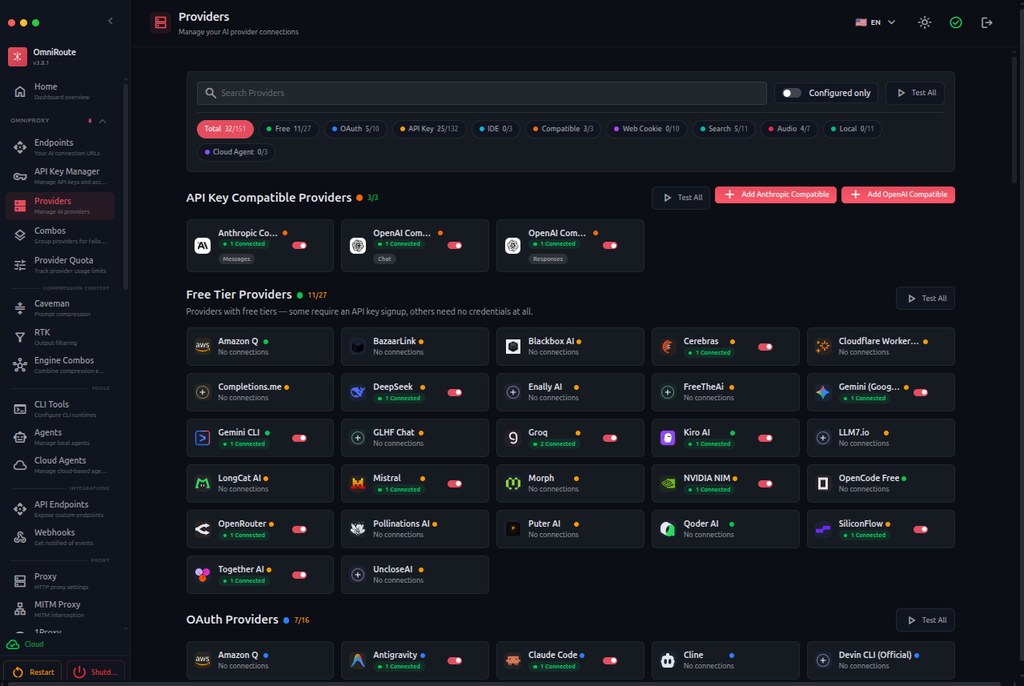
想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。

OmniRoute Dashboard

寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。

同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。

OmniRoute + OpenCode: 100% Free AI Coding Setup, Free AI Gateway
New FREE Unlimited AI Coder | OmniRoute

你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。

幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化

受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。

GitHub

Categories: 開源, 微軟, Gemini, API, Vibe Coding, 工具, IDE, 編程, Anthropic

Rank-Then-Act 點樣用影片學出獎勵

想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

Screenshot

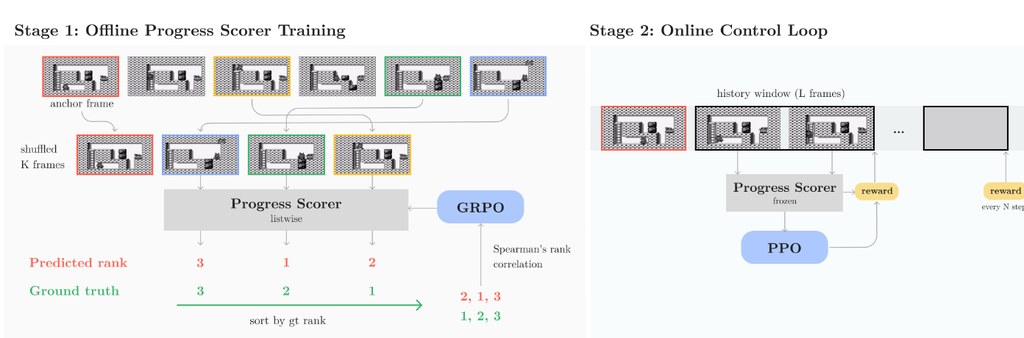
做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

[技術文章] Gemma 4:更快更慳算力的多模態開放模型

Gemma 4 想解決的,不只是模型夠唔夠大,而是點樣同時兼顧推理、多模態同部署效率。你可以把它理解成一組更貼近開發與裝置落地需要的 Gemma 新世代模型。

Hero image preview

Google 正式發佈 Gemma 4 技術報告文章:

當模型要同時處理文字、圖片同音訊,常見做法多數靠獨立 encoder 加上大型語言模型組合;能力雖然完整,但記憶體佔用、推理速度同長上下文成本都容易變重。Gemma 4 Technical Report 針對的正是呢個矛盾:唔只追求更強表現,亦想把多模態理解、推理能力同計算效率放到同一條路線上處理。

Gemma 4 屬於 open-weight、natively multimodal language models,涵蓋 dense 同 Mixture-of-Experts(MoE)架構,規模由 2.3B 到 31B。報告最值得留意的對比,在於作者唔再只沿用「更大模型加外掛模組」呢種固定範式,而是加入 thinking mode,令模型先產生 reasoning trace 再回答;同時用長上下文優化、KV cache sharing,以及在 12B 版本引入 unified, encoder-free architecture,把 raw audio 同 image patches 直接投影到 LLM embedding space。

呢種設計帶來的好處幾實際:一方面,長上下文下的記憶體壓力有機會減輕,報告提到 global KV cache footprint 最多可減 37.5%;另一方面,模型亦提供用 quantization-aware training(QAT)訓練的量化版本,盡量在不明顯犧牲品質下減少參數記憶體佔用同延遲。另有 autoregressive multi-token prediction(MTP)drafter head,配合 speculative decoding 提升解碼速度。

  • 支援文字、圖片、音訊,多個型號覆蓋不同硬件需求
  • 以 thinking mode 加強數學、編程等重推理任務
  • 透過 p-RoPE、KV cache sharing 等方法改善長上下文效率
  • 12B 型號採用 encoder-free 路線,減少獨立 encoder 帶來的記憶體碎片化

性能方面,報告指 Gemma 4 在 STEM、多模態同長上下文 benchmark 有明顯進步,亦在 Arena 等 human-rated tasks 接近更大型的 frontier open models。原始資料未提供安裝步驟或完整使用流程,但已清楚交代模型系列的核心取向:用較可控的成本,換取更接近前沿水準的多模態推理能力,並以 Apache 2.0 授權開放。

Paper

Categories: Embedding, 模型, 多模態模型, 模型訓練, Google, Gemini, Image, Audio, Dataset 數據集

3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

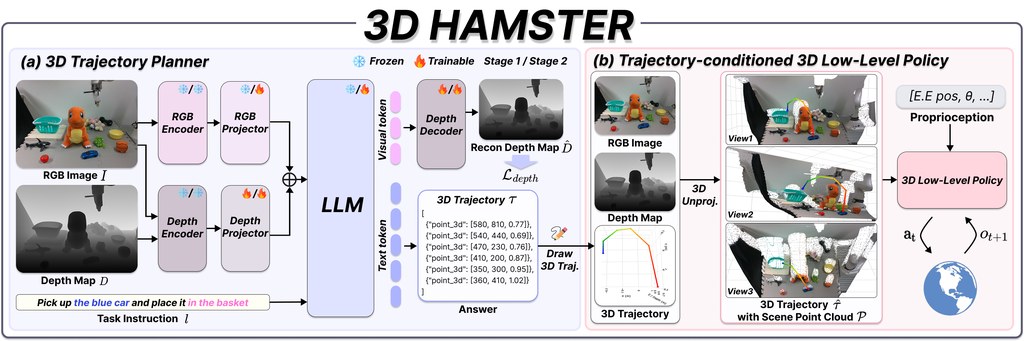
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • 走 RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

CGGS 把文字直接變成第一身 3D 場景

想由文字生成可自由觀看的第一身 3D 場景,CGGS處理得比一般全景路線更穩。它重點不是只做靚圖,而是連視角一致性與幾何結構都一併補強。

teaser

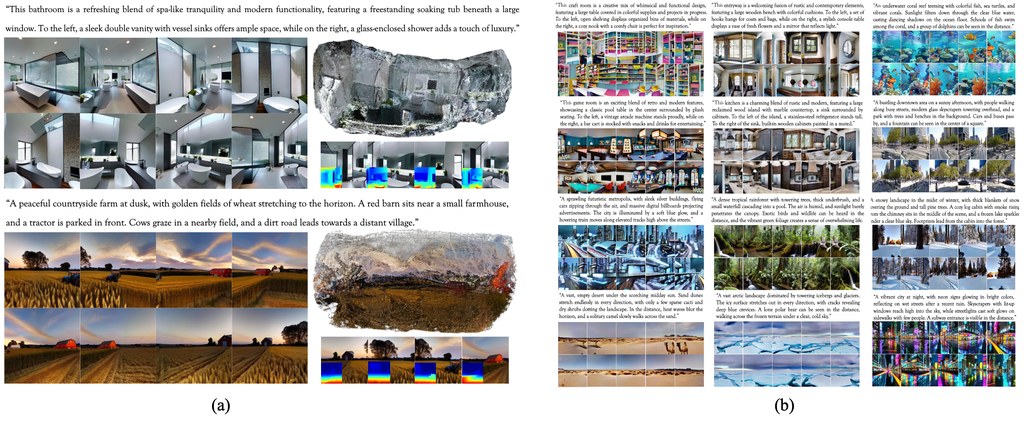
最值得留意的地方,在於 CGGS 沒有沿用單純全景生成再重建的路線,而是直接針對第一身視角 3D 場景去處理視角不連續、幾何變形和文字細節流失。它屬於一個文字轉 3D 的框架,目標是把文字描述變成可渲染的 ego-centric 場景,而不只是產出幾張彼此關係鬆散的圖片。

現有做法常見問題,是多視角之間重疊不足,或者 equirectangular projection 容易在上下邊界拉扯變形;DreamScene360 一類方法也會出現結構扭曲。CGGS 的取向是先用 MV-LDM 生成更一致的多視角 2D 內容,再配合 optical flow、point-track correspondence、深度估計與 3D Gaussian optimization,把粗略 layout 逐步修到可用的 3D Gaussian Splatting(3DGS)場景。

它的流程大致可理解為三段:Ego-centric Generator 負責貼近文字的多視角內容,Layout Decorator 由影像關係推回 dense point clouds,Geometric Refiner 再用 Mutual Information Depth Loss(MID)和 hierarchical optimization 修正幾何與畫質。部署和測試層面,儲存庫已提供實作,並可透過 prompt 檔、視角水平視野 --fov 與垂直軸旋轉角 --deg 控制生成條件,較適合研究、實驗室或要評估 text-to-3D 工作流的人。

  • 走的是 ego-centric 3D scene generation,不是單純全景貼圖
  • 核心差異在 MV-LDM 一致性訓練,加上 3D Gaussian 幾何優化
  • 提供可調視角參數,能用文字檔批量測試不同場景
  • 適合做 3D 內容生成、novel view synthesis 與方法比較

效能數字也有說服力。README 列出的結果中,CGGS 在 CLIP Score 26.253、Q-Align 0.839、PSNR 37.345、SSIM 0.977、LPIPS 0.0193 取得最佳表現,代表它不只文字對齊較好,重建品質與新視角渲染穩定度也更高;不過這仍然是研究型項目,離通用內容製作工具還有一段距離,較大的價值在於它清楚示範了如何把多視角生成與幾何重建更緊密地接起來。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 3D, 中國, Dataset 數據集

Page 74 of 183
1 … 72 73 74 75 76 … 183