CrossViewTokenFusion:乳房 X 光雙視角分類新路線

同一個病灶在兩張乳房 X 光角度入面,線索未必一致。CrossViewTokenFusion 想處理的,正正是點樣保留兩個視角各自訊息,再逐層交換關鍵證據。

Repository image for PartAI-Projects/CrossViewTokenFusion

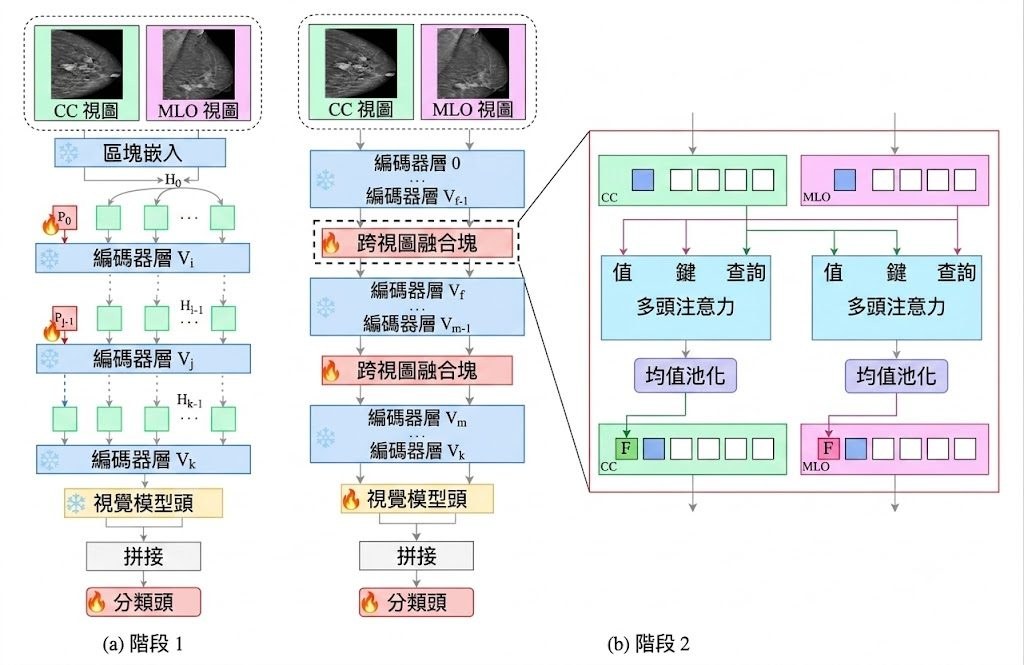
臨床判讀乳房 X 光唔會只望單一角度,但不少多視角方法仍然偏向把特徵提早合併,或者只做一次 cross-attention,結果容易把 view-specific 線索同共享資訊混埋。CrossViewTokenFusion 屬於醫學影像分類模型/研究原型,針對 dual-view mammography classification,重點係讓 CC 與 MLO 兩個視角以 token 為單位逐步交換資訊,而唔係一開始就粗略融合。

項目建基於 frozen MedSigLIP vision model,採用兩階段流程:先做 deep prompt learning 適配,再做 cross-view token-based fusion。作者批評既有 multi-view learning 常見的 feature-level aggregation 同 single-stage cross-attention 互動太淺,於是改用 dedicated fusion tokens 作為中介,透過 cross-attention 在多個 transformer 深度反覆傳遞雙向訊息,之後再把 fusion tokens 放回 token sequence 繼續細化。

部署要求先準備 VinDr-Mammo 或 CMMD(Chinese Mammography Database),再做 preprocessing、stage 1 訓練、stage 2 訓練,最後載入 checkpoint 測試。

它比較適合做醫學影像研究、醫療 AI 團隊驗證多視角融合設計,未見到直接面向臨床系統的封裝介面。

  • 舊範式多數用 feature-level aggregation 或單層 fusion;這個項目改為 multi-depth token 互動
  • 以 frozen vision transformer backbone 配合 prompt learning,取向係少改主幹、多做適配
  • 公開資料集包括 VinDr-Mammo 同 CMMD,方便學術重現與橫向比較
  • VinDr-Mammo BI-RADS classification 達到 50.40% F1-score、0.8090 AUC
  • 相比 dual-view fusion baseline,二分類設定下 AUC 提升 0.10

它的價值係重新定義雙視角點樣溝通:保留各自結構,再用 fusion tokens 逐層傳遞互補證據。
GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Medical醫學

OmniTacTune 用觸覺補上視覺機械手

只靠鏡頭學到的機械手,遇上插孔、開蓋這類接觸動作很易失手。OmniTacTune 用短時間真機強化學習,加上一層觸覺修正,專門補回這段最難的細節。

Og image

做到看得見路徑,未必做得到插得準、扭得開。OmniTacTune 屬於 Robotic 項目,處理的正是視覺策略在接觸密集操作上的短板:鏡頭能提供整體動作方向,但一到真正碰撞、受力、卡位的瞬間,就需要觸覺去補足判斷。

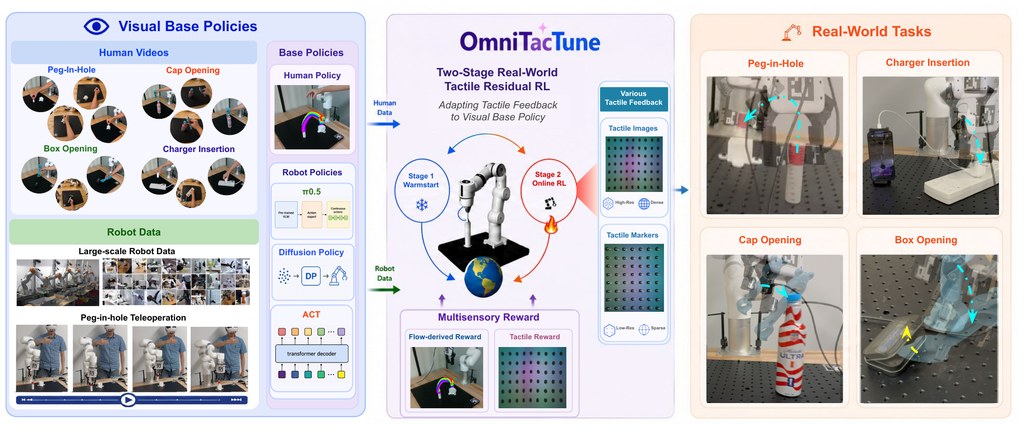
它的取向幾清晰:不重訓整個 visuo-tactile policy,而是保留已訓練好的 visual policy 作為 motion prior,再用 real-world RL 學一個輕量 tactile residual correction。這種做法的價值,在於可以直接疊加到不同基礎策略上,包括 ACT、Diffusion Policy (DP) 與 Flow Policy,亦能配合來自 human video 或 teleoperation data 的視覺基礎能力。

項目示範了四類 contact-rich tasks,包括 peg-in-hole、charger insertion、cap opening 同 box opening。公開結果指出,系統可在約 40 至 80 分鐘內於真機完成適應訓練,而且有一段 one-take online RL 示範,訓練過程不需要為鏡頭刻意重設場景,重點放在由較弱的 base policy 持續練到較可靠的接觸操作。

  • 凍結 visual base policy,只學 tactile residual,減少重訓成本
  • 可接到不同 observations、architectures 同 action-chunk horizons 的基礎策略
  • 適合插入、開蓋、開盒這類依賴接觸幾何與受力回饋的工作流
  • 使用 human video 與 teleoperation data 訓練的基礎策略都可接入

這個項目最受用的場景,是手上已經有視覺模仿學習策略,但卡在最後接觸成功率的人。現有資料顯示,它強調的是通用接入能力與真機短時適應,而不是用大量觸覺資料由零開始建模;取捨也很明顯,系統價值集中在「最後一里」修正,前提仍然是 base policy 本身已具備基本動作先驗。

項目主頁

Categories: 模型訓練, Video, Robotic, 教學

SPLASH 讓小型 MLLM 學會觸覺

SPLASH想處理的,不是單純加一個感測模組,而是令小型多模態模型學觸覺時唔會忘記原本的視覺語言能力。你可以把它理解成一種有節制的微調方法,專門避開災難性遺忘。

figure

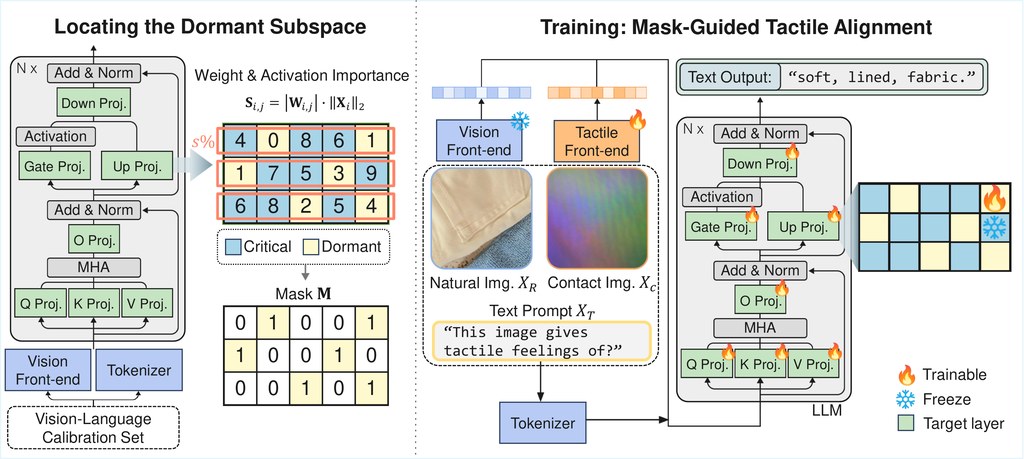
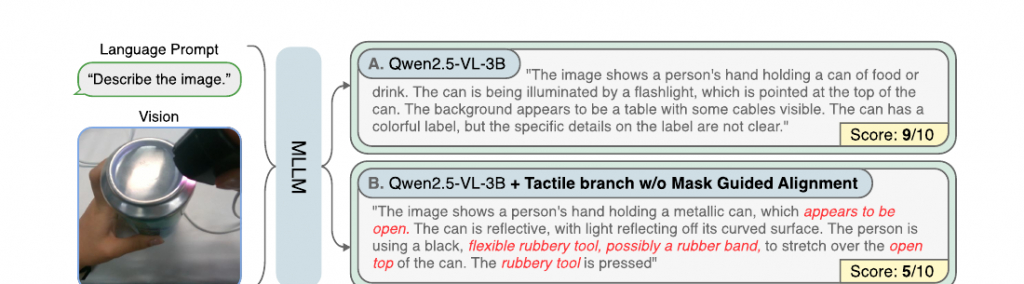
想將觸覺資料接入小型多模態模型,最麻煩的地方往往不是接唔接到,而是模型一邊學「摸到乜」,一邊把原本「睇到乜」的能力搞亂。SPLASH屬於模型訓練框架,針對的正是 MLLMs 在加入 tactile perception 後容易出現的 catastrophic forgetting,目標是在保住 vision-language 能力之下完成 visuo-tactile 對齊。

它的取向幾清楚:唔係全面重訓,也唔係隨便加一條 tactile branch 就算,而是先在 LLM backbone 入面找出較「沉睡」的參數空間,再把觸覺學習限制在呢部分。項目提到它用 weight 與 activation importance scoring 生成 dormant masks,之後做 mask-guided sparse training;好處是唔使大幅動到關鍵視覺語言參數,代價則是整個流程仍然偏研究型,部署前要先備好資料集、分割資料,同時需要 CUDA 12.0 以上與至少兩張 GPU 做分散式訓練。

現有版本主要有兩個模型變體:SPLASH-1B 以 InternVL2.5-1B 為 base MLLM,SPLASH-3B 則建基於 Qwen2.5-VL-3B,兩者都配合 ViT-Tiny + MLP adapter 作 tactile frontend。資料部分亦唔算輕量,除了 LLaVA-CC3M-Pretrain-595K 與 CC3M 用來生成 mask,仲要配合 Touch-Vision-Language-Dataset、TacQuad 等項目做訓練與 OOD 評估,所以它比較適合做多模態研究、機械感知、或想驗證觸覺—視覺聯合推理的團隊。

  • 重點不在新增多少參數,而在把觸覺更新隔離到 dormant subspace
  • 基底模型包括 InternVL2.5-1B 與 Qwen2.5-VL-3B
  • 觸覺前端採用 ViT-Tiny + MLP adapter
  • 評估覆蓋 SSVTP、TVL、TacQuad,並強調保留原有通用能力

以公開資訊判斷,SPLASH最值得留意的不是單一 benchmark 分數,而是它明確押注「non-destructive modality expansion」:讓模型多學一種感官,而唔需要用視覺能力做交換。對打算在緊湊參數預算下擴展 MLLMs 感知模態的研究項目而言,這個方向比單純追高表現更有參考價值。

項目主頁 · GitHub

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

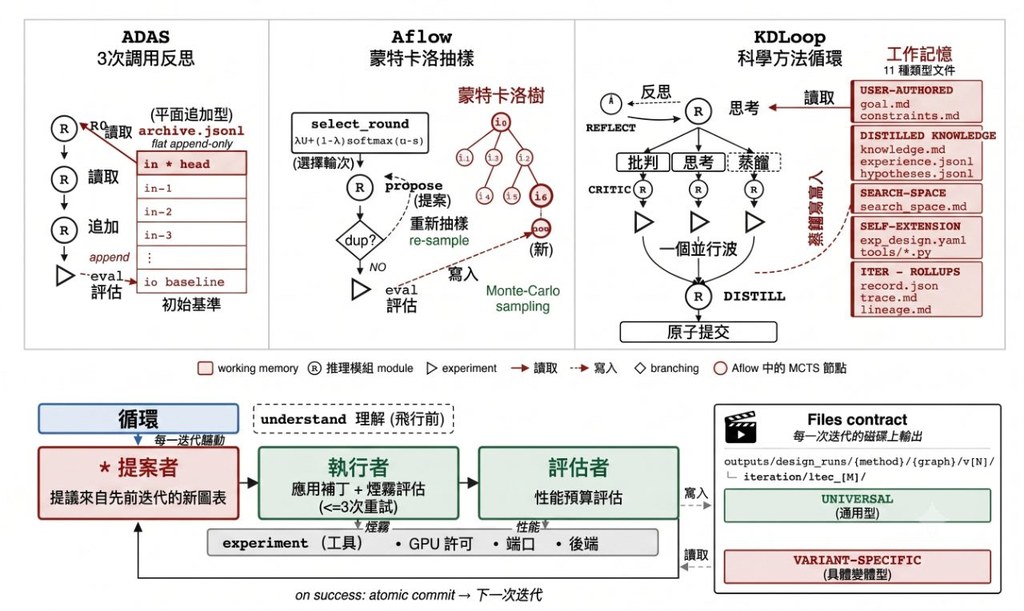
這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

SciReasoner architecture overview

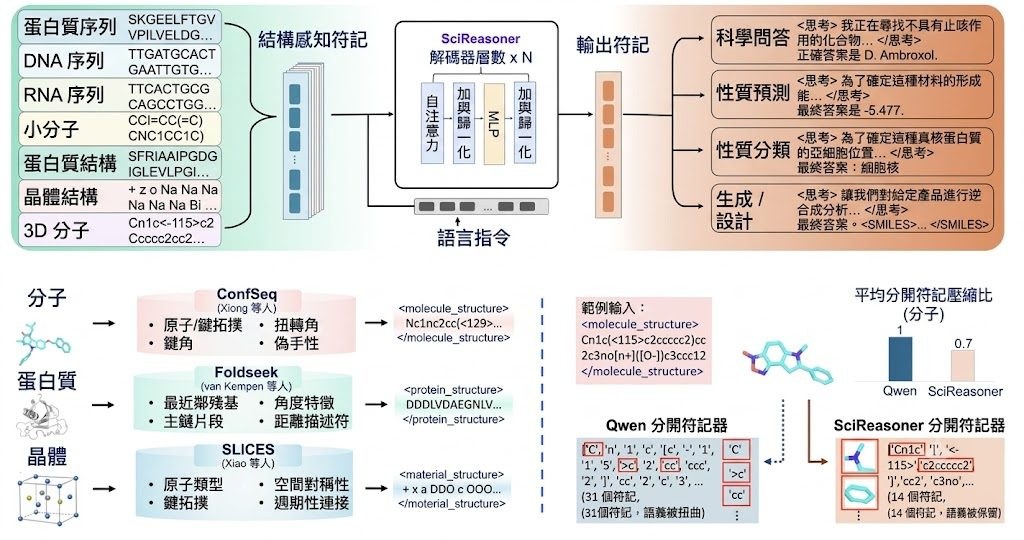
只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

WildCity 把城市級空間智能拉回真實街道

想做城市級重建或模擬,最缺的往往不是模型,而是夠大、夠亂、又貼近真實道路的資料。WildCity正好補上這個缺口。

wild city

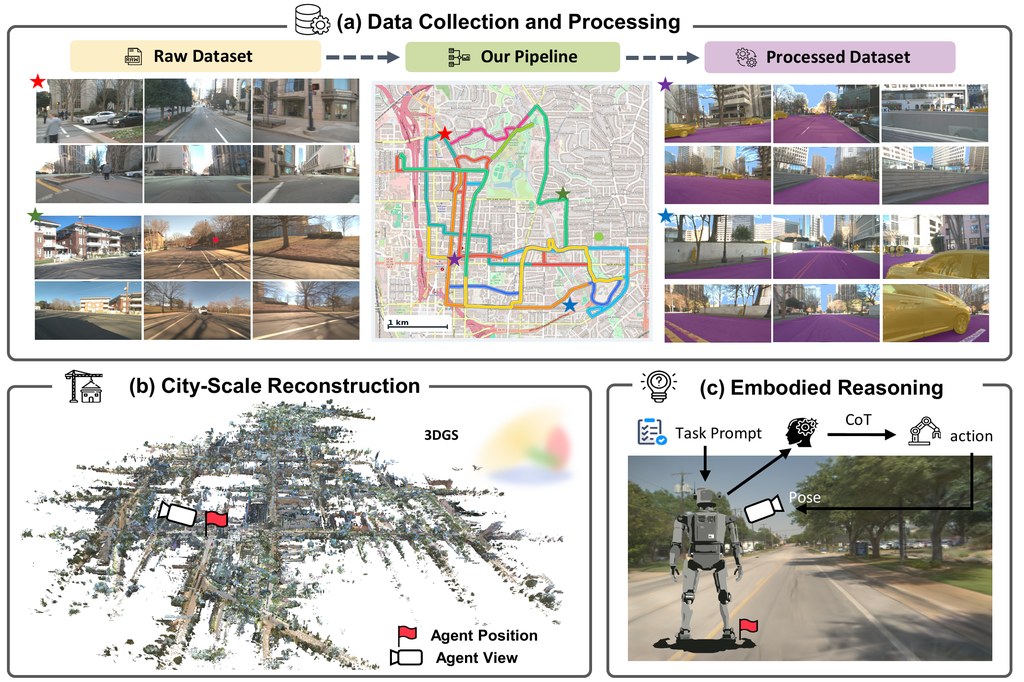
做城市級重建最麻煩的,不是把街景拼得靚,而是要在車流、光線變化、模糊影像同定位誤差同時存在時,仍然保留可用的空間結構。WildCity屬於Dataset 數據集兼研究測試平台,重點不是展示單一模型,而是提供一套面向真實城市環境的資料、重建基線與 closed-loop simulator,處理 rendering、simulation 同 spatial intelligence 之間長期脫節的問題。

這個項目的價值,在於資料規模同場景難度一齊拉高。,它覆蓋美國 6 個城市、18 段長距離行車軌跡、合共 1,507 公里,並整理成 3.01M synchronized keyframes,配合 6 個環視鏡頭、LiDAR、IMU 同 GPS。對研究團隊而言,這不只是多模態資料集,亦是一個可以檢查城市級 reconstruction、extrapolated rendering 與 embodied reasoning 能否真正落地的共同基準。

跟不少較乾淨、較短路段的資料集相比,WildCity的取向明顯更偏向「野外條件」:dynamic objects、lighting and appearance changes、motion blur、imperfect poses 都保留下來。代價是結果未必容易做得好看,但好處是更接近自動駕駛車隊、數碼孿生同機器人模擬會遇到的現實限制。它也不是即插即用型工具,因為 README 已寫明 code、dataset access 同 baseline 仍在準備釋出。

[ECCV26] WildCity: A Real-World City-Scale Testbed for Rendering, Simulation & Spatial Intelligence
  • 以真實車隊採集的城市級多模態資料為核心,而非單一演示場景
  • 除了資料集,亦規劃 urban-tailored 3D Gaussian Splatting baseline 與 closed-loop simulator
  • 適合測試大範圍 reconstruction、rendering 外推與 embodied reasoning
  • 現階段較適合先追蹤研究與評估設計,完整部署流程仍要等官方釋出

現時可以把 WildCity 理解為一個正在成形的基礎設施項目:資料已公開描述,Hugging Face 亦有資料集入口,而官方儲存庫之後會補上 loaders、evaluation scripts、reconstruction baseline 同 simulator。相關模型方向目前最明確的是 urban-tailored 3D Gaussian Splatting;若你做的是自動駕駛感知、城市數碼孿生、robotics simulation 或 spatial intelligence,這套基準值得提早留意,因為它測的不是理想條件下的漂亮結果,而是城市尺度下能否持續運作。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 世界模型, NVIDIA, Robotic, 3D, Dataset 數據集

LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

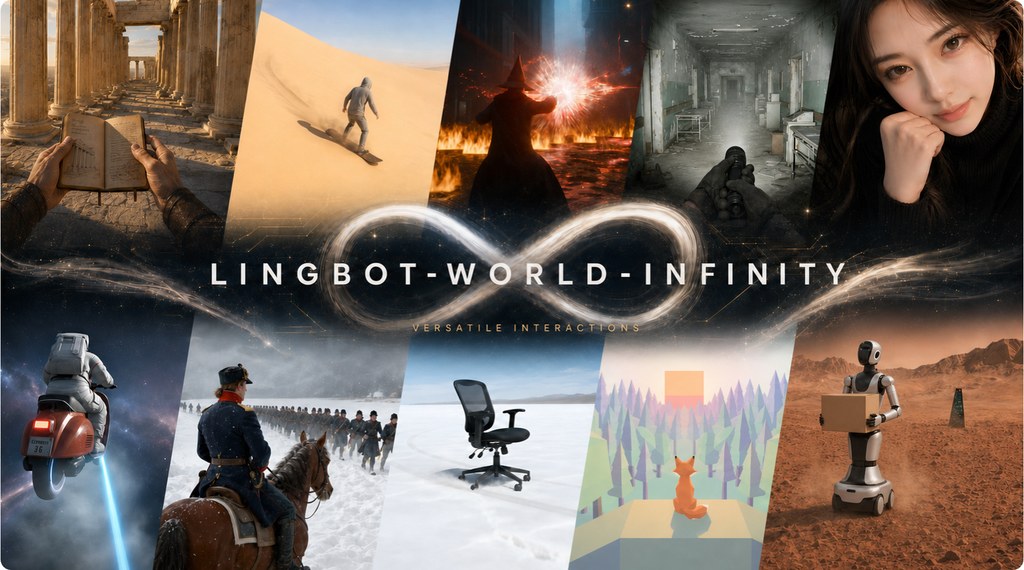
最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

LingBot-Video 想做懂物理的生成影片

首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

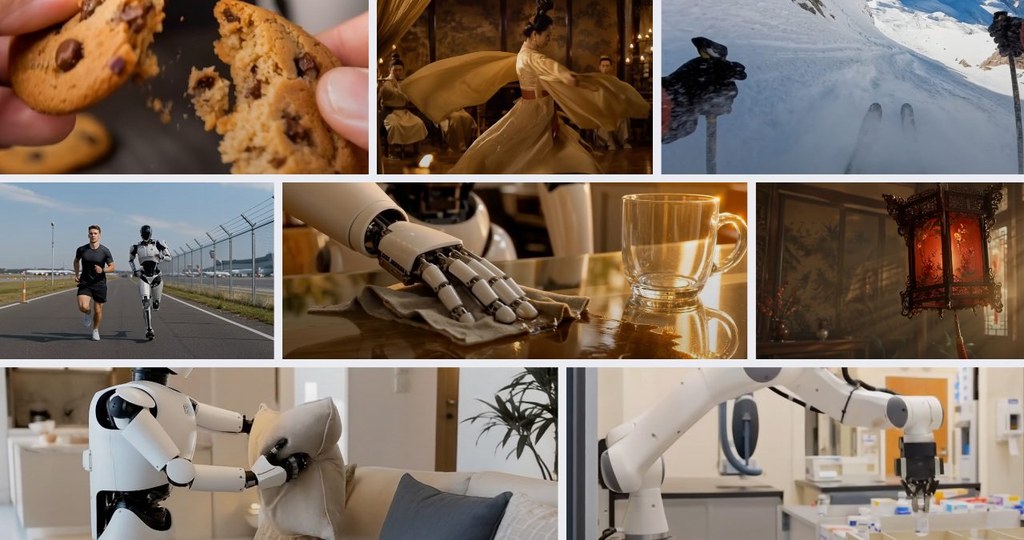
生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-Dense 同 LingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

vLLM 新後端跑出原生級速度

同一份 transformers 模型實作,依家可以直接食到 vLLM 的高速推理。對部署大型語言模型的人而言,少咗移植工序,吞吐量亦未必輸原生實作。

Og image

卡位一直在於:想用 vLLM 的高吞吐推理能力,過去往往要為個別模型寫或等專用實作。呢篇內容講的是 Hugging Face 把 transformers 直接作為 vLLM 的 modeling backend,而且頁面沒有提供 base model 資訊,因為它不是單一模型頁,而是針對推理後端整合的技術更新。

重點價值很直接:模型作者只要已有 transformers 實作,就有機會不用再額外移植到 vLLM,也能拿到接近原生,甚至更快的推理表現。對 LLM 與 VLM 都有意義,因為 serving 設定基本不變,只是加入 --model-impl transformers 旗標。

文中展示了三組 Qwen3 測試:Qwen3-4B 單 GPU、Qwen3-32B 以 tensor parallelism 跑 2 GPU,以及 Qwen3-235B-A22B-FP8 Mixture-of-Experts 在同一個 8×H100 節點上以 data parallelism 加 expert parallelism 執行。結果指向同一件事:transformers backend 的 throughput 已經追平或超過 vLLM 手寫 native implementation。

  • transformers 已支援 450+ architectures,角色像參考級 modeling library
  • vLLM 繼續負責 continuous batching、custom attention kernels 等高效推理優化
  • 啟用方式很簡單:升級 vllm,並在 serve 時加入 --model-impl transformers
  • 可與 --tensor-parallel-size、--data-parallel-size、--enable-expert-parallel 一起使用

取捨亦要講清楚:頁面重點在 backend 整合與效能展示,不是 GGUF 發布頁,所以沒有提供 GGUF 格式、量化等級、mmproj、chat template、MTP draft speculation 或 LM Studio/Ollama/llama.cpp 檔案資訊。硬體需求方面,示例至少涵蓋單 GPU、2 GPU,同埋 8×H100 節點;不同模型是否都能複製同樣增益,仍要視架構與部署環境而定。

項目主頁 · GitHub

Categories: 開源, Qwen, 框架, Ollama, Python, 庫

GitHub Copilot 桌面 app 全面開放

而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。

項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

Page 73 of 183
1 … 71 72 73 74 75 … 183