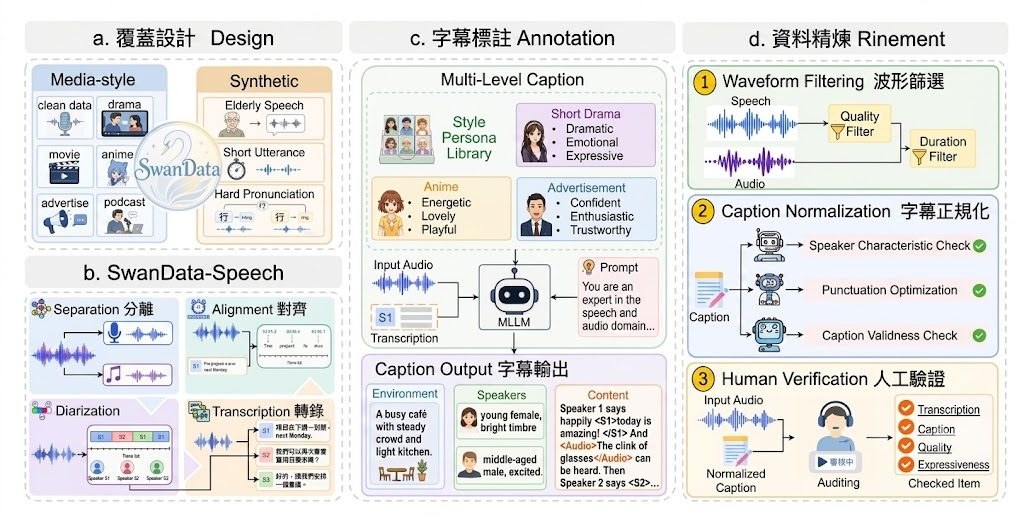
SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。
項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

N0-TWAM 把觸覺帶進機械人決策

鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

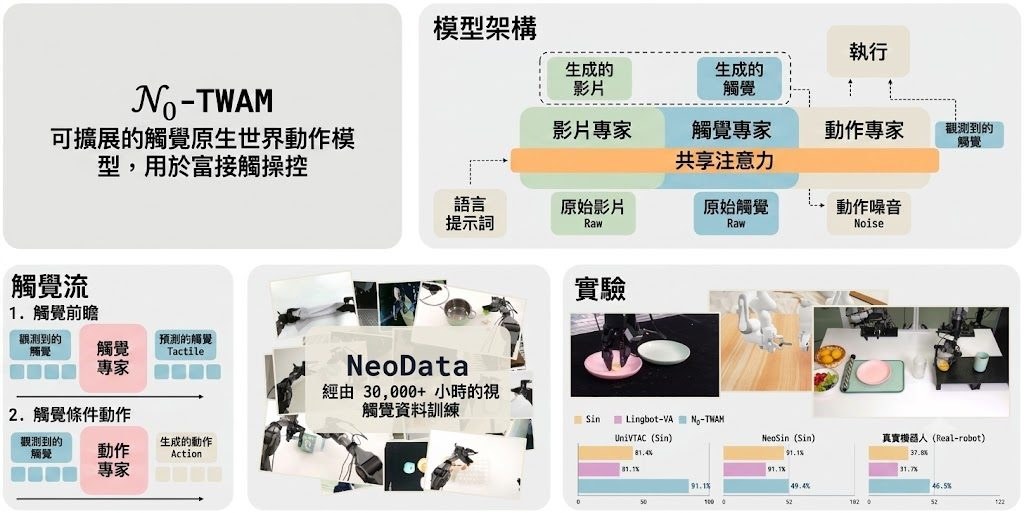
插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

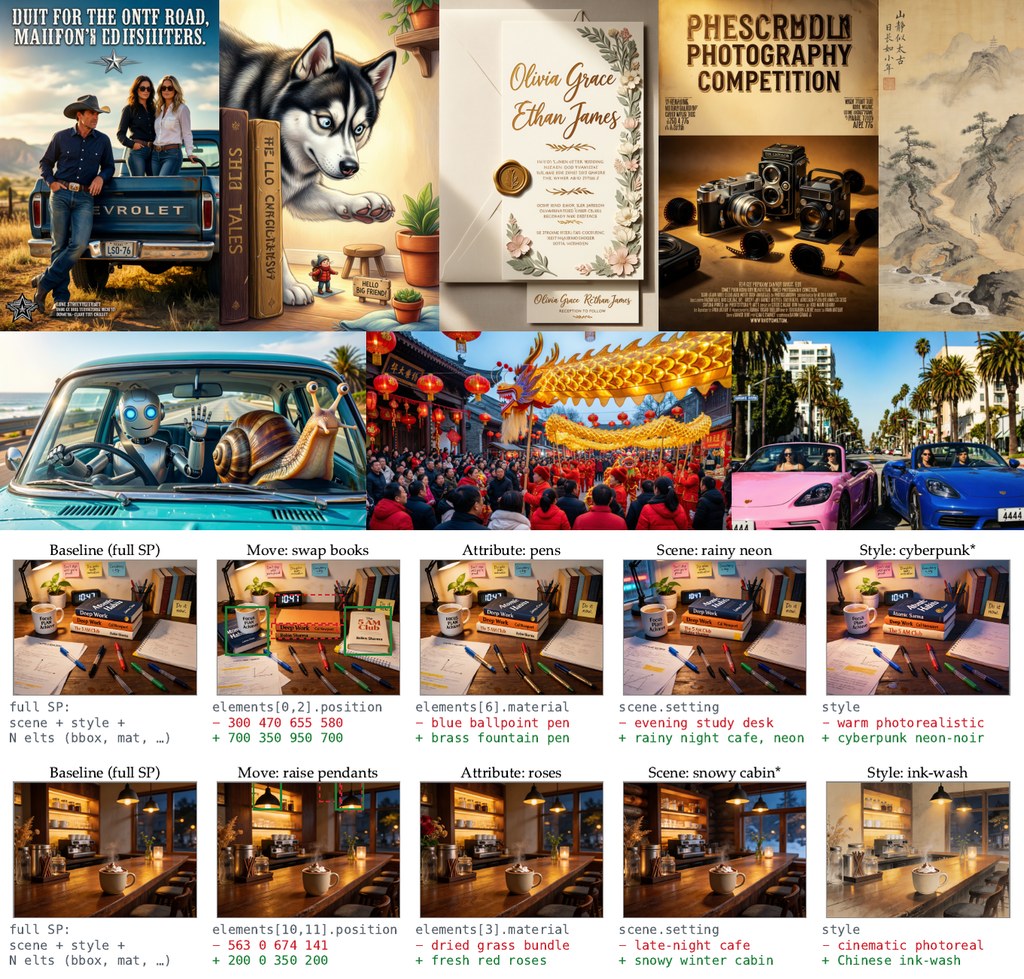
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

Canvas UI 把互動介面搬上 WebGL 畫布

想為網站加上流體、玻璃或粒子效果,又不想犧牲可點擊與可選取內容,Canvas UI 正在試一條幾少見的路。

Canvas UI

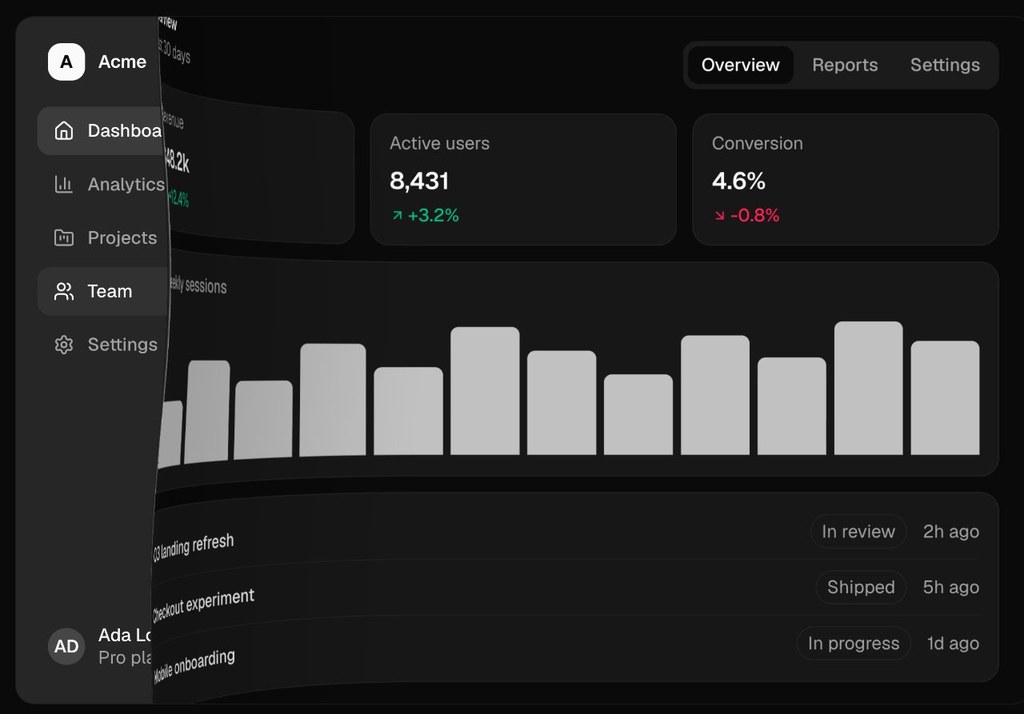
網站想做得更有動感,最麻煩往往唔係效果本身,而係效果一蓋上去,文字選取、連結點擊同原本互動就容易受影響。canvas-ui 針對的正是這個位置:它屬於開源 UI 元件庫,用 html-in-canvas 同 WebGL 把流體模擬、shader effects 同 3D scenes 疊加到現有介面之上,重點是盡量保留 live DOM 的互動性。

它吸引人的地方,不止是畫面夠華麗,而是部署方式相對直接。元件可在 React、Solid、Preact、Vue、Svelte 同 vanilla TypeScript 使用,官方提供 Docs、Components 同 Playground,亦支援透過 shadcn CLI 拉入完整原始碼,代碼會直接落到你的項目,之後可自行改 props、樣式甚至拆開重寫,唔需要長期綁死某個套件版本。

取捨同樣寫得很清楚。依賴 live HTML redraw 的元件,要用到實驗性 HTML-in-canvas API,現時主要在 Chrome 配合 flag 才能完整啟用;去到其他瀏覽器,內容會退回一般 HTML 顯示,而部分效果仍可作為純 WebGL overlay 繼續運作。換句話說,它比較適合重視前端體驗、願意接受瀏覽器能力分層的品牌網站、作品展示頁,或者想在既有介面上加入視覺層次的互動項目。

  • 提供約 33 個元件,涵蓋 Blaze、Liquid Glass、Particle Reveal、VHS 等效果
  • 同一套元件邏輯對應多個前端框架,方便跨技術棧重用
  • 以 GPU 上的 WebGL 動畫為核心,減少主執行緒長時間負擔
  • 可配合 shadcn MCP server,讓支援 MCP 的 assistant 直接查閱與安裝元件

運行策略:能用 WebGL 的效果盡量放到 GPU,瀏覽器不支援完整能力時再優雅降級。這令 canvas-ui 比一般只做靜態裝飾的元件庫更進取,但也代表它未必適合每一個企業後台或追求一致瀏覽器表現的介面;放在重視體驗展示的 UI/UX 項目,價值會更明顯。

項目主頁 · GitHub

Categories: 開源, MCP, API, 3D, UI/UX

Reasonix:DeepSeek AI 編碼 agent,用 cache-first 降低長會話嘅 token 成本

Reasonix 係 DeepSeek 嘅終端 AI coding agent,以 cache-first loop 壓低長會話嘅 token 成本,適合反覆改碼、工具呼叫同團隊迭代。支援 CLI/TUI、桌面、Web UI 同 ACP 編輯器整合,配合 /plan、MCP 同 sandbox 權限控制。

Reasonix

Reasonix 是 DeepSeek 一個面向桌面及終端的 AI coding agent,核心價值唔係花巧介面,而係將長會話裡不斷累積的上下文成本壓低。它適合要一路改檔、一路試工具、一路追問模型的人,特別是團隊日常做修補、重構同埋持續迭代時,對 token 成本同回合延遲都會有明顯感受。

Reasonix 主打 cache-first loop,令 prompt 前綴保持 byte-identical,配合 DeepSeek 的 prefix cache 去提升長會話命中率。項目同時提供 CLI/TUI、桌面端、local browser UI,同埋支援 ACP-compatible editor integration,部署方式亦算直接:CLI 可用 npm 安裝,桌面版則有 macOS、Windows、Linux 套件可選。

Deepseek's ~OFFICIAL Code: RIP Claude,Codex! This is CRAZY GOOD!

Reasonix 唔係純粹包住模型嘅殼,而係圍繞工具呼叫修正、成本控制同 sandbox 權限去設計。/plan 會先要求模型規劃,再進入實作;MCP(Model Context Protocol, MCP)亦作為一等入口,方便把外部工具合入同一個 registry。這種做法較適合重視可控性、可追蹤性,亦需要長時間跑 session 的開發流程。

要留意嘅係,呢條 TypeScript 線已經進入 maintenance mode,主力開發搬去 Go rewrite,同步文件亦指向 main-v2 同 migration guide。現時更合理嘅理解方式,係將佢視為一個仍可用但已凍結方向的終端編碼 agent 版本,重點價值在 cache 效率、工具整合與成本壓縮,而唔係追求最新功能擴張。

  • 長會話下,prefix cache 命中率可維持在 90%+,輸入 token 成本可明顯下降
  • 同一套引擎可喺 CLI/TUI、桌面端、Web UI 同編輯器接入使用
  • /plan、權限控制同 workspace sandbox 一齊限制工具呼叫,取向偏向可控
  • 適合經常改碼、反覆驗證、又在意推理成本嘅個人或團隊

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, DeepSeek, Vibe Coding, Mac, Linux, 編程

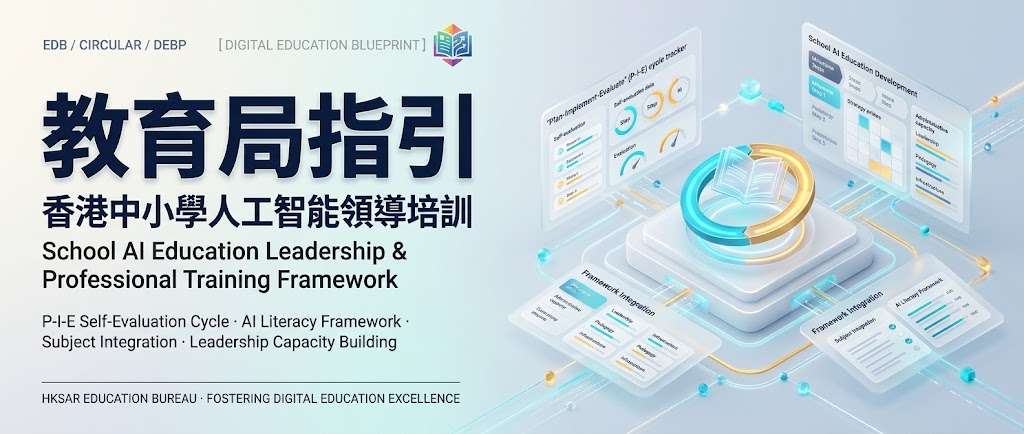
[教育局指引] 香港中小學人工智能領導培訓

教育局推出 2026 年 7 月至 9 月的培訓,支援教師提升 AI 教學能力,亦協助學校領導層制定校本規劃與推行策略。

Hero image preview

學校要把人工智能融入課程,除了提升教師的 AI 素養,也要安排課程、評估和校本發展計劃。教育局第 107/2026 號通函公布 2026 年 7 月至 9 月的首期培訓,涵蓋教師專業發展、學校規劃,以及領導層推動數字教育的能力。

培訓分為基礎及進階「人工智能素養」、「人工智能+科目」和「人工智能領導」等方向。領導培訓設有「策動篇」研討會和「實踐篇」工作坊,對象包括校長、副校長及相關中層人員,協助學校按照校情和學生需要,把數字教育納入「策劃—推行—評估」自評循環。

「策動篇」會介紹香港數字教育的發展方向,並以學校例子討論如何把《中小學人工智能素養學習架構》融入課程,讓學生學好 AI、善用 AI 及負責任地使用 AI。「實踐篇」則聚焦撰寫學校發展計劃和周年計劃、訂定推行策略與成功準則,以及持續監察成效。

  • 培訓期:2026 年 7 月至 9 月,其他課程資料會陸續公布。
  • 「策動篇」設小學及中學場次,並提供面授與線上同步參與。
  • 面授每場名額 300 人,每校最多 3 人;線上每場名額 1,700 人,每校最多 4 人。
  • 「實踐篇」工作坊按小學及中學分組,供學校領導層和中層管理人員參加。

這輪培訓配合《中小學數字教育發展藍圖》推行。通函指出,2026/27 學年所有公帑資助學校須參照藍圖及相關課程文件,將數字教育納入學校發展計劃及/或周年計劃;各校可按自身需要規劃培訓與推行安排。

項目主頁

Categories: 教學, 香港

beautify-github-readme:GitHub README 也可以做成精美首頁

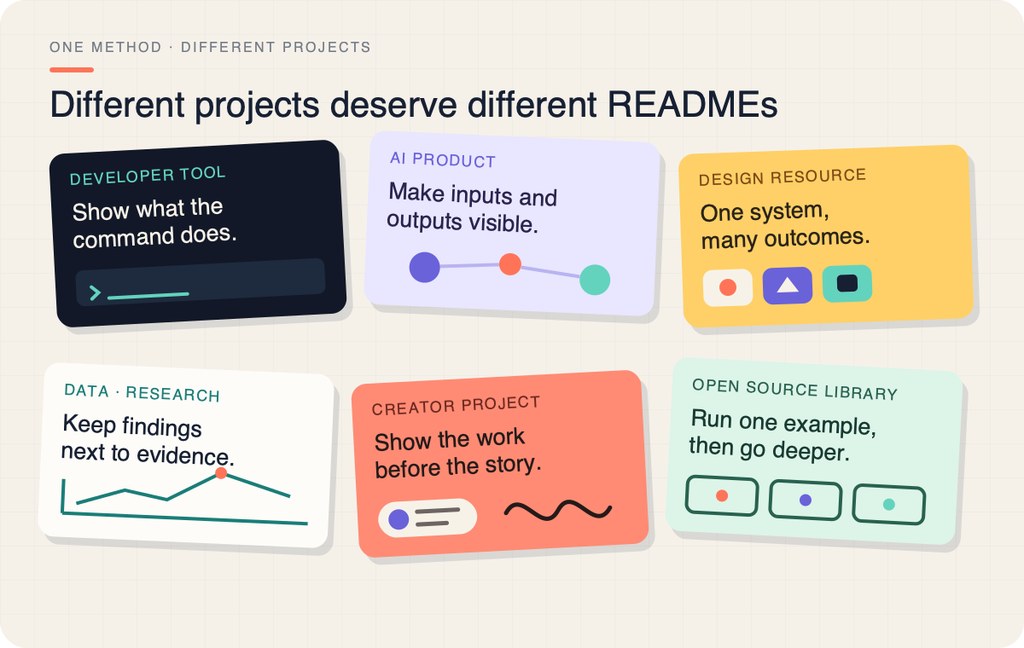
beautify-github-readme 唔係交模板咁簡單,而係教你用項目本身嘅內容同視覺語言,重寫 README 第一眼體驗。

Beautify GitHub README: help visitors understand a repository at first glance.

讀者未打開程式前,往往先被 README 決定去留;beautify-github-readme 正正針對呢一步,屬於一個 README 設計與寫作 Skill,重點唔係美化排版,而係令訪客一眼睇明項目做乜、成果去到邊、應該點開始理解。

佢同常見 README 範本最大分別,在於唔追求統一風格。呢個方法會由項目自身延伸出字體、配色、構圖同證據展示,連 opening screen 都強調真實輸出,而唔係抽象口號。README 入面列出八個公開儲存庫案例,涵蓋 AI 產品、設計資源、研究與開源庫,證明佢不只是概念展示。

  • 重點唔係套版:每個 README hero 都按項目內容重新設計
  • 強調真實證據:用實際 UI、圖示、地圖、角色圖或 dashboard 截圖說明能力
  • 適合公開展示型項目:尤其係要吸引首次訪客、招募協作者或交代成果脈絡嘅團隊
  • 門檻在內容整理:要先有清楚成果、流程同視覺素材,效果先會成立

部署方式比較似參考方法而唔係可直接安裝嘅工具套件;你應該將佢理解成一套可複用的表達框架,再按自己項目改寫。對獨立開發者、開源維護者同想提升 GitHub 展示面的團隊尤其有幫助,因為佢補強咗「功能存在,但讀者三秒內睇唔明」呢個常見卡位。

限制亦相當明顯:佢未提供量化成效、A/B 測試結果或者自動化生成流程,價值主要來自案例說服力,而唔係可驗證指標。當你已經有一定內容資產,同時希望 README 更似產品入口而不只是說明文件,呢個項目比一般範本更值得參考。

GitHub

Categories: 開源, 編程, Skill 技能

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

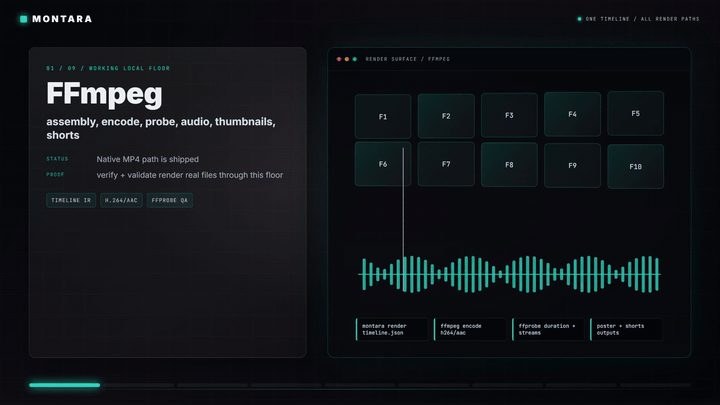
Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

PerceptionBench:Moonshot AI 教你測試 MLLM 視覺盲點

不少多模態模型答得似模似樣,但未必真係睇得準。PerceptionBench 把問題拆到最細,專門量度 MLLM 最基本的視覺感知能力。

kimi small

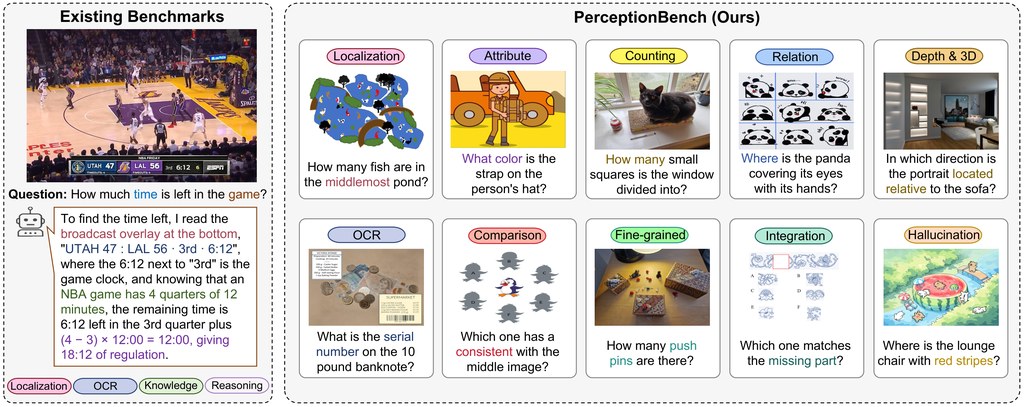
不少 Multimodal Large Language Models(MLLMs)表面上回答完整,但錯誤未必來自推理,往往早在「看圖」那一步已經出現。PerceptionBench 就是一個評測資料集兼 benchmark,專門把視覺感知拆成最細單元,檢查模型究竟係讀錯字、看漏關係,還是出現 perception-related hallucination(Hallu)。

它的價值,在於不再用一個總分掩蓋問題。團隊先分析 42 個現有 benchmarks 的失敗案例,再整理出一套錯誤分類,當中視覺感知分支包含十種 atomic perceptual capabilities,之後用這個框架建立 3,000 條經驗證題目,每題只測一種能力,答案亦刻意保持簡短而明確,盡量避免把推理或背景知識混入結果。

對做模型評估、資料標註或多模態產品調校的人來說,這個項目最有用的地方,是你可以更早定位問題源頭。它不是教你部署模型的工具,而是用來比較模型能力輪廓的尺;資料已放上 Hugging Face,程式碼亦公開,較適合拿來跑 benchmark、重現論文結果,或者把自家模型放入同一套題目做橫向比較。

  • 以 3,000 條 verified questions 測十種 atomic visual perception 能力
  • 題目刻意隔離單一能力,減少推理與知識干擾
  • 共評測 16 個 frontier MLLMs,使用統一 prompts
  • 沒有模型準確率超過 60%,Hallu 表現平均最弱
  • 相近總分之下,不同模型的能力分佈可以差很遠

所有題目都採用開放式短答案,再由 GPT-oss-120B 依參考答案判分,官方指它與人工審核在 300 個樣本上的一致率達 99.7%。這類設計未必等同真實產品場景,但很適合做能力層面的診斷;當你想知道模型到底「唔識答」還是「睇錯圖」,PerceptionBench 提供的資訊比一般綜合排行榜更有分析價值。

GitHub

Categories: 開源, 多模態模型, Dataset 數據集, Kimi

Page 58 of 183
1 … 56 57 58 59 60 … 183