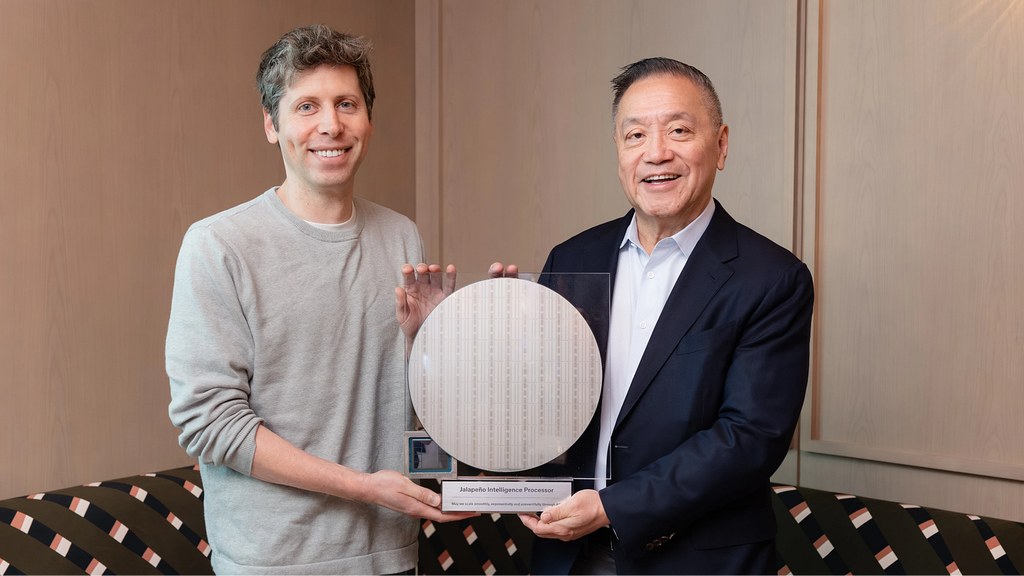
OpenAI Jalapeño:為大型語言模型推理而造的 ASIC

OpenAI 夥拍 Broadcom 打造 Jalapeño,瞄準大型語言模型推理,並以每兆瓦吞吐量挑戰 NVIDIA GPU 的效率優勢。

Og image

當模型推理成本受到功耗和硬件供應限制,單靠通用 GPU 未必能兼顧速度與效率。OpenAI 以空白設計打造 Jalapeño,屬於專為大型語言模型(Large Language Model,LLM)推理而設的應用專用集成電路(Application-Specific Integrated Circuit,ASIC),並非只針對 OpenAI 自家模型。

Jalapeño 由 OpenAI 與 Broadcom 合作開發,設計工作於 2024 年中開始,約 16 個月後完成製造流片。晶片採用 HBM4 高頻寬記憶體,配合硬件與軟件協同設計,目標是在不同模型及推理工作負載下維持高效能,而非過度優化單一推理環節。

在 OpenAI 實驗室以 InferenceX 測試套件進行的基準測試,聲稱 Jalapeño 的每兆瓦吞吐量優於已測試的 NVIDIA、AMD 及 Google 晶片,亦在效能功耗比上勝過 Blackwell。比較時 Jalapeño 沒有使用 Multi Token Prediction(MTP),其他晶片則採用各自最佳配置,因此結果仍需配合完整測試條件理解。

  • 以通用 AI 推理為設計方向,可運行多類模型
  • HBM4 令記憶體頻寬接近高階 GPU 的配置
  • 核心指標聚焦每兆瓦的 token throughput
  • 文章未提供公開下載、安裝或一般用戶使用流程

這類晶片最適合大型模型服務商及資料中心,用於推理量大、電力成本高的工作流。Jalapeño 的價值在於能否把高吞吐量延伸至不同模型和長期運行環境,而不只是單次基準測試中的優勢。
新聞主頁

Categories: 開源, NVIDIA, OpenAI, 新聞

OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

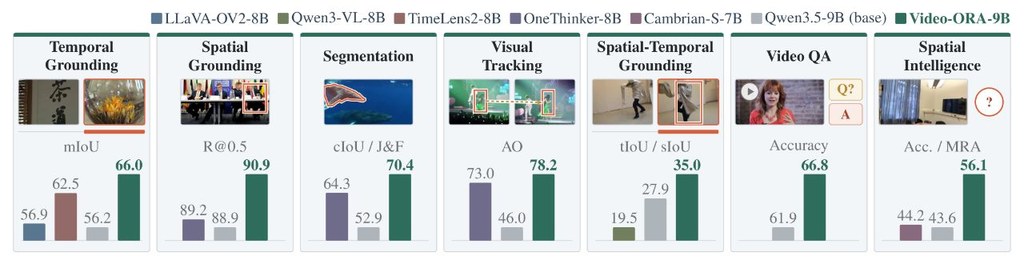
同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

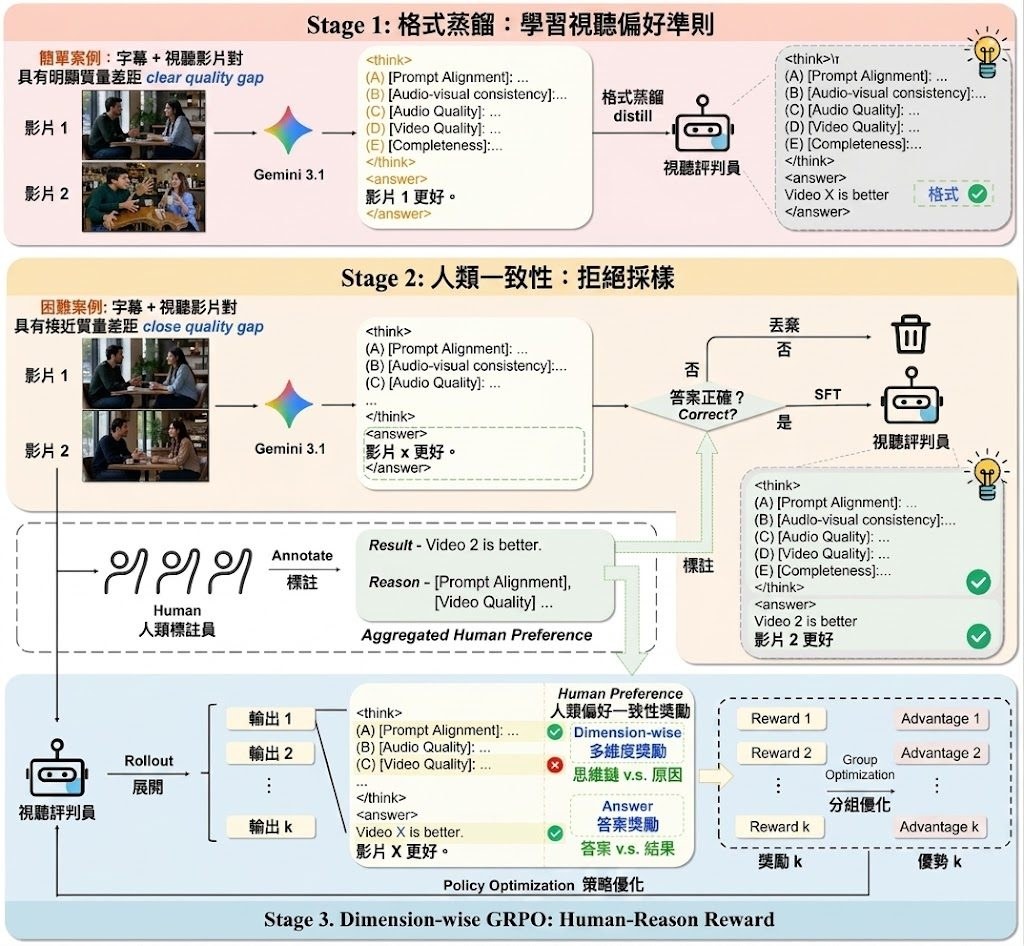
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

小米 AI Cube 以三款玄戒晶片本機運行 2000 億模型

小米以三款自研晶片組成 AI Cube 工程原型,將大型語言模型運算帶到本機,但距離正式上市仍有一段距離。

Og image

小米自 2021 年重啟大晶片研發計劃後,已投入超過 210 億元人民幣,晶片團隊增至近 3,000 名專家。團隊在玄戒晶片技術溝通會展示 AI Cube 工程原型,嘗試處理本機運行大型語言模型時的運算與功耗取捨。

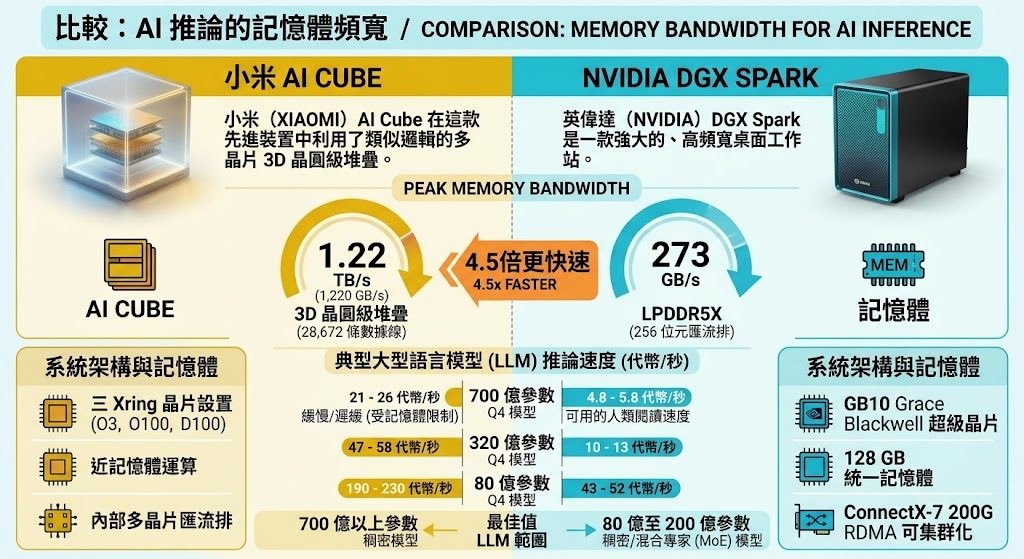
AI Cube 由玄戒 O3、O100 及 D100 三款自研晶片協同工作。O3 負責一般處理與圖像運算,O100 針對裝置端大型模型提供高頻寬加速,D100 則提供高算力 AI 運算及統一記憶體,最高支援 2,000 億參數模型。

原型機持續功耗最高 150W,並可部署 120B 及 3B 兩種規模模型,在快速與慢速系統之間切換,用來驗證不同晶片的分工。O100 的近記憶體運算頻寬最高達 1.22TB/s,官方表示裝置端大型模型推理速度最高可達 330 TPS。

Xiaomi Just Shocked NVIDIA — A Tiny AI Cube Running 120B Locally

對需要本機處理 AI 工作負載、又希望減少雲端依賴的工作流,這種多晶片設計提供另一種方向,但目前仍要留意原型機與正式產品之間的差距:

  • 以三款玄戒晶片分工處理 CPU、GPU、NPU 及大型模型運算
  • 最高支援 2,000 億參數模型,原型機已展示 120B 與 3B 模型配置
  • 持續功耗最高 150W,並支援快速及慢速系統切換
  • 玄戒 O3 已展開規模量產,O100 及 D100 預計 2027 年正式商用
  • 小米尚未公布 AI Cube 的上市時間及售價

Categories: 小米-Xiaomi

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

DiffusionOPSD qualitative gallery

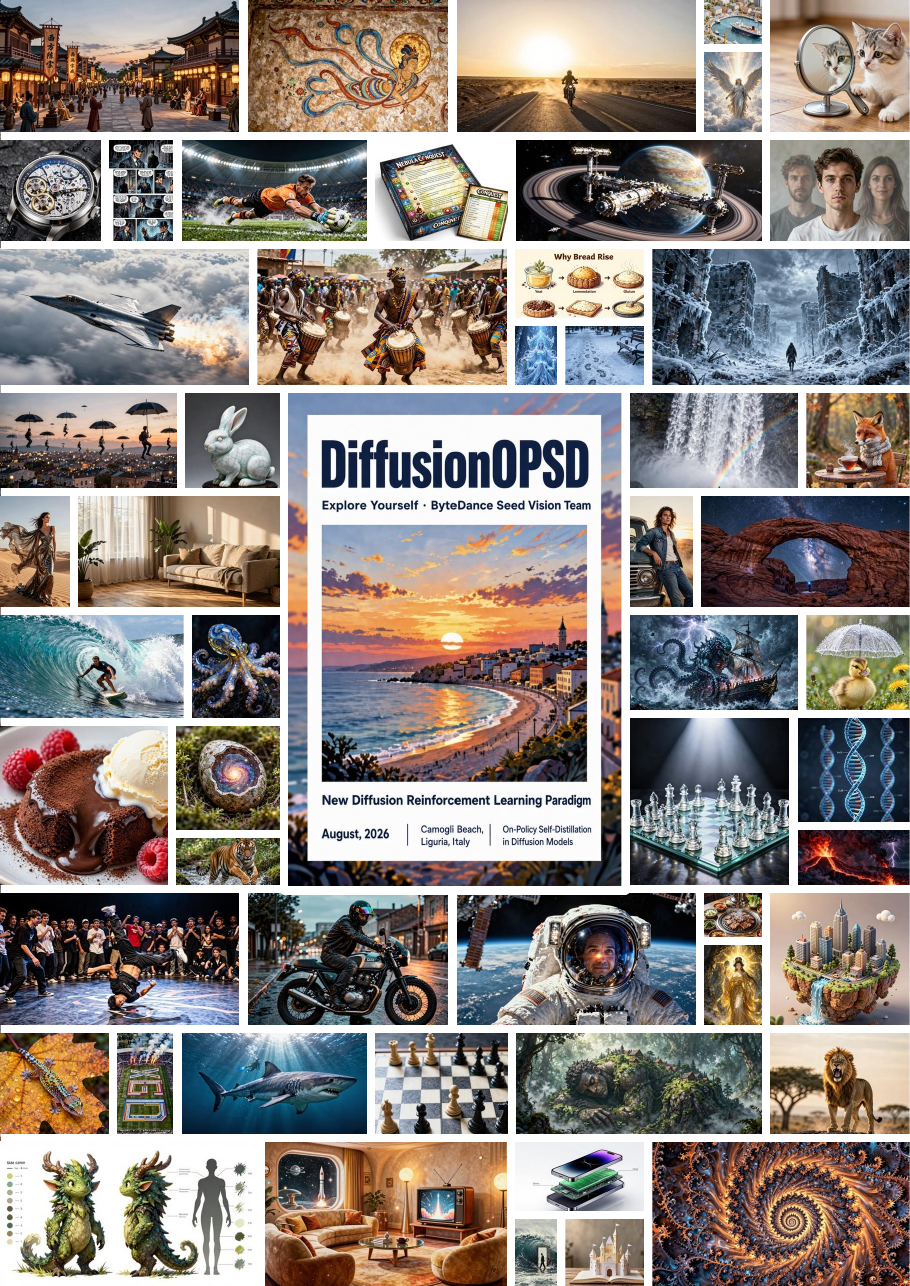
DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

AutoSaddler 重新整理 LLM Agent Harness

AutoSaddler 會從執行失敗紀錄入手,幫 LLM agent 自動調整提示詞、工具同中介層。它唔只修一條路徑,仲會檢查改動能否推廣到其他情境。

AutoSaddler Overall Framework

Microsoft 研究團隊聯同 POSTECH、KAIST 及南方科技大學開發 AutoSaddler,針對長流程 AI Agent 容易因小錯誤累積而失敗的問題,建立自動優化 harness 的方法。

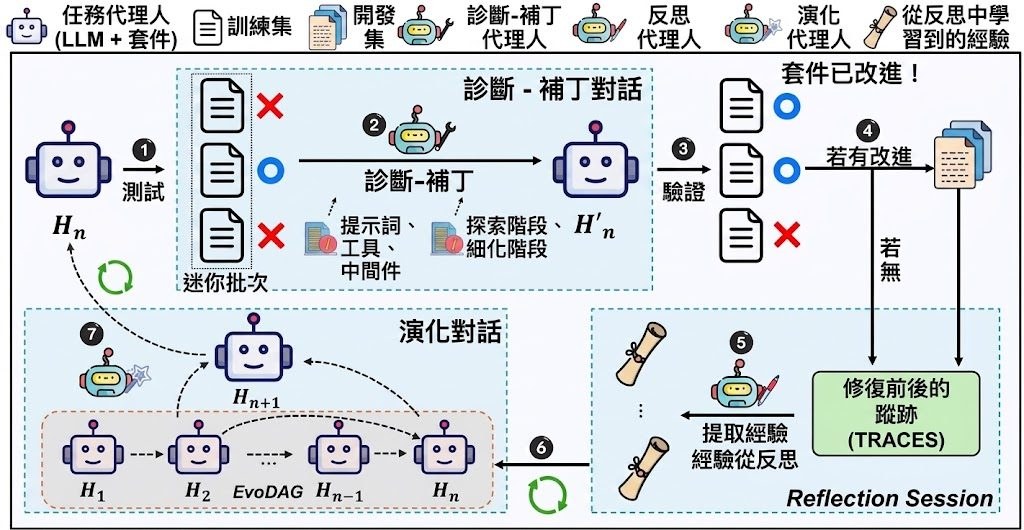
AutoSaddler 係一個用嚟自動優化 LLM agent harness 嘅開源項目,處理嘅係長流程任務入面,agent 因為提示詞、工具或控制邏輯有少少偏差,就一路累積錯誤而失敗呢個問題。佢唔係單靠反覆改 prompt,而係將 harness 當成程式去診斷同修補。

佢會分析執行 trace,找出失敗根源,再按既定補丁分類去改 prompts、tools、middleware 同 agent-loop logic。資料夾同 佢用 durable、plugin-based 方式記錄狀態,適合要反覆試驗、回復同追蹤修改歷程嘅工作流。

同類方法通常只改少量提示詞,AutoSaddler 就將搜索範圍擴大到整個 harness,仲會用 validation 去挑選較能泛化嘅更新。初步結果顯示,佢喺 GAIA2、SWE-Bench Pro 同 Terminal-Bench 2.0 都帶來約 9 到 10 個百分點嘅 Pass@1 提升。

對做 agent 系統、評測框架或者自動化工作流嘅團隊特別有用,因為佢處理唔係單一模型輸出,而係整套執行環境點樣更穩定。項目要求 Python 3.12-3.14、uv 同 Git,官方建議用 uv run 去執行 Python 指令,代表佢偏向可重現同可追蹤嘅研究與工程整合。

  • 以 failure trace 診斷問題,唔係淨係做表面反思
  • 改動範圍包括 prompt、工具、middleware 同 agent loop
  • 會驗證更新喺其他情境可唔可以保持效果
  • 初步 benchmark 結果顯示有明顯提升
  • 適合要持續調整 LLM agent harness 嘅團隊

項目主頁 · GitHub

Categories: 開源, Agentic, 微軟, 框架, 工具, Python, Dataset 數據集

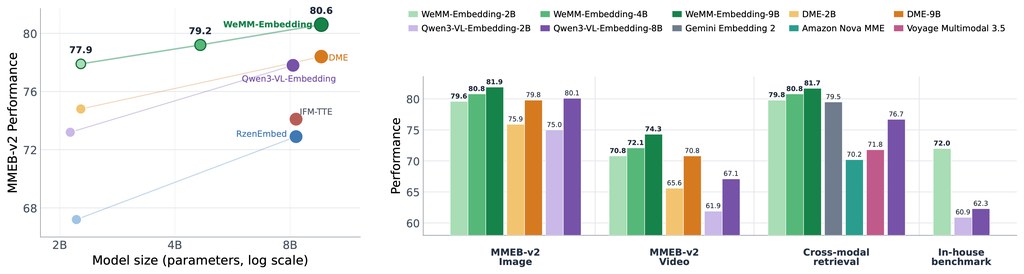
WeMM-Embedding 統一多模態向量

WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

WeMM-Embedding Performance Overview

WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformers 或 SentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

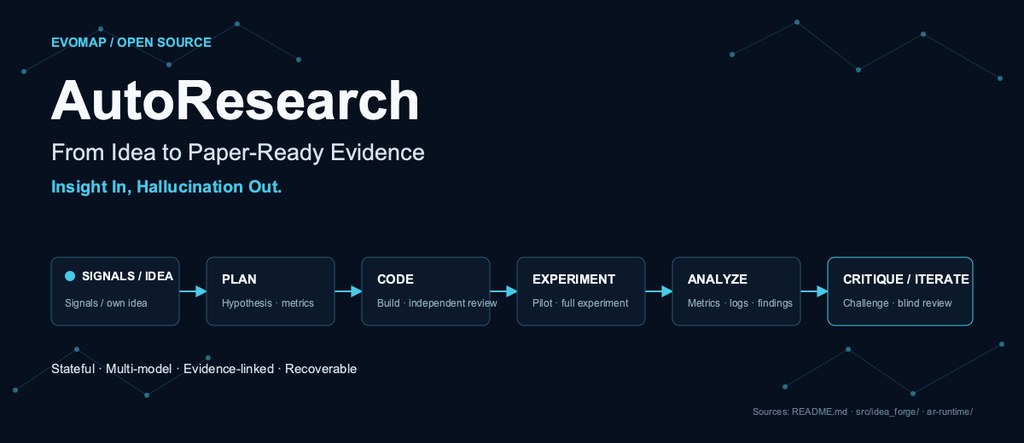
AutoResearch:AI 研究由構思變成可審查證據

由研究方向發掘、實驗執行到獨立評估,AutoResearch 將一連串研究工作串成可追蹤流程。

AutoResearch workflow from a research idea to reviewable evidence

研究者只需提供一個想法,或者讓系統從近期論文、開發者社群及開源趨勢尋找方向,便可把研究構思推進至實驗計劃、程式碼、結果分析和獨立評估。AutoResearch 屬於開源的 AI and machine learning agent workflow,處理的是研究流程分散、難以重現,以及結果未有足夠證據支撐的問題。

流程不止於叫模型產生一份研究計劃。它會整理、去重和篩選網上訊號,再結合 knowledge base/ 內由使用者維護的研究經驗、限制和常見失敗模式,產生候選方向,經過 cross-review 後制定實驗計劃。已有研究想法的團隊亦可以略過發掘階段,直接執行指定項目。

研究計劃、程式碼、run logs、metrics、失敗原因、critic reports 和 blind reviews 都會寫入磁碟,流程亦具備 stateful、recoverable 特性,方便研究者檢查中途結果、接手工作或停止執行。這比一次過要求模型寫完整論文更適合需要反覆試驗的研究項目,但成果質素仍取決於模型、API、資料來源和實驗環境,不能把自動產出的證據視為已完成同行審查。

  • 從近期論文、社群討論及開源趨勢收集研究訊號
  • 以本地 knowledge base/ 補充領域經驗和限制條件
  • 支援由 idea generation.py 啟動構思、篩選及結果更新
  • 透過 config/providers.local.json 配置 endpoint、model alias 和角色模型
  • Python 3.10+,並要求把含 API URLs、keys 和 proxies 的 .env 留在本機

對個人研究者、小型 AI 團隊及需要大量驗證想法的實驗室,AutoResearch 可減少整理資料、安排實驗和記錄結果的重複工作。它更像一個可接管的研究協作流程,而不是單一模型;要測試完整能力,應先準備本地知識庫和模型供應商設定,再由一個小型研究方向開始,檢查生成計劃、執行記錄及獨立評估是否足以支持後續寫作。

GitHub

Categories: 開源, Agentic, API, 框架, Python

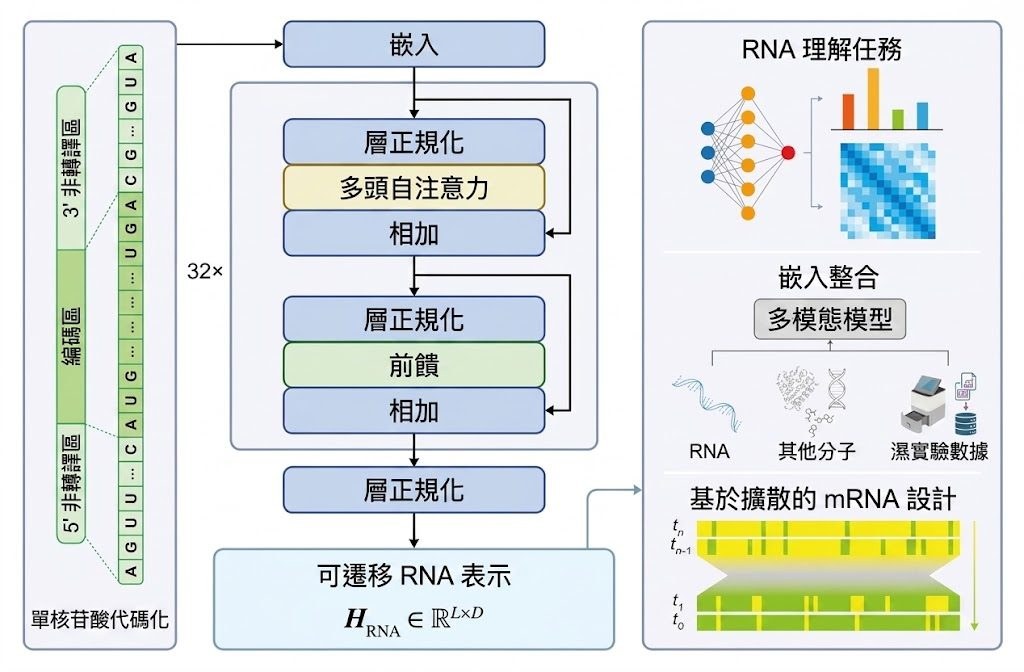
RiboSpan 把長篇 RNA 納入 10K 上下文模型

長篇 mRNA 不再需要截斷處理,RiboSpan 以單核苷酸解析度同時理解完整轉錄本。

RiboSpan architecture

長篇 mRNA 過往容易因約 1K 的上下文限制而被截斷,令 5′ UTR、CDS 和 3′ UTR 無法放在同一個模型視野內。RiboSpan 是一個 RNA foundation model,實際處理的是完整長鏈 RNA 的聯合表示與下游建模問題。

項目採用 1.61B 參數的雙向 Transformer,每層都使用 dense self-attention,並以每個核苷酸一個 token 的方式保留位置對齊資訊。RiboSpan-10K 原生以最多 10,240 nt 的長度預訓練,不依賴推理階段延長上下文;訓練資料包括 6,760 萬條 RNA 序列,合共 857 億個核苷酸,來源涵蓋 RNAcentral、Ensembl 和 Ensembl Genomes。

  • 單核苷酸 tokenization,保留高解析度序列位置
  • Bidirectional Transformer 可同時讀取上游、下游及遠距離資訊
  • RiboSpan-10K 原生支援 10,240 nt 長上下文
  • 不加 task-specific head 或 fine-tuning,frozen representation 在評測中達到 state-of-the-art,長 RNA 尤其突出
  • 以 40% masking 繼續預訓練,可提升高比例遮罩下的重建能力,同時保留 15% masked language modeling(MLM)訓練建立的 backbone 表示

研究者可從 Hugging Face 載入預訓練 RIBOSPAN checkpoint,再以 Python 整合序列表示、重建或其他 RNA 分析流程;checkpoint 會自動下載並快取,亦可改用本地路徑。模型規模和 dense attention 帶來較高的記憶體及運算成本,長度超過 10,240 nt 的轉錄本仍需另行切分或設計處理策略。

RiboSpan 適合研究 RNA 功能、長轉錄本表示和生物資訊模型的團隊,尤其方便先固定 backbone、再測試下游任務的人員。相較只處理約 1K 上下文的 dense RNA encoder,它保留完整轉錄本關係;代價是 1.61B 參數令本地推理和微調門檻更高,而模型權重亦採用非商業授權,商業項目需要先核對限制。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Python

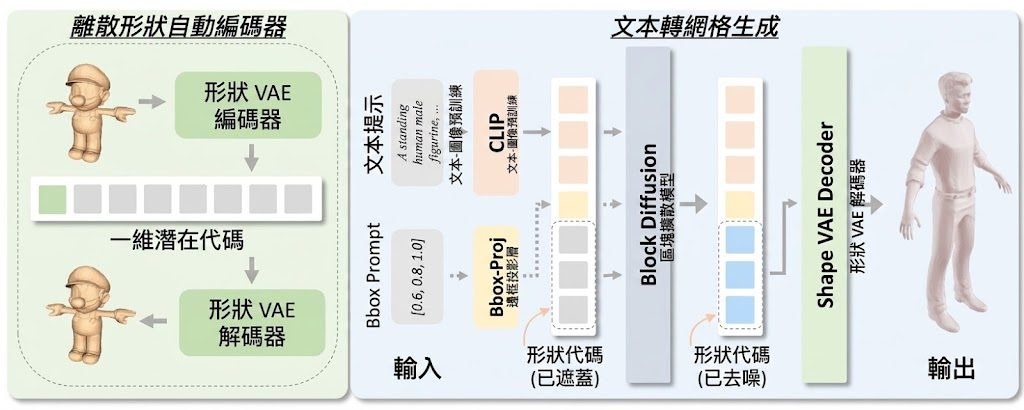
Block3D 把文字轉 3D 生成加速至 4.99 秒

Block3D 以區塊式擴散處理 3D shape tokens,在保留幾何質素及修正能力的同時,將生成時間大幅縮短。

Block3D conceptual comparison

由文字描述生成可用 3D 網格,往往要在幾何細節、生成速度和錯誤修正之間取捨。Block3D 是一個開源 text-to-3D 生成框架,針對離散 shape tokens 的逐個生成瓶頸,把固定長度的序列分成連續區塊,逐區塊生成並同時更新區內所有 token。

Block3D 延續自回歸模型由左至右的因果結構,但不再逐個 token 等待生成。每個 active block 會先進行 mask-to-token recovery,再以 token-to-token correction 修正低信心內容,確認後才提交並快取;凍結的 Cube shape encoder、text encoder 負責提供條件,Cube shape decoder 則把完整序列轉成輸出網格。這讓它比需要反覆處理整個 3D 表示的 diffusion 或 flow-matching 方法節省計算,也補上傳統 autoregressive decoding 難以回頭修正的限制。

在 TRELLIS-500K 留出測試集上,Block3D 的平均端到端生成時間為 4.99 秒,較微調後的 autoregressive baseline 25.71 秒快 5.15 倍,同時維持相近的幾何質素;報告指標包括 1% 閾值 F-score 0.309 和 normal consistency 0.668。結果適合需要批量產生概念模型、遊戲資產草稿或 3D 設計初稿的研究及開發團隊,但不能直接理解為所有提示詞和複雜網格都能維持同一水平。

測試需要 Linux、Python 3.10+、PyTorch 2.2+ 及 CUDA,訓練報告使用四張 NVIDIA A100 80GB GPU;TRELLIS-500K 數據不隨儲存庫提供。推理、訓練和評估程式已公開,pymeshlab 屬可選元件,Blender 只在 trimesh 無法直接讀取某些網格格式時需要,PyTorch3D 則用於 eight-view CLIPScore 評估。

  • 速度:平均 4.99 秒完成一次端到端生成。
  • 方法:區塊間保持因果生成,區塊內進行並行去噪及信心導向修正。
  • 質素:在 TRELLIS-500K 測試集維持 0.309 F-score@1% 及 0.668 normal consistency。
  • 門檻:需要 CUDA 環境;訓練成本以四張 A100 80GB GPU 為參考。

Block3D 的價值不只在於縮短等待時間,而是以區塊為單位保留部分修正空間,兼顧自回歸生成的結構控制和並行處理的效率。對需要自行研究 text-to-3D 推理流程、比較 Cube 與 TRELLIS 相關方法,或建立批量生成管線的團隊,它提供了可直接檢驗的開源基礎;對只有一般消費級 GPU 的個人使用者,則應先確認推理配置和模型資源是否足夠。

項目主頁 · GitHub

Categories: 開源, NVIDIA, 3D, Linux, Python

Page 43 of 183
1 … 41 42 43 44 45 … 183