OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

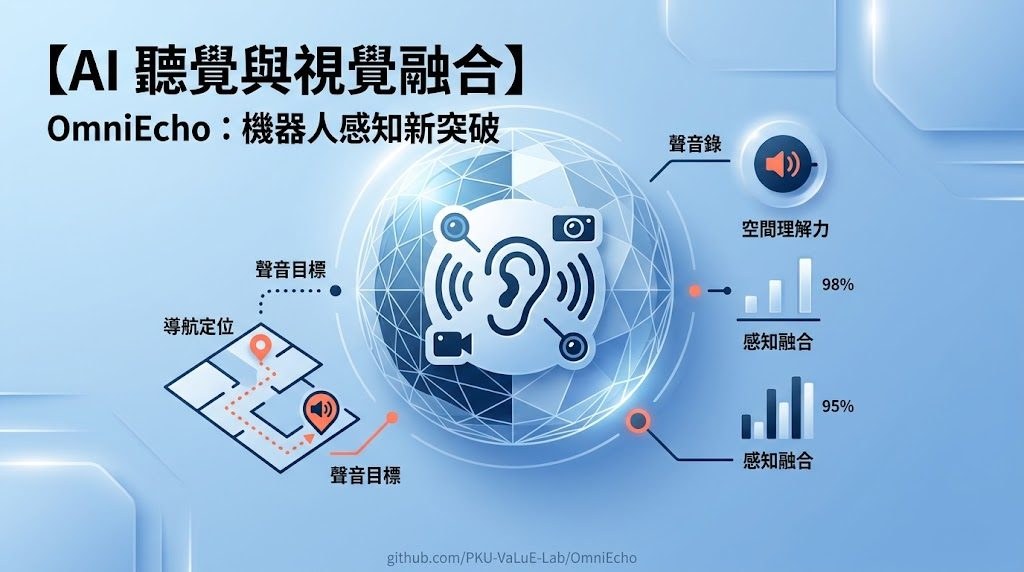
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。
GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

影像上載漏洞連上 SSO 缺陷,研究團隊取得 OpenAI 內部存取權

一張經論壇上載的圖片,可能令攻擊者由影像處理漏洞一路觸及員工帳戶及內部程式碼庫。Hacktron AI 的研究描述了兩個弱點如何串連成攻擊鏈。

Og image

Hacktron AI 的研究展示了一條由論壇圖片上載通往內部程式碼庫的攻擊鏈:影像處理元件的 heap buffer overflow,配合 OpenAI SSO 設定缺陷,令研究團隊聲稱曾接管多名員工的 ChatGPT 帳戶,並取得內部程式碼庫存取權。這類案例提醒管理者,單一漏洞的影響可能延伸至已連接的服務與帳戶。

攻擊鏈由 OpenAI 社群論壇 community.openai.com 開始。論壇處理圖片時會使用 ImageMagick,而它依賴的 libheif 存在堆積緩衝區溢位;研究亦指出,Debian 套件缺少相關安全修補。研究團隊再把這個漏洞與 SSO 身分驗證配置問題串連,進入 ChatGPT 及 Codex 帳戶。

取得帳戶後,連接到 ChatGPT 或 Codex 的服務亦可能擴大受影響範圍,包括 GitHub 及內部程式碼庫。團隊稱,他們透過員工的 Codex 在 OpenAI 內部 monorepo 開啟 PR,以證明存取能力,同時避免讀取敏感資料;這說明第三方連接器與帳戶權限會左右漏洞的實際影響。

對負責論壇、影像處理套件或企業登入整合的安全團隊,這宗披露可作為檢查線索:
– 確認 libheif 等相依套件已套用安全修補。
– 檢查 SSO 設定及帳戶接管防護。
– 盤點 ChatGPT、Codex 等服務連接的外部工具與權限。
– 測試由公開上載入口通往內部服務的完整攻擊路徑。

文章標示的披露日期為 2026 年 9 月 13 日,並列有受影響版本及修補資訊章節;但提供的內容未包含版本號、修補細節或獨立評估結果,因此不宜據此推斷所有部署均受影響。重點在於,影像解碼漏洞與身分驗證設定問題一旦串連,風險便可能超出原本的上載功能。

項目主頁

Categories: OpenAI, 新聞, 安全

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

LensVLM 用壓縮頁面減少長文閱讀成本

LensVLM先掃描低成本頁面圖,再只讀取與問題相關的完整頁面,將長文件問答的視覺輸入壓縮成按需取用。

Repository image for apple-aiml-research/ml-lensvlm

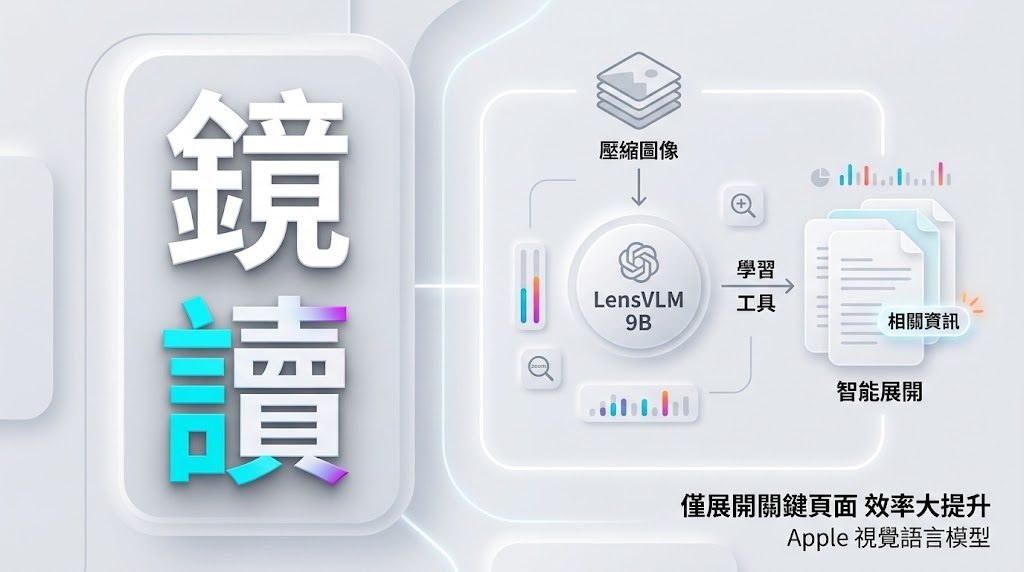
面對多頁文件問答,LensVLM不必一開始把每頁完整內容送入模型,而是先以壓縮頁面圖定位線索,再讀取相關頁面的全文。這個項目屬於多模態 Vision Language Model(VLM),實際處理的是長文件輸入過大、文字內容難以一次放入上下文的問題。

LensVLM是經微調的 Qwen3.5-9B,配合學習得到的 read_page 工具,讓模型在掃描頁面縮圖後按需擴展內容。示範包括模型檢查15頁文件,只讀取第10頁,經兩輪互動便由人物資料連結到答案;壓縮比例可選5x、10x或15x,取捨是壓縮越高,初步掃描成本較低,但頁面細節亦可能減少。

  • 先處理壓縮頁面圖,再按問題讀取完整頁面
  • 支援自訂文字文件及 HuggingFace 評估數據準備
  • 輸出頁面圖與結果檔案,方便檢查推理軌跡
  • 適合長報告、資料集問答及文件檢索測試

項目提供 requirements 安裝方式、示範流程及自訂文件參數,結果會寫入指定輸出目錄;原始資料沒有交代硬件要求、推理速度或記憶體消耗。提供的示例能說明工作流程,但未有完整準確率、延遲或與其他長文件 VLM 的量化比較,因此較適合作為研究原型和評估基礎,而非已證實在所有文件類型上都更快或更準的方案。

需要處理大量頁面、又希望控制視覺 token 成本的研究者和工程團隊,較容易從這種按需展開機制受益。文件版面複雜、關鍵答案分散,或問題需要跨頁整合時,仍要留意壓縮圖能否保留足夠線索,以及 read_page 讀取到的文字是否完整。

GitHub · 模型

Categories: 開源, 視覺模型, Qwen, 蘋果

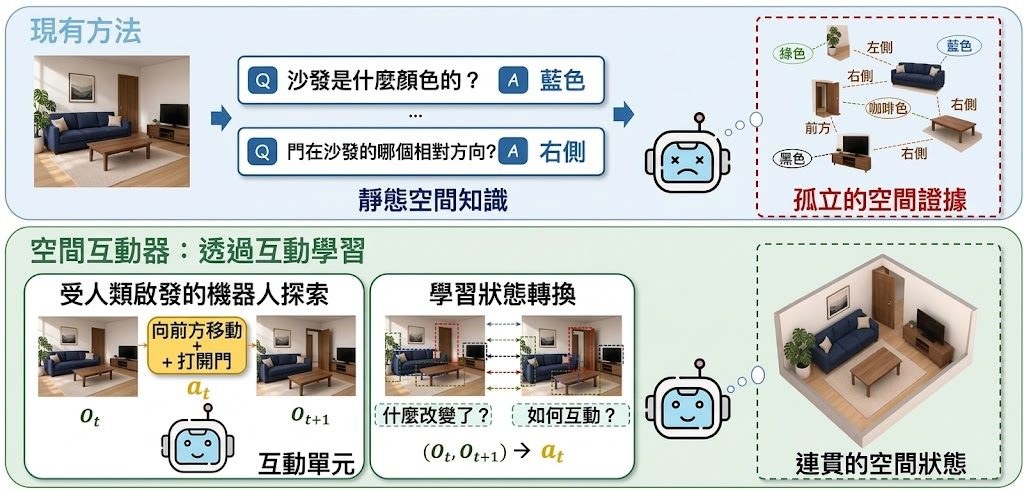
Spatial-Interactor 讓視覺模型學懂行動後的空間變化

Spatial-Interactor 把空間推理由靜態辨識推向連續互動,處理物件、視角與長距離軌跡的變化。

Spatial-Interactor icon

當畫面中的物件被打開、移動,或者代理人在場景中轉身前進,答案不再只是辨認位置,而是要推斷每一步行動帶來的改變。Spatial-Interactor 屬於視覺語言模型的訓練項目,針對模型難以理解狀態轉移及連續空間軌跡的問題,從可觀察的物理互動記錄建立訓練訊號。

項目把能力分成三層:L1 處理視點大致固定時的物件與世界狀態變化;L2 推理代理人移動造成的自身視角變化;L3 將連續的局部轉移整合成完整、長距離的互動軌跡。LSI-108K 以互動記錄、幾何軌跡、狀態及姿態資料產生可驗證的問答目標,令訓練內容不只停留在單張影像的空間關係。

訓練先以 supervised fine-tuning (SFT) 學習 L1 及 L2 的局部轉移,再利用 On-Policy Distillation (OPD) 整合長軌跡中的連續證據。推理時模型只接收原始視覺輸入與問題,毋須依賴額外提供的中間狀態;這有助於測試模型能否自行重建互動過程,但也代表長距離推理仍會受視覺理解及累積誤差影響。

項目涵蓋四個 vision-language models,並以狀態轉移診斷、打亂影格後的時間敏感度,以及局部與長軌跡推理結果作分析。較適合研究視覺代理人、機械人感知、具身 AI 及需要理解動作後果的場景;GitHub 資訊提供程式碼、模型與資料的連結,但未交代完整安裝及測試流程,不能單憑頁面內容判定下載後即可直接運行。

  • L1 分析外界物件及場景的狀態轉變
  • L2 把 ego-motion 對觀察結果的影響納入推理
  • L3 將多個局部轉移串連成完整軌跡
  • SFT 負責局部學習,OPD 負責長距離整合
  • 模型只需原始視覺輸入與問題作推理

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Image, Robotic

InternW0 讓機械人邊預測未來邊靈活操控

面對接觸、受力和環境變化,InternW0把未來視覺預測與連續動作控制結合,提升機械人完成操作任務的穩定性。

Shanghai Artificial Intelligence Laboratory

機械人處理實驗室器具、液體轉移或其他需要接觸感知的工作時,往往要同時理解下一刻會見到甚麼,以及當下應該施加甚麼動作。InternW0屬於 Physical World Model,透過非對稱 video–action 架構,把未來視覺預測與連續控制放進同一套流程。

它採用 mixture-of-transformers backbone,由高容量 video expert 預測較長時間範圍的視覺變化,再由較輕量的 action expert 根據最新觀察調整動作。Observation-conditioned context routing 會隨視覺和物理回饋更新上下文;force 與 tactile channels 則在 contact-aware post-training 中加入,協助處理接觸場景。

訓練部分以 joint video–action flow matching 學習未來動態與控制策略,Wan VAE 負責影片編碼,DINOv3 encoder 提供當前視覺觀察。七個數據集合共提供 7,233.5 小時資料,涵蓋真實機械人軌跡、模擬操作,以及 EgoLab 的實驗室第一身影片。

  • LIBERO 四個任務套件平均成功率達 98.6%
  • RoboTwin 2.0-Full 平均成功率為 93.12%
  • Clean2Random 平均成功率為 75.60%
  • RTX 5090D 上每次動作更新需時 60.73 毫秒,模型端策略更新率為 16.47 Hz

InternW0較適合需要長程預測、即時反應和接觸控制的機械人研究與實驗室工作流。資料未有提供完整安裝或下載使用流程,讀者應按官方提供的 Paper、GitHub、Hugging Face 或 ModelScope 資源確認可用版本與存取方式。

項目主頁

Categories: 開源, 上海人工智慧實驗室, 模型, 世界模型, 模型訓練, Video, Robotic, Dataset 數據集

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

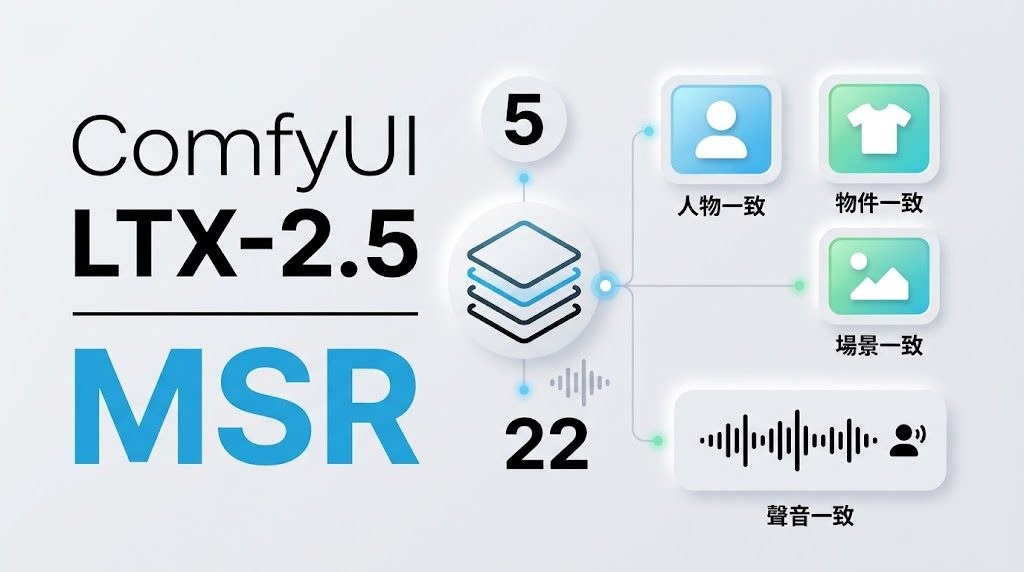
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。

GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

Page 25 of 183
1 … 23 24 25 26 27 … 183