Helios – 實時生成分鐘級長視頻

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。 在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。

在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

  • Helios‑Base(高質量)
  • Helios‑Mid(中間 checkpoint)
  • Helios‑Distilled(極端高效、對消費卡更友好),有 YouTuber 甚至在 RTX 4090 級別上跑 33 幀每段、分鐘級長視頻。
Helios - A 14B ByteDance Real-Time Long Video Generation Model Run Locally.

Categories: 開源, 字節跳動, 視頻模型

Utonia – Point Cloud 的單一編碼器

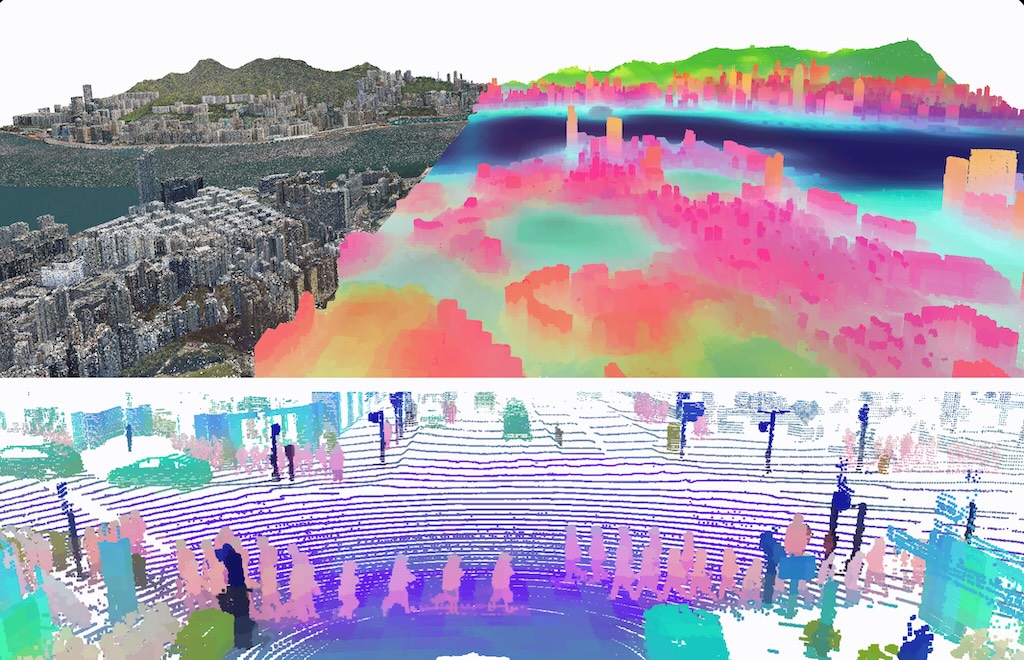
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。

Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。

跨域資料混合:
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Categories: 開源, 香港中文大學, 影像模型, 影像處理

shadcn-admin 把後台介面做成可重用基底

想快速砌出像樣的管理後台,shadcn-admin 提供的是一套可直接改造的 UI 基底。它重點唔係生成功能,而係先幫你處理版面、互動同可讀性。

alt text

做管理後台最花時間的,往往唔係業務邏輯,而係側邊欄、搜尋、深色模式同手機版排版呢類反覆出現的介面細節。shadcn-admin 屬於後台 UI 項目,用 ShadcnUI、Vite 同 TanStack Router 組成一套可重用的 dashboard 介面集合,目的係幫團隊快啲整理出一致、可維護的管理界面。

呢個項目最有價值的地方,在於它刻意唔包裝成 starter template。你拎到手的是一套已經鋪好結構的介面樣板與元件組合,包括 sidebar、global search command、10+ pages、light/dark mode、responsive 同 accessible 設計,適合拿來拆件、重組,再接上自己嘅資料流、權限同 API。

它同一般只展示幾個畫面嘅 UI showcase 有分別,因為 README 已經講清楚部分元件為咗 RTL support 做過修改,唔建議無腦用 Shadcn CLI 覆蓋更新。換句話說,呢個項目換來的是較完整的多語系版面照顧同現成後台骨架,但代價係後續升級某些元件時,要自己處理 merge,唔係純粹一路跟官方元件版本推進。

  • 建基於 ShadcnUI、TailwindCSS、RadixUI,同時配合 Vite 與 TypeScript
  • 內建 sidebar、全域搜尋指令、10+ 頁面,適合用作內部系統或 SaaS 後台雛形
  • 針對 RTL support 改過多個元件,對雙向語言介面更友善
  • Clerk 只屬 partial auth 整合,身份驗證仍需要按自己項目補完

部署同理解方式都算直接:安裝依賴後以 Vite 本地跑起介面,再按 src/components/ui/ 同路由頁面逐步替換成自己嘅資料與流程。它唔提供完整產品功能,也冇聲稱性能 benchmark;重點係把一個後台最難維持一致性的 UI 層先整理好,對經常做內部工具、SaaS 管理台、內容營運面板的前端團隊尤其實用。

GitHub

Categories: 開源, API, UI/UX


OpenClaw 翻車實錄 | 10 分鐘設定安全防護指南 | 防止 Indirect Prompt Injection !

減少 Compacted History 由 4 個方向落手。根據 OpenClaw 文件,COMPACTED HISTORY 係因為 session 接近 model context window,系統就會自動將舊對話摘要化,保留最近訊息繼續跑。 就好容易觸發 compaction。 最有效減少出現的方法: 1. 少啲喺同一個 session 累積太多嘢 最簡單直接。 做法: 適合你: 2. 減少大段工具輸出同長文灌入 context 文件講得好清楚,工具結果、讀檔內容、附件都會計入 context。 所以盡量: 即係: 3. 用 /compact 主動壓縮,而唔係等佢爆 文件建議可以手動做 compaction,而且可以加指示。 例如: 咁好處係: 如果你知自己開始傾長咗,主動 compact 其實幾好用。 4. 把重要規則移出對話,寫入持久檔 文件區分得好清: 即係話,重要但長期有效嘅嘢,唔好淨係留喺聊天紀錄。 你可以放去: 咁之後就算 compact 咗,我都仲可以由檔案重新抓返重點,而唔使靠長對話尾巴硬撐。 5. 如你成日用好多工具輸出,可以考慮 pruning OpenClaw 文件有提: 如果你個問題主要係工具輸出太大,pruning 會比單純 […]

OpenClaw 翻車實錄 | 10 分鐘設定安全防護指南 | 防止 Indirect Prompt Injection !

減少 Compacted History

由 4 個方向落手。根據 OpenClaw 文件,COMPACTED HISTORY 係因為 session 接近 model context window,系統就會自動將舊對話摘要化,保留最近訊息繼續跑。

  • 同一個 session 傾好耐
  • 經常 read 大檔案/貼長內容
  • 有好多工具輸出

就好容易觸發 compaction。

最有效減少出現的方法:

1. 少啲喺同一個 session 累積太多嘢

最簡單直接。

做法:

  • 一個大主題開一個新 session
  • 任務做完就 /new
  • 唔好乜都塞入同一條長命對話

適合你:

  • debug 一單野開一個 session
  • 寫文、做 config、查資料,各自分開

2. 減少大段工具輸出同長文灌入 context

文件講得好清楚,工具結果、讀檔內容、附件都會計入 context。

所以盡量:

  • 唔好一次 read 成個超大檔
  • 用較細 offset / limit 分段睇
  • command output 太長時,只攞重點
  • 唔好成段 log / transcript 原封不動貼入對話

即係:

  • 要睇 log:先 grep 關鍵字
  • 要睇 code:先讀 relevant block
  • 要分析文章:先摘要,再深挖局部

3. 用 /compact 主動壓縮,而唔係等佢爆

文件建議可以手動做 compaction,而且可以加指示。

例如:

  • /compact Focus on API design decisions
  • /compact 保留而家 debug 到嘅根因、已試過嘅方法同未解決問題

咁好處係:

  • 你控制摘要重點
  • 唔會等到 context 太滿先被動壓
  • 壓完之後 session 仲可以繼續,但重點較穩

如果你知自己開始傾長咗,主動 compact 其實幾好用。

4. 把重要規則移出對話,寫入持久檔

文件區分得好清:

  • context = 今次 run 送畀 model 睇嘅內容
  • memory / files = 可以落地保存,之後再載入

即係話,重要但長期有效嘅嘢,唔好淨係留喺聊天紀錄。

你可以放去:

  • MEMORY.md
  • 專案說明檔
  • 任務 notes
  • checklist / spec

咁之後就算 compact 咗,我都仲可以由檔案重新抓返重點,而唔使靠長對話尾巴硬撐。

5. 如你成日用好多工具輸出,可以考慮 pruning

OpenClaw 文件有提:

  • compaction = 摘要舊對話
  • pruning = 修剪舊 tool results

如果你個問題主要係工具輸出太大,pruning 會比單純 compaction 更對症。文件甚至直接講:如果 compact 得太頻密,試下開 session pruning。

6. 檢查 workspace 注入檔案有冇太大

文件講每次 run 都會注入:

  • AGENTS.md
  • SOUL.md
  • TOOLS.md
  • IDENTITY.md
  • USER.md
  • HEARTBEAT.md

如果其中某啲檔好大,會長期食 context。尤其 TOOLS.md、MEMORY.md 類型如果日積月累變肥,context 壓力會大。

你可以做:

  • 保持呢啲檔精簡
  • 長資料搬去專門 notes
  • 只保留真正會每次都用到嘅內容喺 injected files

7. 如果你想從根本改善,要改 config

文件提到 compaction 相關設定喺:
agents.defaults.compaction

而且如果 compaction 太頻繁,文件明講可能係:

  • model context window 細
  • tool output 太大
  • 應考慮 session pruning

如果你想,我可以幫你再查你本機 config,睇下有冇:

  • pruning 可開
  • compaction keepRecentTokens 可調
  • notifyUser 可開
  • 甚至有冇其他 session/context 設定可以優化

我嘅實際建議排序係:

  1. 分 session
  2. 減少長輸出進 context
  3. 主動 /compact,加明確 focus
  4. 重要資訊寫入檔案
  5. 再研究 pruning / config

Categories: Agentic, 教學

Code2World 基於動作預測的 GUI 代理

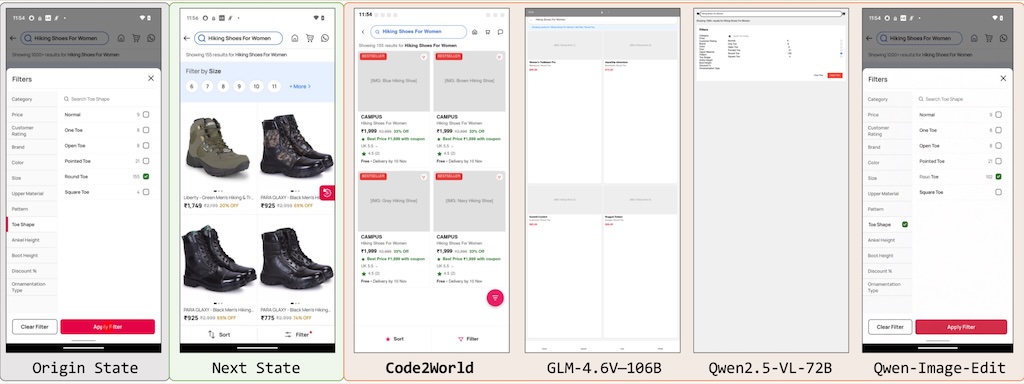
Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。 它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。

它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Categories: 開源, 阿里巴巴, Agentic, 模型, 編程

PaperBanana 賦每個創意工作流程

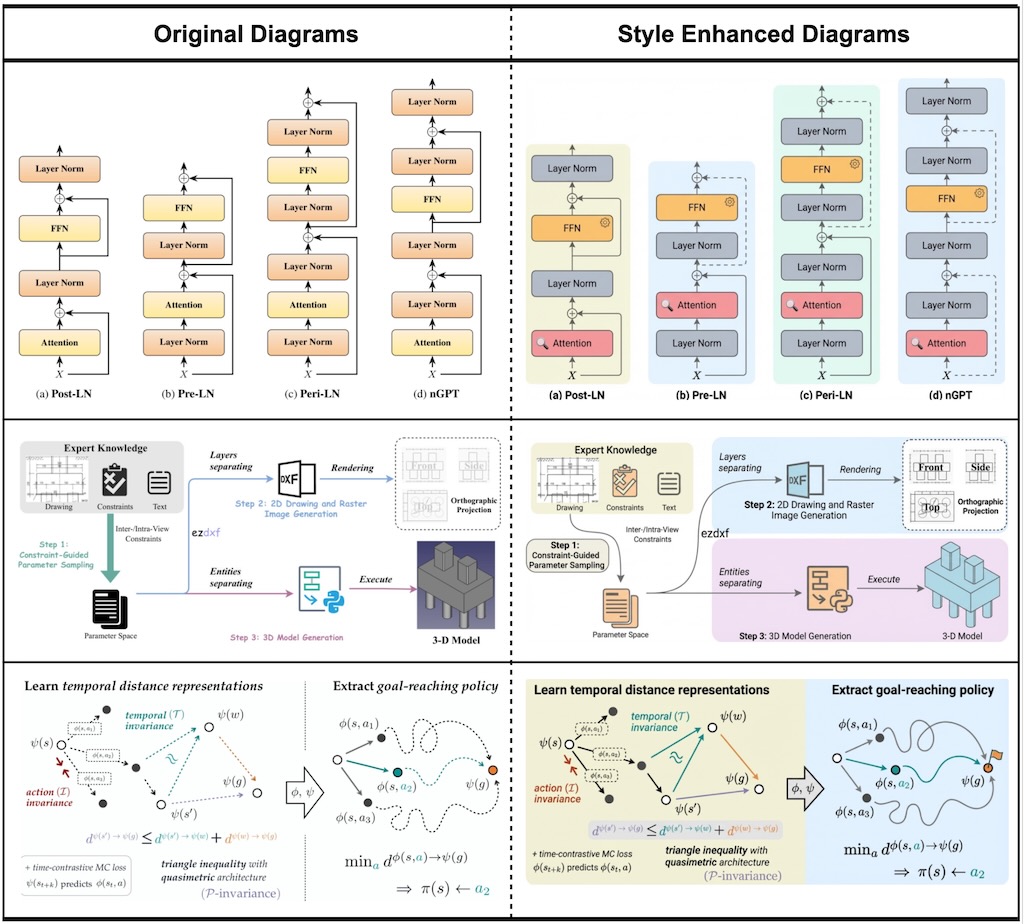
PaperBanana 是一個開源的自動化學術圖表生成框架,由 Google Research 開發。這個工具專為 AI 研究人員設計,能夠自動生成符合出版標準的方法論圖表、代理架構和統計圖 。 PaperBanana 還擁有強大的潤色功能。您可以輸入手繪草圖或示意圖,系統會將它們精修成專業的向量圖。Google 聲稱兩星期後會提供開源實作版本,亦有第三方的版本可在 GitHub 下載使用。

PaperBanana 是一個開源的自動化學術圖表生成框架,由 Google Research 開發。這個工具專為 AI 研究人員設計,能夠自動生成符合出版標準的方法論圖表、代理架構和統計圖 。

PaperBanana 還擁有強大的潤色功能。您可以輸入手繪草圖或示意圖,系統會將它們精修成專業的向量圖。Google 聲稱兩星期後會提供開源實作版本,亦有第三方的版本可在 GitHub 下載使用。

Categories: 開源, Agentic, Google, Gemini

InteractAvatar 互動數字人

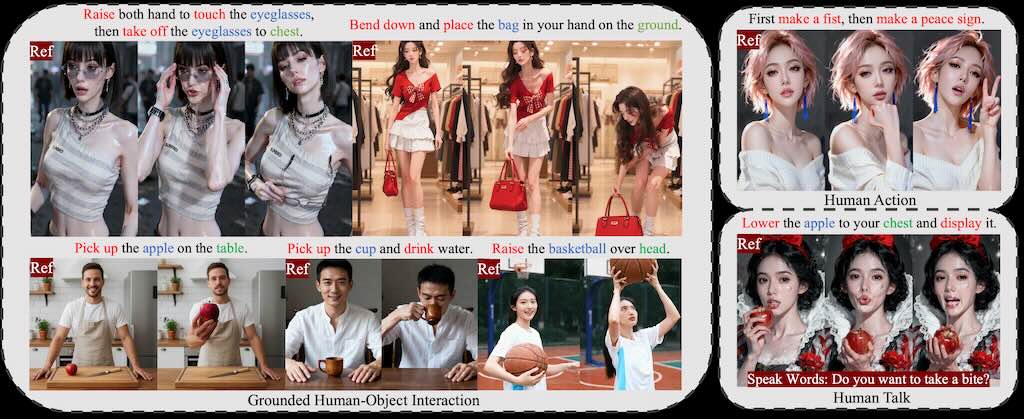
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。 雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。

雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

Categories: 開源, 騰訊, 數字人, 視頻模型, 影像模型, 影像處理

Page 119 of 185
1 … 117 118 119 120 121 … 185