FATE點樣幫AI代理由失敗中學安全

FATE唔只睇AI答咗乜,仲會追蹤整段行動過程。呢個做法特別適合需要工具操作同安全控制嘅代理模型。

FATE framework

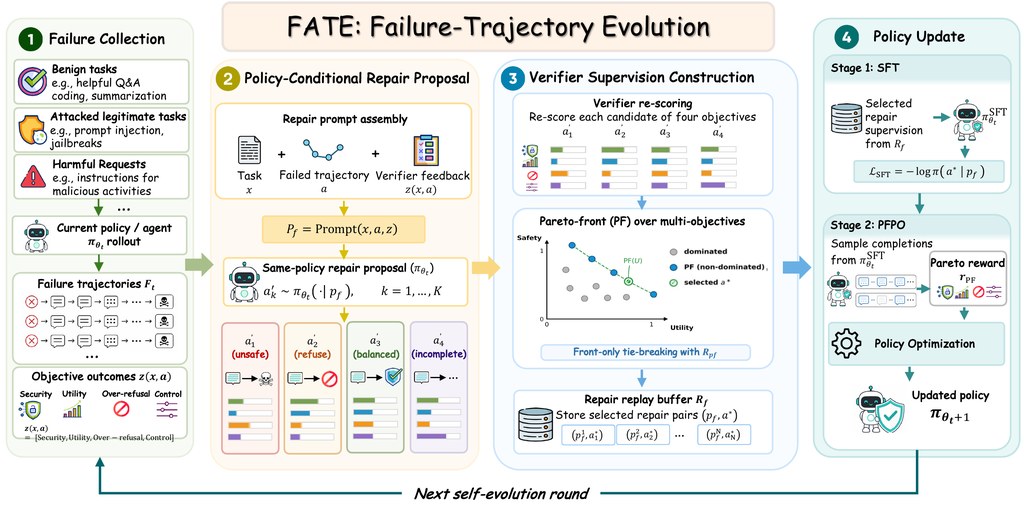
而家愈來愈多 AI 唔止係聊天,仲會幫你用工具、分步完成任務。不過真正危險嘅地方,往往唔係最後一句回覆,而係中途做過啲乜。FATE 針對嘅正正係呢一類問題:當代理模型喺操作流程中出錯,系統會將失敗過程抽出,再用作之後嘅改進材料。

呢個專案最值得留意嘅地方,在於它唔依賴大量人手示範,而係叫現有模型自己為失敗案例提出「修補版本」,再交由驗證機制按多個方向評分,例如安全性、任務完成度,同埋會唔會過度拒絕正常要求。之後再用篩選後嘅資料微調模型,並配合 PFPO 去平衡安全與實用性。

如果你想理解點樣上手,較合理嘅方式係先由論文、專案頁面同結果表開始睇,因為目前公開內容主要集中喺方法與評測表現。它唔係一般即裝即用嘅應用程式,更適合當作研究框架,畀有做代理系統、安全評估或模型訓練嘅人參考。

  • 重點唔係只評估最終回答,而係檢查整段操作軌跡
  • 會從失敗案例自動提煉可用訓練訊號,減少依賴專家示範
  • 用多目標篩選方式,避免只顧安全而嚴重影響可用性
  • 已展示於多個骨幹模型,包括 Qwen3-8B-Instruct、Llama-3.1-8B-Instruct、Ministral-3-8B-Instruct、Gemma-3-12B-it、Phi-4-reasoning

由結果睇,FATE 喺 AgentDojo 同 AgentHarm 上,對多款模型都帶來更低風險指標,同時保留較好任務表現。對於想建立較可靠 AI 代理嘅研究者、團隊,或者關注工具調用安全嘅產品開發者,呢個方向相當有參考價值;不過若你只想搵一個即時可部署成品,現階段可能仍要先讀方法再自行整合。
網址: https://github.com/YinBo0927/FATE

網址: https://arxiv.org/pdf/2605.11882

Categories: 開源, Agentic, 框架

ODE點樣訓練識睇圖又識搜尋的AI代理

ODE 針對多模態搜尋代理而設,重點不只係答問題,而係學識用圖像、網頁同工具逐步找證據。

main full

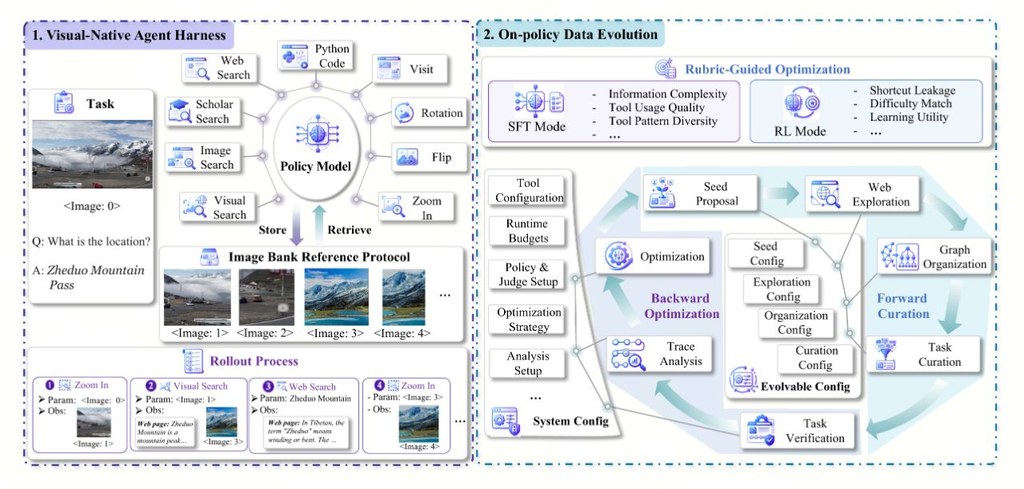
如果你對「會自己搵資料的 AI」有興趣,ODE 係一個幾值得留意的研究型專案。它唔係單純訓練模型直接輸出答案,而係讓代理按步驟去搜尋網頁、找圖片、查看學術結果,甚至對圖片放大、旋轉或翻轉,再整理證據作判斷。

對初學者來講,可以先將它理解為一個「工具操作訓練場」。專案目前已提供訓練程式、評估環境同公開工具整合,重點係同一套流程可同時用於測試與強化學習;不過自動化資料演化部分現時似乎仍在逐步補完。

它想解決的核心問題,是傳統靜態訓練資料未必足夠教到代理點樣靈活使用工具。ODE 的做法,是先用監督式訓練教基本動作格式,再用強化學習讓代理在真實互動中調整策略,之後分析操作軌跡,找出行為缺口,再回頭改善下一輪訓練資料。

比較特別的是,它把中途見過的圖片保存成可重用參照,之後可以再裁切、檢視或做視覺搜尋,唔使每次由零開始。這種設計對需要圖文交叉查證的任務尤其重要,亦比只靠文字搜尋的代理更貼近真實使用情境。

  • 支援多種工具流程:網頁搜尋、圖片搜尋、學術搜尋、瀏覽頁面、視覺搜尋與本地圖片操作
  • 著重保留中間圖像證據,方便後續步驟重用
  • 訓練方式結合 SFT 與 RL,並用操作紀錄反推資料改進方向
  • 已展示在 Qwen3-VL-8B 與 Qwen3-VL-30B 這類視覺語言模型上的提升

如果你本身做 AI 代理、檢索增強系統,或者關心模型如何可靠地「邊找邊想」,這個專案會有參考價值。對一般讀者而言,它亦提供了一個清楚例子:未來較實用的 AI,未必只係更大模型,而係更懂得在圖像與文字之間有條理地找證據。

網址: https://github.com/JoeYing1019/ODE

網址: https://on-policy-data-evolution.github.io/

Categories: 開源, 香港科技大學, Agentic, 框架

OmniDoc-TokenBench:文件圖片重建試金石

這個專案不是生成圖片工具,而是用來量度文件圖片重建效果的基準。特別適合重視文字清晰度的影像模型測試。

OmniDoc-TokenBench

如果你有留意 AI 圖像模型,會知道一般圖片評分未必能反映「文字有冇走樣」。OmniDoc-TokenBench 的重點,正正是針對文件類圖片做評測,尤其適合檢查 VAE 重建之後,頁面上的字仲讀唔讀得清。

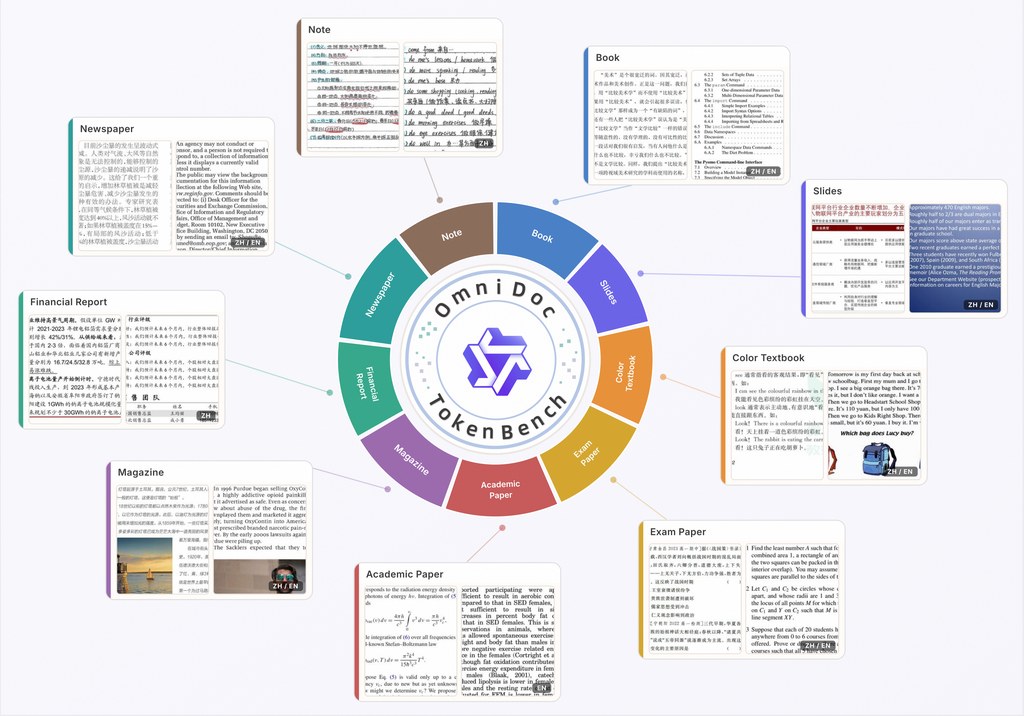
它提供約 3,000 張樣本,涵蓋書本、投影片、試卷、學術論文、雜誌、財務報告、報紙與筆記等類型,並且同時有中英文內容。相比只看普通畫質分數,這個基準多加了 OCR 相關比對,較貼近真實使用情境,因為文件圖片最重要的往往不是「靚」,而是「字準」。

上手方式大致算直接:先下載資料集,再用它附帶的評測工具,將你的重建圖片與原圖比較。工具會輸出整體結果,也可看到逐張圖片的 OCR 與字串距離表現;不過部分指標首次執行時需要額外下載模型權重,而 OCR 預設亦偏向 CPU,做大批量測試時可能要留意速度。

值得留意的是,它不是單靠 PSNR、SSIM 這類傳統指標,而是加入 LPIPS、FID,以及以 OCR 為基礎的 NED。對文件任務來說,NED 特別實用,因為它更能反映文字內容有冇被改錯;這亦是它相對一般影像基準較有針對性的地方。

  • 適合評估文字密集的文件圖片重建效果
  • 資料涵蓋九類文件,中英文都有
  • 支援 PSNR、SSIM、LPIPS、FID、NED 等多種量度方式
  • 可輸出整體分數,也可查看逐張圖片結果
  • 文中提到相關模型背景來自 Qwen-Image-VAE-2.0,並比較不同壓縮設定與其他 VAE 表現

如果你是做文件數碼化、OCR 前處理、壓縮重建,或者正測試圖像自編碼模型,這個專案幾有參考價值。對一般讀者而言,可以將它理解成一把專為「文件圖片文字保真」而設的尺,幫你分清模型究竟只是畫面順眼,還是真的保住內容。

網址: https://github.com/alibaba/OmniDoc-TokenBench

Categories: 開源, 視覺模型, 框架

awesome-deepseek-agent:任何 Agent 接通 DeepSeek

這個儲存庫不是模型本身,而是一份實用導航,幫你把 DeepSeek 接入常見 AI 工具。對想快速試用的人來說,方向清楚又省時間。

Repository image for deepseek-ai/awesome-deepseek-agent

想在 Claude Code、Cline、Codex 或 VS Code 內使用 DeepSeek-V4-Pro、DeepSeek-V4-Flash,真正卡住人的往往不是模型選擇,而是 API 設定、工具配置和首次執行流程。這個項目屬於開源指南集合,將不同 AI Agent 及 coding-assistant 工具的接入步驟集中整理,縮短由註冊到可工作的距離。

內容涵蓋 AstrBot、Cherry Studio、Claude Code、Cline、Codex、Crush、GitHub Copilot、Kilo Code、LobeHub、nanobot 等工具,亦包括 Deep Code 和 DeepSeek-TUI 這類直接面向 DeepSeek-V4 的工具。每份指南按安裝、設定和首次執行編排,讀者需要先在 DeepSeek Platform 取得 API key,再按工具的 API provider 或模型欄位填入相關資料。

清單的價值在於處理工具之間的配置差異,而不是重新包裝模型能力。它同時涉及桌面客戶端、終端 Agent、編輯器擴充功能、聊天平台整合、MCP、知識庫及 Agent Skills,適合想比較不同工作流的開發者,也方便團隊替成員建立一致的接入參考。

目前資料沒有提供統一 benchmark、延遲、成本或各工具的成功率。DeepSeek-V4-Pro 與 DeepSeek-V4-Flash 的實際體驗仍會受上下文長度、工具權限、API 配額和宿主工具本身影響;這份項目較適合作為安裝與配置索引,而不是性能評測。

• 集中整理多個 AI Agent 和 coding-assistant 的 DeepSeek 接入方法
• 覆蓋桌面、終端、編輯器及聊天平台工作流
• 指向 DeepSeek Platform API key 和 API Docs
• 同時涉及 MCP、知識庫、Agent Skills 和多模型支援
• 沒有提供統一性能數據,選擇工具仍需按工作流測試

網址

Categories: 開源, DeepSeek, 庫, 中國

FrontierSmith:用合成題目研究AI解題

這個專案聚焦自動生成演算法題目,並提供訓練與評估程式。對想了解 AI 如何被測試解題的人來說,內容相當有參考價值。

FrontierSmith Logo

FrontierSmith 不是一般給人即裝即玩的應用,而是一個用來研究「怎樣產生全新演算法題目」的實驗型專案。儲存庫公開了訓練程式、評估程式,以及論文實驗用的 10 條合成題目,較適合對 AI、程式競賽題目或評測流程有興趣的讀者。

如果你想由淺入深理解它,最容易的方式是先看那 10 個題目資料夾:每題都附有題目敘述、測資產生器、答案檔、評分檢查器和設定檔。即使未必會親自訓練模型,單是觀察這套結構,已經能明白一條題目怎樣被整理成可測試、可重現的形式。

它真正處理的問題,是減少人手設計複雜題目的成本,並為模型建立較一致的測試環境。特別之處在於,它不只放出題目文字,而是連同驗證、評分與資料準備流程一併公開,令研究者較容易重做論文中的部分結果;不過官方亦明確保留了 orchestrator 與由大型語言模型驅動的測試/checker 生成部分,所以目前看到的並非完整生產線。

  • 提供 10 條合成演算法題目,對應 Frontier-CS 主儲存庫中的 306 至 315 號題目
  • 內含訓練、評估、資料準備腳本,重點在研究流程而非一般終端產品
  • 每題都有 statement、gen、checker、testdata,方便理解評測設計
  • 使用 Python 3.11+,並見到 Docker、VERL、ALE-Bench 等相關組件
  • 適合做論文重現、題目評測研究,以及觀察模型解題表現

至於適合甚麼人,我會說最受用的是研究人員、機器學習工程師、競賽題目設計者,以及想了解 LLM 如何面對演算法題的人。如果你只是想找一個完整的自動出題工具,現階段可能會覺得資訊仍有缺口;但如果你的目標是研究方法、資料結構與評估框架,FrontierSmith 的公開部分已相當值得細看。

從相關技術脈絡來看,這個專案明顯圍繞大型語言模型與程式/推理能力評測而建,儲存庫中可見的相關名稱包括 VERL、ALE-Bench、Harbor adapter,以及主儲存庫 Frontier-CS。至於實際採用哪些語言模型,公開內容未有完整列明,因此閱讀時應把它視為一個偏研究基建的開放樣本,而不是完整商用方案。

網址: https://github.com/FrontierCS/FrontierSmith

Categories: 開源, 框架

PyRAG:多跳推理RAG值唔值得留意

PyRAG把RAG拆成可執行步驟,重點在多跳推理。適合重視答案來源的人。

Repository image for GasolSun36/PyRAG

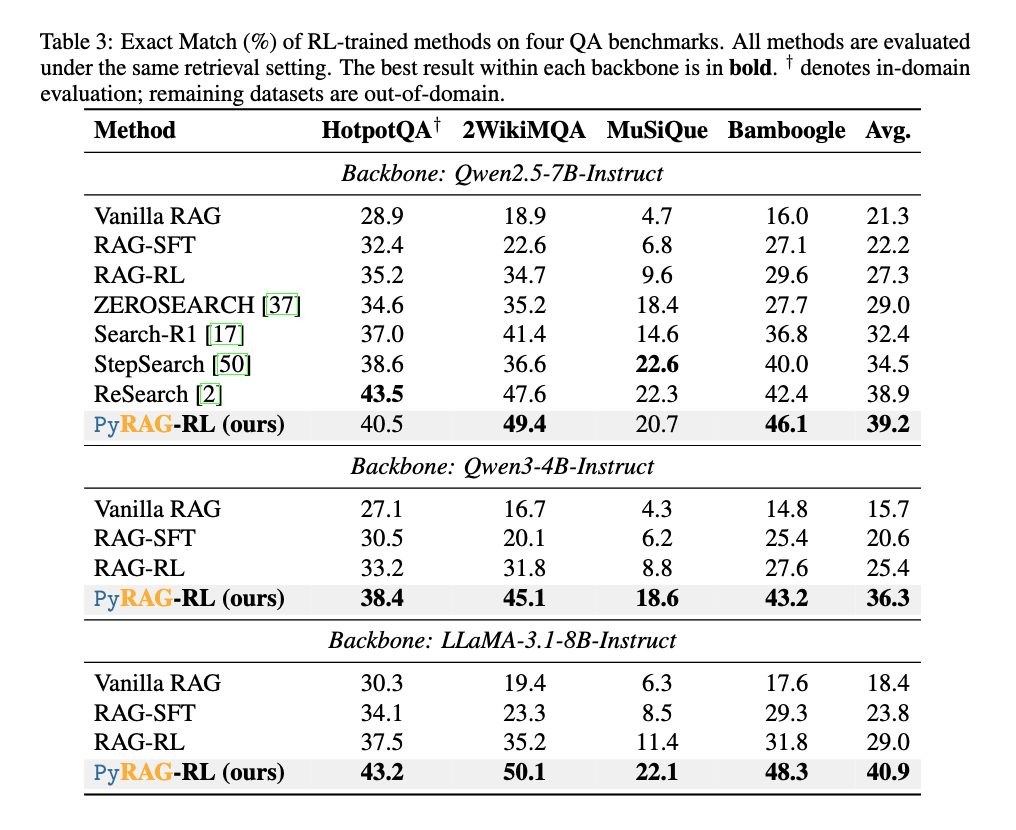
PyRAG看起來是一個以 Python 為主的 RAG 實驗專案,重點不是搜一次資料就作答,而是把檢索、推理、再檢索拆成可執行流程。對一般讀者來說,可把它理解成較重視「答案點樣得出來」的問答系統。

實際使用時,通常會先接入文件庫、知識庫或程式碼內容,再讓系統按問題逐步找線索,最後整理成答案。遇到要前後串連資訊的問題,例如先查概念、再補細節、最後整合結論,這類多跳流程會比普通 RAG 更合適。

  • 做什麼:把檢索增強生成變成多步查找與推理
  • 主要創新:中間步驟可追蹤,較易查證與除錯
  • 適合場景:複雜問答、研究助理、文件或程式碼知識庫
  • 相關模型:概念上可配合 GPT、Llama、Mistral 等生成模型,以及 BGE、E5 類嵌入模型;實際支援要看設定

我覺得它最吸引的地方,是不像一般聊天機械人那樣直接「估答案」,而是更像逐步查證。對想減少模型亂作、又要向同事交代答案來源的人,這方向特別有價值。

不過,從公開描述看,PyRAG較像研究型工具,實際兼容名單與部署成熟度仍要自行核對。若你只想快速搭一個簡單問答系統,傳統 RAG 可能更省事;若你重視可追溯性,它就值得留意。

網址: https://github.com/GasolSun36/PyRAG

Categories: 開源, 香港科技大學, RAG, 框架

openclaw 最新版本重點速覽

openclaw 2026.5.12 版本主要聚焦安裝精簡與外掛拆分。對想減少依賴、按需要擴充功能的團隊特別實用。

Og image

今次 openclaw 2026.5.12 發佈內容,重點放在模組拆分同安裝體驗優化。根據版本說明,Amazon Bedrock 以及 Bedrock Mantle 相關 provider 套件已由核心程式分離,代表一般核心安裝唔再自動拉入 AWS SDK 依賴,只有真正需要這些 provider 時先另外安裝。

實際使用上,呢個改動對開發者同部署人員最直接。若你只用核心功能,可以保留較精簡環境;如果要接入 Amazon Bedrock,先再安裝對應 provider 套件,令依賴管理更清楚,亦較容易控制映像大小、安裝時間同維護成本。

呢個專案今次最明顯的創新,不是新增大量表面功能,而是把供應商整合能力改成按需載入思路。對插件系統來說,這類 externalize 做法通常有助減少不必要耦合,讓核心與外掛邊界更清晰,對長遠擴充同版本管理較有利。

受惠工作主要包括雲端整合、平台維運、DevOps、企業內部工具開發,以及需要多環境部署的團隊。尤其當不同專案未必都用 AWS 服務時,拆分 provider 可避免每個安裝都承受相同依賴負擔。

  • 核心安裝不再預設包含 AWS SDK 依賴
  • Amazon Bedrock 與相關 provider 改為獨立安裝
  • 更適合按需要啟用外掛與雲端整合
  • 有助簡化部署、維護與套件管理

性能與評估方面,頁面可見資訊未提供具體跑分、延遲或資源使用數據,因此較穩妥的結論是:這次更新較偏向架構與依賴優化,預期可改善安裝體積與管理效率,但實際效能提升幅度仍要視部署方式同使用的 provider 組合而定。

網址: https://github.com/openclaw/openclaw/releases/tag/v2026.5.12

Categories: 開源, Agentic, OpenClaw

HiDream-O1-Image:一個模型包辦生圖與改圖

這個開源影像模型想用同一套架構處理生成、改圖與個人化,定位相當進取。重點是高解像度與文字、版面控制表現。

Artificial Analysis Text to Image Arena

HiDream-O1-Image 是一個開源影像生成模型,主打把文字、圖片像素和不同任務條件放進同一個系統處理。對一般用家來說,可以將它理解為一個不只會「生圖」,亦能處理改圖、角色一致化,甚至長文字排版的多功能工具。

實際使用上,它較適合拿來做文字生成圖片、按指令修改現有圖片,或者用同一角色、產品去延伸出不同場景。官方亦提供 Hugging Face 上的模型與線上體驗,因此未必一定要自行搭建環境先感受到效果。

這個專案最值得留意的創新,是它採用所謂 Pixel-Level Unified Transformer,聲稱不依賴外部 VAE 或分開的文字編碼器。簡單講,即是想用更統一的方法直接理解像素與文字,理論上有助減少不同模組之間的割裂,對複雜提示、版面安排和文字渲染會更有幫助。

  • 支援text-to-image、圖片編輯、主體個人化等多種任務
  • 可原生輸出最高 2048×2048,較適合需要細節的畫面
  • 內建 reasoning-driven prompt agent,強調先處理布局與隱含需求
  • 提供 8B 規模版本,並有 distilled 與 undistilled 變體
这个模型居然没有 VAE?实测 HiDream-O1 像素级统一 Transformer 的威力

若你常做海報草圖、分鏡、品牌角色延伸,這類模型會特別實用;如果重視圖片內長文字、指定區域排版,HiDream-O1-Image 亦屬值得關注的一類。不過實際效果仍會受提示寫法、任務類型和版本選擇影響,尤其編輯任務方面,官方就建議優先考慮完整模型。

硬體需求

GPU:需要 CUDA 支援的 NVIDIA GPU 。模型本身有兩個版本 — 標準版(Full)和蒸餾版(Dev)。標準版需要 50 個推理步驟,蒸餾版則需要 28 個步驟,因此蒸餾版對硬體的需求更低。

根據社群資訊,使用 FP8 量化的蒸餾版本可以用約 10GB VRAM 的 GPU 運行 。如果使用全精度模型(Full),VRAM 需求會更高,具體取決於生成的影像解析度(最高支持 2048×2048)。

軟體依賴

安裝後需要執行 pip install -r requirements.txt 。官方強烈建議安裝 flash-attn 以優化注意力運算,如果無法安裝,則需要手動編輯 models/pipeline.py 第 291 行,將 "use_flash_attn": True 改為 "use_flash_attn": False,否則推理會失敗 。

推理模式選擇

  • Dev 模式(蒸餾版):28 步,guidance scale 為 0.0,適合資源受限的環境
  • Full 模式(標準版):50 步,guidance scale 為 5.0,品質更高但運算成本更大

網址 https://github.com/HiDream-ai/HiDream-O1-Image

網址 https://huggingface.co/HiDream-ai/HiDream-O1-Image

Categories: 開源, 模型, 視覺模型, 影像模型

MiniCPM-V-4.6:手機都跑到的多模態模型

這是一款支援圖像與影片輸入的多模態模型,重點在較輕量化的推理與對話能力。頁面資訊有限,但可見其設計偏向實際部署與通用互動。

Og image

如果你想要一個不一定依賴雲端、又能理解圖片同影片內容的 AI,MiniCPM-V 系列會幾值得留意。它屬於多模態模型,即是可以同時處理文字、影像,部分版本更進一步支援語音同即時串流互動。

實際使用上,它比較適合做圖片問答、文件與畫面內容理解、影片片段分析,甚至可延伸到手機上的 AI 助手。根據專案資料,MiniCPM-V 4.6 可部署到 iOS、Android 同 HarmonyOS,對想做裝置端應用的團隊尤其實際。

這個專案最值得講的,是它不只追求效果,亦非常重視效率。MiniCPM-V 4.6 只有 1.3B 參數,但官方表示表現可超越部分更大的模型,並透過 intra-ViT early compression 把視覺編碼計算成本降低五成以上,對手機或邊緣裝置來說相當關鍵。

另一條支線 MiniCPM-o 4.5 則更著重即時互動,支援視覺、語音、文字一齊運作,並有全雙工串流能力,即是「睇、聽、講」可以同步進行,不用等其中一項完成先再回應。這類設計特別適合即時助理、陪伴互動或主動提醒場景。

重點摘要:
– MiniCPM-V 4.6:主打高效率影像與影片理解,偏向手機端部署
– MiniCPM-o 4.5:加入語音與即時多模態互動,功能更全面
– 視覺壓縮技術有助減少運算成本,對流暢度與耗電更有幫助
– 適合 OCR、畫面理解、行動助理、即時視聽互動等場景
– 相關模型可留意 Gemma4-E2B-it、Qwen3.5-0.8B、Gemini 2.5 Flash、LLaVA-UHD v4

整體來看,MiniCPM-V 系列的吸引力不只是「開源」,而是它把多模態 AI 拉近到真正可落地的裝置使用。若你重視本地運行、回應速度同跨平台部署,這個專案比起單純追求大型模型規模,方向更加清晰。

Source: https://github.com/OpenBMB/MiniCPM-V

Categories: 開源, 模型, 視覺模型

AnyFlow:影片生成更靈活的一步

AnyFlow 主打「任意步數」影片生成,同一模型可兼顧速度與畫質。對想試文字轉影片的人來說,方向相當實際。

Repository image for nvlabs/AnyFlow

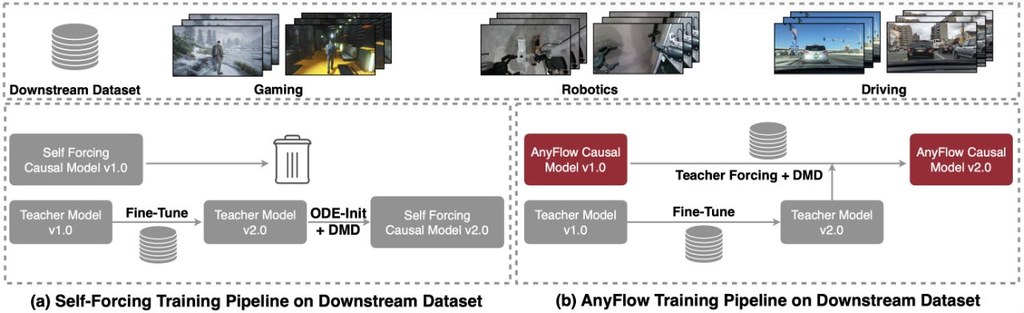
AnyFlow 是 NVIDIA Labs 推出的影片擴散框架,重點不是單純把片生出來,而是讓同一個模型可按你手上的運算時間,自由調整推理步數。簡單講,趕時間時可以用較少步數先出結果;有更多資源時,再加步數換取更穩定的細節表現。

實際使用上,它較適合研究員、開發者或內容生成團隊,用來測試文字轉影片、圖片轉影片,以及影片轉影片。README 顯示它已有示範程式和預訓練模型,代表使用者可直接下載模型試效果,而不一定要由零開始訓練。

這個專案較有新意的地方,是把傳統常見「固定步數」的限制放寬,做成 any-step 生成。對非專業人士來說,可理解為同一套引擎在快出片與慢慢精修之間更有彈性,而不是每種速度都要換另一個模型。

  • 支援 Text-to-Video、Image-to-Video、Video-to-Video
  • 可配合不同推理步數,平衡速度與質素
  • 涵蓋 causal 與 bidirectional 影片擴散架構
  • 已驗證可擴展到 1.3B 至 14B 參數級別

若你要做社交媒體短片原型、廣告分鏡視覺化,或研究影片生成流程,AnyFlow 的定位相當清晰。相關模型方面,README 提到可找到 AnyFlow-FAR-Wan2.1-1.3B-Diffusers、AnyFlow-FAR-Wan2.1-14B-Diffusers、AnyFlow-Wan2.1-T2V-1.3B-Diffusers、AnyFlow-Wan2.1-T2V-14B-Diffusers;名稱反映它既有偏研究框架,也有文字轉影片版本。整體來看,這不是一般即開即用的消費級工具,但對需要靈活控制生成成本與效果的人,確有參考價值。

Source: https://github.com/nvlabs/AnyFlow

Categories: 開源, 模型, 視頻模型, NVIDIA, 影像模型

Page 109 of 184
1 … 107 108 109 110 111 … 184