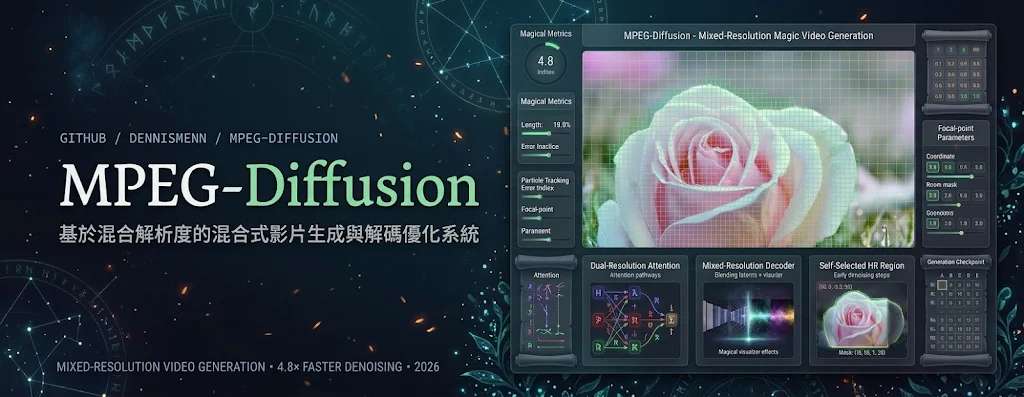
主體要清晰,背景卻未必需要同樣精細。影片生成研究項目 MPEG-Diffusion 把重要區域以高解像度生成,其餘區域則用低解像度處理。在 Wan2.1 14B、720p、81 frames,採用 MovieGen 與 VBench prompts 的測試中,它使用 30% Tokens,相對全解像度基準加速 4.8×。同表最快的兩種方法達 5.2×,但需要預先指定高清區域;它則在生成期間自行選取。
這個差異直接影響生成前的準備工作:使用者毋須先圈出哪裏要保留細節。生成初期的 denoising,即逐步移除雜訊的過程,畫面仍太模糊,難以從外部偵測重要區域。研究人員因此讀取 DiT 生成模型的 intermediate features,也就是模型處理中的內部資訊,再以單一 linear layer 選區。模型內部已掌握重要主體的位置,這層簡單的選取機制便可在畫面尚未清晰時決定資源分配。
混合解像度的難題不止於選區,還包括不同區域怎樣互相參照。文件指出,當高、低解像度 tokens 共用 K/V cache,即 attention 查閱的資訊暫存區,單一低解像度 token 無法重現它所取代的四個高解像度 tokens 的 attention,fine-tuning 也無法解決。Dual-resolution attention 因此分開保存兩種解像度的 K/V caches,讓每次查詢讀取自身解像度的資訊,再用 linear map 補齊另一解像度缺少的內容。
輸出影片時,直接把兩種解像度各自解碼再拼接,也會留下可見失真與邊界接縫。研究人員發現,即使採用真實影片編碼所得的 latents,這個問題仍然存在;latents 是尚未還原成畫面的壓縮表示。Mixed-resolution decoder 改為先把兩者合併成 unified latent,再交給 VAE 一次解碼成畫面,避免在完成解碼後才硬接不同區域。
要判斷加速的代價,須把質素分數與全解像度結果一起看。上述測試的 Full resolution 使用 100% Tokens,速度定為 1.0×,四項質素指標均為同表最高。MANIQA 為 0.445,Imaging 為 0.671;DOVER 為 0.819,VBench Q. 為 85.3。表內四項指標均以較高為佳,所以「接近全解像度」不能理解為完全沒有質素損失。
同樣使用 30% Tokens 的 Phase-Aligned RoPE 與 Foveated Diffusion,均相對基準加速 5.2×,並要求額外的 region 輸入。Phase-Aligned RoPE 的 MANIQA 為 0.293,Imaging 為 0.622;DOVER 為 0.757,VBench Q. 為 83.8。Foveated Diffusion 的 MANIQA 為 0.300,Imaging 為 0.619;DOVER 為 0.743,VBench Q. 為 83.9。兩者在這個設定下速度領先,但四項質素分數都低於全解像度基準。
MPEG-Diffusion 在相同測試中的 MANIQA 為 0.397,Imaging 為 0.644,兩項均高於上述加速方法。DOVER 為 0.794,同樣領先兩者;VBench Q. 為 83.9,與 Foveated Diffusion 持平。它以較低的加速幅度,換取前三項指標更接近全解像度的結果,同時省去預設區域輸入。這組證據支持的是指定影片設定下的取捨,不能直接推廣至所有模型或生成尺寸。
文字生成圖片亦有示例,項目採用 FLUX.2 4B,解像度為 1024×1024。不過,這部分展示的是方法可延伸至圖片生成,並未提供對應的量化速度比較。對正在測試生成流程的團隊而言,圖片示例可供觀察區域分配效果,影片測試的 4.8× 則不應直接套用到圖片工作流。
背景快速移動時,高、低解像度區域之間的過渡偶爾仍會變得明顯,動態背景因此是後續試片需要檢查的條件。目前研究只訓練選區用的 linear head,端到端 fine-tuning 仍列為下一步方向。程式碼標示為 soon,仍須等待程式碼公開。