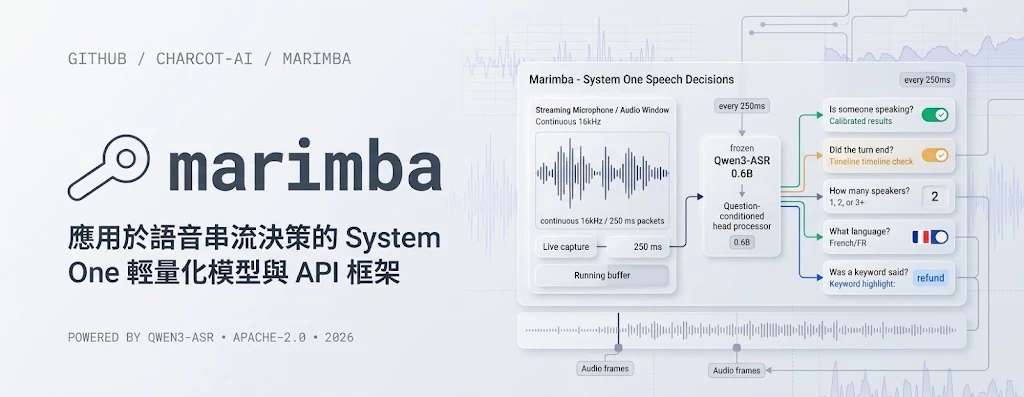
即時語音系統常遇到一個矛盾:想判斷對話狀態,卻不想為每個問題重新處理整段音訊。Marimba 的做法很直接,集中分析音訊視窗最後 8 秒,再以同一份音訊編碼結果回答多個結構化問題。
Marimba 屬於音訊分類與推論工具,實際處理的是「音訊發生了甚麼」而非「音訊說了甚麼」。它可以判斷是否有人說話、說話者是否完成一輪、語言選項、關鍵詞出現與否,以及說話者是否轉換;它不是 speech-to-text(把說話內容轉成文字)系統,也不會辨識個人身份或建立時間線。
首次載入模型時,系統會按 marimba.weights.DEFAULT_MODEL_REVISION 固定的版本下載權重及 Qwen3-ASR-0.6B 編碼器,並以 SHA256 校驗檔案。之後可把音訊檔、位元組或陣列交給 model(audio, questions);大量檔案可使用 batch 或 Hugging Face datasets 的 map_fn,即一次處理資料集中的多段音訊。
它把問題分成三種輸出:Question.noul 回傳布林值,Question.score 回傳機率,Question.choice 回傳選項及各選項機率。同一視窗的所有問題共用一次凍結的 Qwen3-ASR-0.6B encoder pass,之後由小型 readout、question-conditioned head(按問題調整輸出的模組)和凍結 decoder 產生答案。這種分工減少重複編碼,也讓同一份音訊可同時追問多項狀態。
Marimba 的幾個重點如下:
- 已驗證工作包括
turn_end、voice_activity、language、term、same_speaker、speaker_change與speaker_count。 - 可處理單一音訊、batch、Hugging Face
datasets、即時串流,以及 encoder/decoder 分工排程。 - 串流輸入須為 mono 16 kHz;
hop_seconds=0.25每次推送 4,000 個float32樣本。 - 提供 OpenAI-compatible server、Pipecat、LiveKit Agents、Vapi、本機 demo、Runpod Serverless decoder worker、Space 與 benchmarks。
pii仍是 experimental,須由呼叫端提供文字偵測器;audio_class則沒有可用安裝路徑。- 不可用功能會回傳
None,不會以其他預測冒充答案。
在 NVIDIA L4、bf16、batch one 與 8 秒視窗的公開 API 測試中,turn end 的 p50/p95 latency(延遲中位數與第 95 百分位)為 12.23/13.31 ms,voice activity 為 14.40/15.77 ms。language 明顯較慢,為 153.67/160.80 ms;term 更達 1399.44/2349.14 ms。項目沒有宣稱即時處理保證,適合與等候時間較長的工作流結合。
Accent、language、noise、overlap、microphone 及 domain shifts 都可能改變決定,語言選項中的 Other 亦只是聚合其他受支援語言,並非 unknown-language detector。實際接入時,可用 model.calibrate(windows, labels, question) 以自家資料校準,再透過 marimba serve 供路由器或 OpenAI SDK 使用。這個版本更適合需要快速判斷對話狀態的語音代理、客服流程與 LiveKit/Pipecat 整合,而非需要完整逐字稿、身分確認或安全關鍵決策的系統。