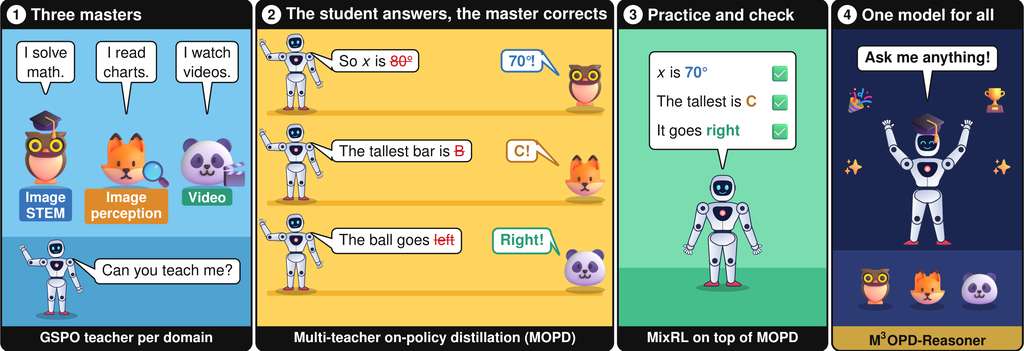
同一批題目,學過仍能再進步。M³OPD-Reasoner 是一套多模態模型後訓練配方,把圖像理科解題、圖像理解和影片推理集中到同一模型。訓練資料經全部 21 個 benchmarks 去污染後,最終模型的整體 mean avg@8 accuracy 為 75.9%,高於起點 Qwen3.5-9B 的 69.4%,亦是所列比較中的最佳值;但這不代表每次回答都有同等可靠程度。
配方先訓練各科教師,再把能力交給同一學生,最後繼續強化學習。研究人員要驗證的不是「加新資料會否更好」,而是學生已吸收各領域能力後,同一批 193K prompts 還能否帶來改善。因此最後階段沿用教師的 reward 和 GSPO settings,減少資料及訓練設定改變帶來的替代解釋。
教師全部從以所屬領域的題目進行 GSPO,即依照回應獎勵更新模型的強化學習方法。學生則在所有領域的題目聯集上自行生成答案,再由對應教師逐個 response token 評分。這個 MOPD 流程讓學生學習教師如何分配下一個 token 的機率,而非只照抄預先寫好的答案;訓練採用 top-32 reverse KL,約束學生與教師的輸出分布差異。
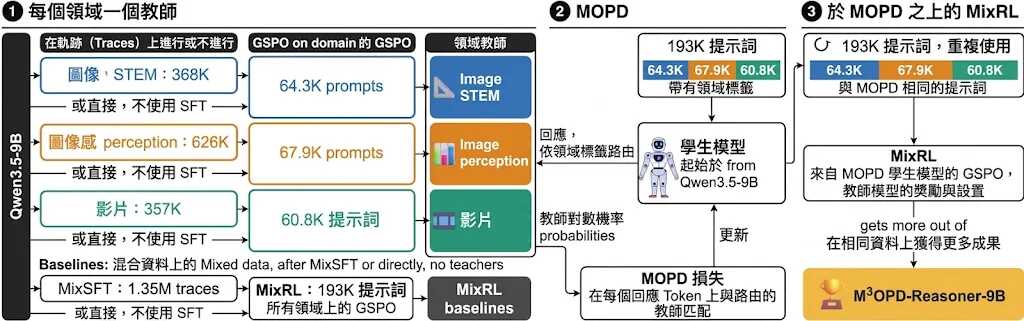
主流程沒有 SFT,即先用示範答案作監督微調的步驟。對照組則包括先做 MixSFT 再做 MixRL,以及直接從基礎模型做 MixRL;兩者都把不同領域資料混合,訓練單一模型,不經教師蒸餾。另一條公開配方會先為教師做 SFT warm-up,讓研究人員能分開檢查:改善究竟來自示範答案預熱,還是教師分工後再整合的流程。
同一去污染及 mean avg@8 accuracy 測試下,MixSFT 加 MixRL 的整體成績是 73.5%;直接從 Qwen3.5-9B 做 MixRL 則是 74.4%。各領域教師合併計算為 75.2%,MOPD student 同樣是 75.2%,但前者代表多個教師,後者已是單一模型。學生再做 MixRL 後達到全表最佳的 75.9%;項目文件報告沒有出現能力崩潰,但這仍只支持該資料與設定下的結果。
試用不必重跑教師訓練:可下載 M3OPD-Reasoner-9B,透過 Transformers、vLLM 或 SGLang 載入。模型沿用 Qwen3.5-9B 的架構、文字切分器、媒體處理器及對話格式;重現測試時應開啟 thinking、不加 system prompt,並在問題後附答案格式要求。做圖像或影片分析的團隊,可先用自己的樣本比較最終模型與基礎模型,不能把上述平均成績直接當成業務準確率。
重訓的門檻遠高於載入模型。文件的全部訓練設定都使用 4 個 nodes,每個配備 8 張 H100 80GB GPUs;MOPD 還須分配節點處理教師評分。重現環境涉及 Python 3.12、CUDA 12.8,以及指定版本和補丁的 verl、lmms-engine。資源不足以照搬配置的團隊,不能假設縮小硬件後仍有相同訓練速度或結果;文件亦未交代推理最低硬件要求。