真正將生成式影像投入專業商業生產線的創作者,往往面臨著難以言說的妥協:一般模型輸出解析度長年卡在 1024×1024(約 100 萬至 400 萬像素),若要用於印刷或 4K/8K 螢幕,必須仰賴外掛的 Upscaler(超解析度放大演算法);而這些外掛放大器往往會破壞原圖細節,甚至生成不自然的面部扭曲與塑膠質感。此外,多數開源模型在面對多圖參照、精準編輯時,指令遵循度(Instruction Following)常顯疲態。
MiniMax 官網最新推出開源 MiniMax-H3-Image 影像模型,它提供兩種入口,方便開發者將生圖與編修接入創作流程。編修時可同時輸入指令及 1 至 16 張參考圖。
輸出可自訂寬高,或按長寬比配合面積級別設定,最高達 2,000 萬像素。兩種尺寸設定不能混用;當中的 1K、2K、4K 代表目標面積級別,並非固定邊長。
- 每次可生成 1 至 10 張圖片。
- ComfyUI 亦已正式發佈 Template 支持
- 支援 jpeg、png、webp 輸出。
- 啟用 stream 後,結果會逐張傳回,不提供預覽圖。
- 不支援遮罩編輯或透明背景。
prompt 最多接受 32,000 字元,但關閉提示詞增強(prompt enhancement)後,約只有前 4,096 個 tokens 生效,安排詳細需求時要留意。
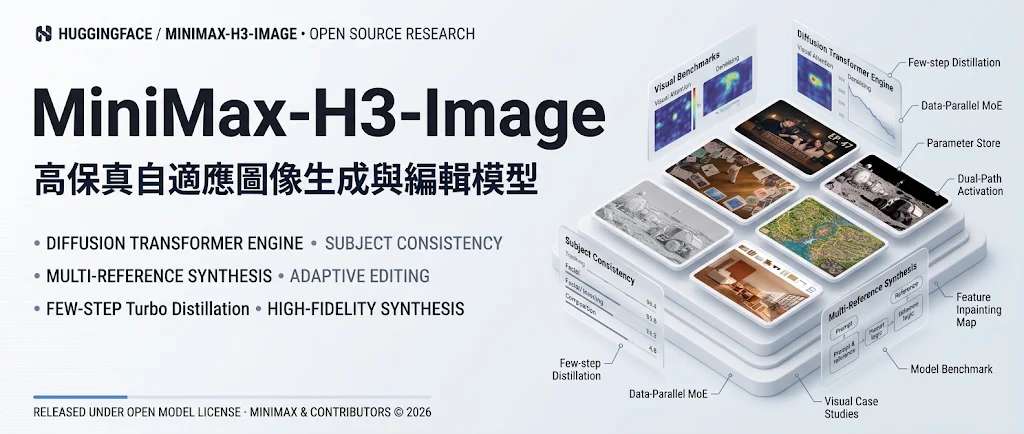
MiniMax-H3-Image 擁有高達 331 億(33.1B)參數的密集型單流 Diffusion Transformer(DiT),骨幹網絡繼承自 MiniMax-H3 系列,具備 50 層密集架構與 3D 多模態 RoPE。如此龐大的模型,若採用傳統 30~50 步的採樣排程,推論成本將極其高昂。
MiniMax 透過尖端蒸餾技術,將推論採樣壓縮至僅需 6 個採樣步驟(6 NFEs)且無需 CFG(Classifier-Free Guidance)。這意味著在 SGLang 或 vLLM-Omni 框架下,結合序列並行(Sequence Parallelism / Ulysses),可以在單卡或多卡 GPU 叢集上以極短延遲輸出巨幅畫面,使商業化的高畫質即時生成具備了經濟可行性。
需要嘗試較快版本,可指定 MiniMax-H3-Image-Highspeed,參數與限制相同。