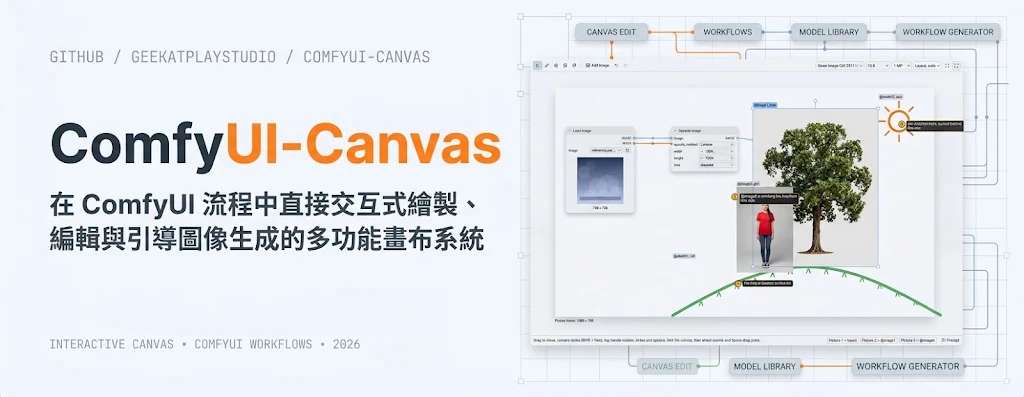
Geekatplay Canvas 把構圖安排變成可操作的畫布。這個由 Geekatplay Studio(Vladimir Chopine)製作的 ComfyUI 節點,讓使用者排列照片、畫草圖及釘選指示,再交給圖片模型生成。項目文件的女孩爬樹示例使用本機 Qwen Image Edit 2511,以 4 steps 生成;這是操作示範,不能當成構圖準確率的證據。
畫框內外的分工,是這個工具最直接的操作邏輯。框內圖片可以移動、縮放和旋轉,節點會把排列轉成位置資訊及 layout guide,也就是供模型參考的構圖示意圖;框外圖片只提供服裝、髮型或風格參考。對經常調整人物與道具位置的設計師、內容製作團隊,這種安排把部分文字描述工作搬到畫布,參考素材的角色也更容易核對。
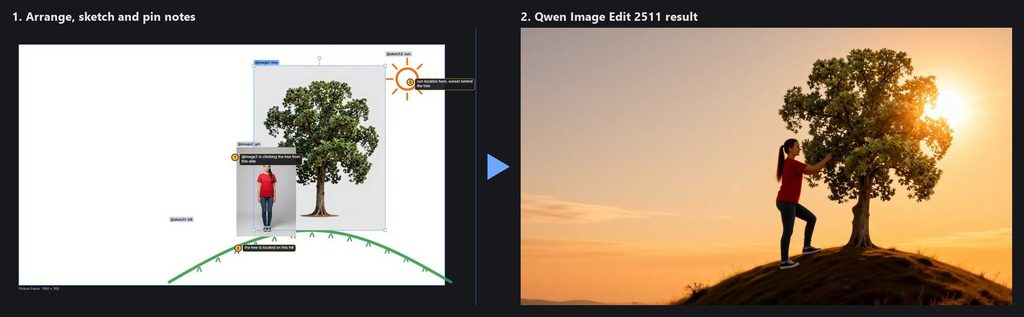
使用時可以拖放圖片、貼上圖片,或透過 Add image 加入素材,再用畫筆補上沒有照片的元素。雙擊物件設定的名稱會寫入 prompt,釘選 notes 則把要求綁到圖片或草圖。當 note 寫有 @image2 或 @sketch1,節點會改成所選模型理解的圖片名稱;執行前按 Prompt,便能檢查模型將收到的內容,找出指示是否指錯素材。
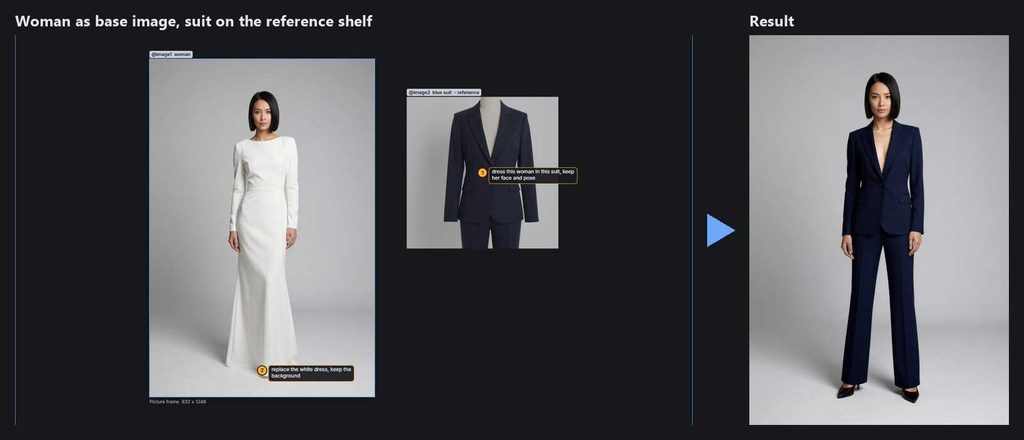
要修改既有照片,可以讓一張圖片填滿畫框,將它設為 edit mode 的 base image,亦可右擊指定。換衣服時,把人物照片放進框內,把衣服參考留在框外,再要求保留面孔、姿勢與背景,便能表達修改範圍。畫布位置仍須與文字要求一致:文件提醒,物件與 note 指定的位置相距太遠,主體可能被畫兩次;畫出的太陽圖示亦可能被原樣保留,需要用 note 說明想要真實日落光線。
同一幅畫布不能原封不動交給所有模型。MiniMax H3 會編輯 ,因此節點不向它傳送構圖拼貼圖,避免模型把拼貼本身重繪成結果,改以文字傳達位置和草圖。可選的 AI Director 會讀取附標註畫布與參考圖片,將場景描述加入整理後的 prompt;只接受文字的模型則看不到照片,使用者必須命名物件,節點才能轉成位置描述或 bounding boxes,即標示物件範圍的方框。
圖片數量也會改變素材能否完整送達。Qwen Image Edit 2511/2509 的上限為 3 張,其餘列出的多圖片模型及 Generic 上限為 8 張;超出的圖片會被捨棄,狀態列會發出警告,已放置素材仍可透過構圖示意圖看見。這意味畫布上看得到,不代表原始參考圖一定送到了模型;安排多件服裝或道具時,應先核對圖片上限與 Prompt 內容。
Supported models 如下;各欄依次列出模型、圖片上限、圖片稱呼或構圖格式,以及連接節點
| Model | Images | Images are called | Connect prompt and image_N to |
|---|---|---|---|
| Qwen Image Edit 2511 / 2509 | 3 | Picture 1 | TextEncodeQwenImageEditPlus |
| Qwen Image 2.1 / 2.1 Turbo | 8 | image 1 | TextEncodeQwenImage21 |
| FLUX.2 Klein / Dev | 8 | image 1 | CLIPTextEncode + ReferenceMultiLatent |
| FLUX 3 Klein | 8 | <ref_image_0>, plus an <obj_N> box table | CLIPTextEncode + ReferenceMultiLatent |
| MiniMax H3 Image (4K, local) | 8 | <Picture 1> | MiniMaxH3ImageConditioning |
| MOSS-Image Edit (edit LoRA) | 8 | Picture 1 | TextEncodeMOSSImageEdit |
| MOSS-Image layout (text to image) | none | JSON layout with bounding boxes | CLIPTextEncode |
| Ideogram 4 JSON (text to image) | none | JSON prompt with bounding boxes | CLIPTextEncode |
| Any text-to-image model (Z-Image, Krea 2, …) | none | composition in words | CLIPTextEncode |
| Nano Banana 2.1 / Pro (partner API) | 8 | image 1 | GeminiNanoBanana2V2 |
| OpenAI GPT Image 2.6 (partner API) | 8 | image 1 | OpenAIGPTImageNodeV2 |
| Seedream 4.5 / 5.0 (partner API) | 8 | image 1 | ByteDanceSeedreamNodeV3 |
| Qwen Image 3 Edit (partner API) | 3 | @Image1 | QwenImageEditApi |
| MiniMax H3 Image, 2K / 4K (partner API) | 8 | @Image1 | MinimaxH3ImageNode |
| Generic | 8 | @image1 | any other multi-reference model |
本機高解像度流程已有具體執行記錄,但等待成本不低。項目文件記錄 MiniMax H3 Image 在 RTX 3090 生成 3840×2176 圖片,含 AI Director 的完整 8 MP 流程約需 5 至 8 分鐘,大部分時間花在載入三個大型模型。這個時間只對應該硬件與流程,不能推作其他模型的速度;提供的資料亦未交代統一品質評測、完整模型下載大小,以及授權類型與商用限制。
安裝可經 ComfyUI Manager 輸入儲存庫網址,完成後重啟 ComfyUI 並重新整理瀏覽器,再載入附帶 workflow。環境要求近期 ComfyUI 及 Chrome、Edge 等 Chromium-based browser,已測試 ComfyUI 0.44 配 frontend 1.58,沒有額外 Python dependencies;本機生成仍須備妥 workflow 指定的模型檔案與硬件。節點本身不發出 internet requests,只有載入並執行 partner API workflow 才會使用外部服務;首次測試可沿用女孩與樹的安排,再刻意改動位置與 note,檢查結果是否重複主體。