畫面可以長時間生成,控制卻不必鎖死在單一格式。Code World Model 2.0 是一套世界模型影片生成系統,實際由 Invoker-Render 負責把結構代理轉成影片。在 140 個 held-out rollouts 的比較中,Invoker-Render 整體 Elo 為 1343.2,高於 SolarRenderer (Causal) 的 1245.3、StreamRender-H3 的 1051.9,以及 Streaming CWM 的 359.6;四個評審項目均排首位。
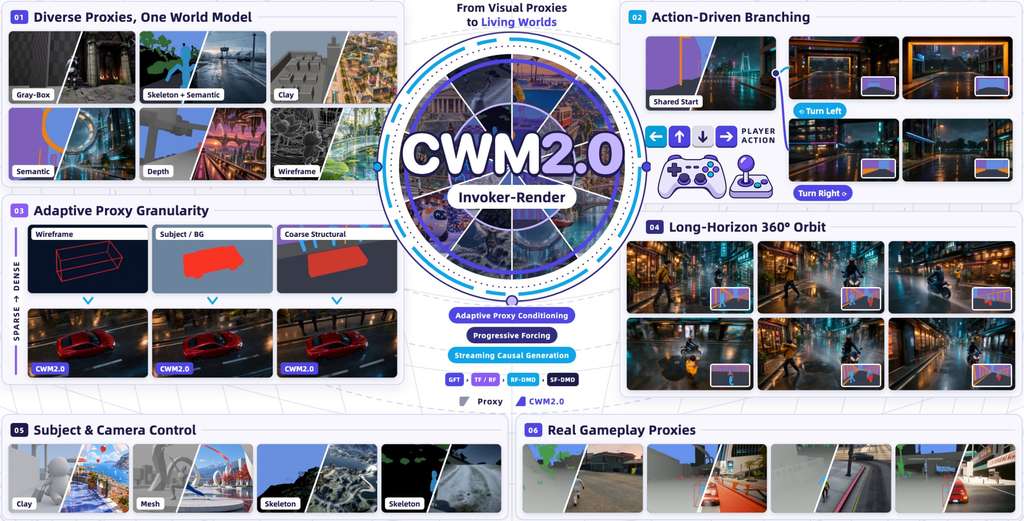
它處理的不是單純文字轉影片,而是「誰控制世界、誰負責畫面」的分工。上游引擎維持世界狀態,輸出 structural proxy;Invoker-Render 再根據 proxy、參考首幀和文字生成材質與光照。30 分鐘賽車示範以粗略 racing proxy 連續生成,中途沒有剪接或重設,但這個示範使用了預設服務沒有開啟的 reference-guided quality policy,因此不能直接當成一般部署的吞吐量保證。
proxy 可以理解成影片的結構草稿:它指定鏡頭路線、場景佈局和物件動作,卻不負責最後的外觀。同一模型可在執行時接受 semantic maps、sparse 3D boxes、subject masks、shaded geometry 或 boxes with skeletons。固定首幀和場景後,只改 proxy 就能改鏡頭路線;固定首幀和鏡頭路線後,改 proxy 就能改場內物件動作,這種拆分比每次重新生成整段影片更容易追查控制是否真正生效。
研究展示並非只把幾段漂亮片段放在一起。Camera control 固定首幀和場景,只替換鏡頭 proxy,藉此排除外觀或場景變化造成的誤判;world dynamics 則固定鏡頭,只改變交通、行人或橋樑動作。Proxy correspondence 會把 proxy 與輸出逐幀疊加,觀眾可調透明度核對物件位置,直接檢查模型是否跟隨結構,而不只依賴主觀畫質。
串流版本建基於 MiniMax-H3、SGLang 和 SGLang-Omni,並以 Progressive Forcing 分階段訓練,每個 chunk 在生成時執行 4 步。每個 chunk 只讀取固定的 appearance anchor 和有限範圍的近期生成記錄;只要持續收到 proxy 畫幀,同一個 session 就能繼續生成。這正是它和一次生成固定長度影片的做法不同之處,但也代表長時間一致性仍取決於持續輸入的 proxy 及狀態管理。
Code World Model 2.0 部署門檻不低:需要 Linux、Python 3.11 或 3.12、NVIDIA CUDA,預設 production 設定在單一節點使用 8 個 GPU。模型權重放在 Hugging Face 的 inclusionAI/invoker-render-1.0,儲存庫本身沒有附權重、prepared bundle、獨立 lockfile 或個別 checkpoint 的 artifact.json,使用者要按匹配的訓練設定、encoder checkpoint、generator weights 和 prompt 組合資產。檔案推理亦要求首幀為 1344×768 RGB,proxy 影片為 24 FPS,幀數符合 17*N+5 且至少 39 幀;完成後才會輸出 video.mp4 和 inference.json。