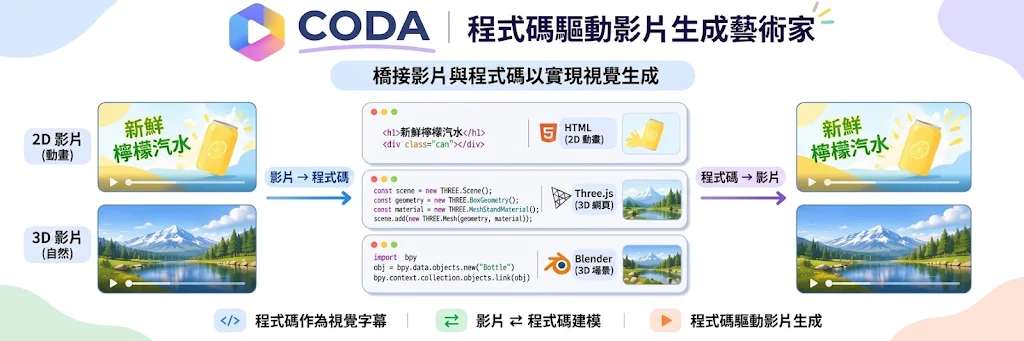
Kling Team 的 Coda 研究系列用程式碼為影片安排場景和動作。當中的 Coda-DaVinci 會判斷哪些細節需要預先固定,哪些可以交給影片模型發揮。拍切開年糕、拆去包裝的過程時,系統先為涉及的物件建模,手指怎樣彎曲、怎樣抓住包裝,就留給影片模型生成。
研究團隊把主比較的影片合成模型統一為 Seedance 2.5,讓讀者看到加入場景控制後的差別。在 T2AV-Compass 隨機抽取的 200 個任務中,直接生成的視覺指令遵從得分為 65.11,Coda-DaVinci 達 67.99。比較畫面真實感,則以直接生成的 71.38 較高,Coda-DaVinci 得 70.26。同一批影片分開評分,才看得出跟足指令和看起來自然之間的取捨。
需要控制場景時,Coda-DaVinci 會先製作 proxy,即一段用簡化 3D 物件演出動作的參考短片。環境和有明確形狀的物件會保留較多結構,人物只保留粗略輪廓,可模擬的物件互動則交給 Blender 處理。當任務講求自然的身體動作,場景位置又毋須精確控制,系統會選擇直接生成,避免成片沿用參考動畫裏僵硬的姿勢。
參考短片交代了物件怎樣移動,外觀仍要另外指定。負責編寫提示詞的智能體先檢視渲染結果,把外觀參考圖逐一對應到場景裏的人物或物件,再寫明成片要呈現的細節和人物動作。對需要反覆改片的製作團隊,共用工作區會保留場景程式碼和素材;審查者可對照同一時刻的畫格,追查應該改動場景、提示詞還是參考圖。
長片尤其考驗這套修訂方式,因為事件即使依序發生,轉場時仍可能偏離原來的場景設定。團隊測試了 29 個 LongAV-Compass 案例和 50 個 WBench 案例,報告指長片的事件完成度、結構及互動一致性有所改善,但未列出改善幅度。與直接生成相比,Coda-DaVinci 在轉場穩定性及跟隨場景設定兩方面仍然吃虧。
系列中的 CodeCap-Bench 把問題倒過來,看模型能從一段結構清晰的 2D 影片讀出多少內容。模型看過原片後,要以 HTML、CSS 和 JavaScript 寫出能重新播放畫面的程式。測試要求所有可見內容都由程式繪製,禁止貼入原片畫格或外部圖片,這樣才看得出程式本身記下了甚麼。
研究人員把程式渲染成影片,再與原片對照,既看畫面是否相似,也查物件有否在正確時間出現在正確位置。在已測試的設定下,程式比自然語言描述保留更多資訊。研究人員用重建影片測試問答,得到的答案也較準確,為單看畫面相似度提供了另一種核對方式。
想評估能否把流程接入製作環境,可先在項目首頁同步播放同一任務的成片和 3D 參考短片,對照拆包裝時物件的位置與手勢。系列總表將框架列為 2026/11 已發布,獨立介紹仍寫着 Coming soon,論文在首頁亦標作 forthcoming;本地安裝步驟和硬件需求仍待確認。