387 篇獨特論文與資源,關於影片生成遇上 Harness

想了解 AI 影片生成如何由單次生成走向規劃、互動和持續改進,這份研究索引整理了 387 篇論文與相關資源,並提供三條互補的閱讀路徑。

Video Rebirth

由創作影片、探索生成世界,到改進生成系統,研究者關心的問題各不相同。Awesome Agentic Video Generation 是一份論文與資源索引,整理 Agent harness 如何連接目標、工具、記憶、回饋與執行流程,協助讀者追蹤 Agentic Video Generation、Agentic World Modeling 和 Recursive Self-Improvement(RSI)相關研究。

三條閱讀路徑分別聚焦影片創作流程、生成世界中的行動與狀態,以及資料整理、模型訓練、評估和改進程序。它們代表不同研究情境,而非能力排名;同一項資源亦可能出現在多條路徑中,387 是去重後的總數。

索引收錄的題目涵蓋從創作簡報規劃影片、生成鏡頭和後期剪輯,到讓代理在生成世界中行動並維持狀態。例如 CutVerse 聚焦媒體後期剪輯的 GUI agents benchmark;CineAGI 探討以 LLM 編排多模態生成及跨場景整合。這些題目讓讀者可以按工作流程或研究問題尋找相關方向,但索引本身不代表每個項目都已證明具備 RSI。

  • 創作:查找規劃、素材、鏡頭生成、剪輯與來源追蹤相關研究。
  • 互動:追蹤動作條件影片、語意控制、狀態記憶及互動世界評估。
  • 改進:了解資料、訓練、評估和 harness 改進如何支援未來的 RSI 研究。
  • 延伸閱讀:資源連結通往論文或項目;整理者亦提供貢獻入口,方便提交新資源。

對研究者、影片生成系統開發團隊,以及需要快速掌握相關文獻的讀者,這份索引可作為分類閱讀的起點。它的價值在於整理與導覽,而非提供可直接執行的影片生成工具。
項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, World-Action Model, 工具, Dataset 數據集

CodeSpecWeave:寫碼容易,了解需求才是關鍵

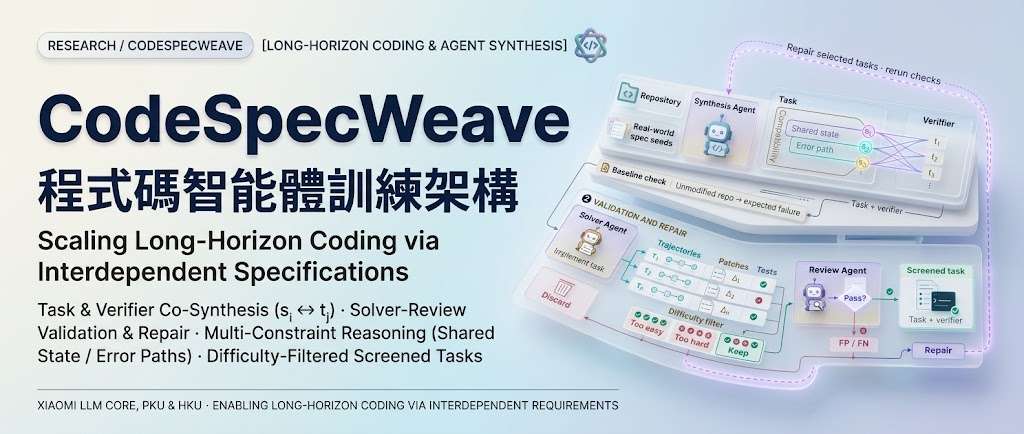
CodeSpecWeave 將互相影響的軟件要求編織成可執行訓練任務,測試編程代理能否維持整體行為一致。

Paper pipeline: task and verifier synthesis, baseline check, solver trials, difficulty filtering, trajectory review, and repair followed by revalidation.

新增一項功能,可能同時改變狀態、介面、錯誤處理路徑和執行次序。CodeSpecWeave 是一個面向 Computer-use agents 的編程代理訓練與評測項目,處理的正是這類不能逐項解決的長流程編程工作,要求代理在同一份實作中兼顧互相牽動的限制。

項目建立更貼近真實軟體工程的任務,用來訓練與評估 AI 程式開發代理(coding agents)。它不是一般的寫程式工具或線上 IDE,而是一套「產生開發任務、建立驗證測試、訓練及評估 AI」的研究框架。

網站用交易分配功能作例子:AI 不只要依金額比例分配資源,還必須同時確保總量守恆、最低分配額、四捨五入順序穩定,以及保留舊版單一收款人的行為。某一項需求單獨看似做對,整個功能仍可能不符合規格。

CodeSpecWeave 因此刻意讓需求共享狀態、執行路徑及生命週期限制,測試 AI 能不能把整組約束一起處理,而不是只寫出局部正確的程式碼。

  • 將獨立要求連結成 shared decision space
  • 同時檢查功能語意、狀態一致性和介面兼容
  • 以 executable tests 評估跨要求的聯合推理
  • 涵蓋真實 repository 與保留作評測的工程任務

項目主頁

Categories: 北京大學, Agentic, 模型, 模型訓練, World-Action Model, 香港, 軟件, 編程, Dataset 數據集, 小米-Xiaomi

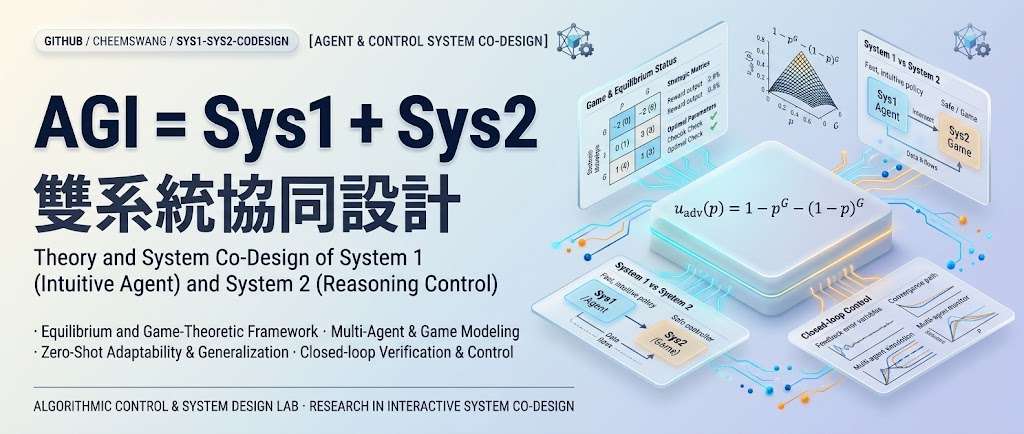
System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

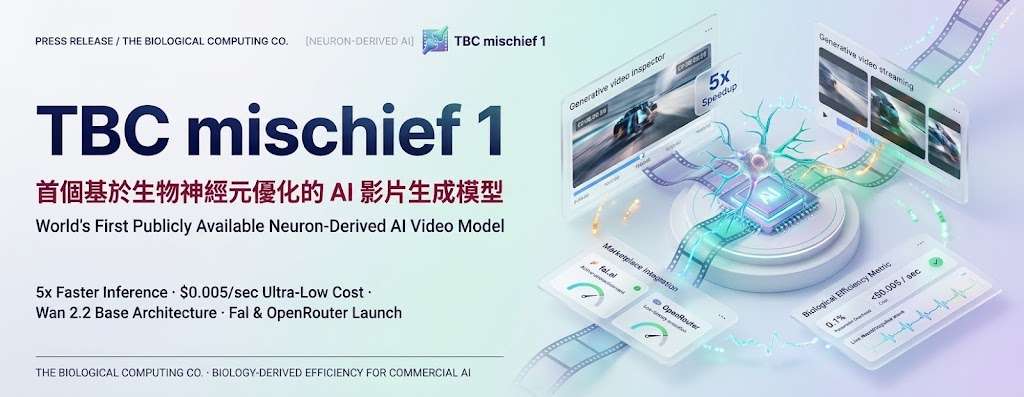
mischief 1:用生物神經元技術加速影片生成

mischief 1 建基於 Wan 2.2,主打以相近質素提供快 5 倍、成本更低的 image-to-video 生成。

6aa474e3eb96b19a0696dbe6 cta row bg

生成影片最花時間和預算的地方,往往是反覆試做、比較不同版本,再逐步修正畫面。TBC mischief 1 是 The Biological Computing Co. 推出的 AI video model,透過從活神經元取得的計算效率,處理 image-to-video 生成速度和成本之間的取捨。

TBC執行長兼聯合創辦人Alex Ksendzovsky表示:「我們曾說過,要將對活體神經元的研究成果轉化為人人都能使用的產品,而我們實現這一目標的速度遠超預期。這個模型背後是一個持續學習的發現平台。每一次實驗都加深了我們對神經元計算方式的理解,並為我們改進人工智慧提供了新的契機。」

模型建基於廣泛使用的 open-weight video model Wan 2.2,TBC 表示 mischief 1 在保持相近質素的同時,生成速度提升至基礎模型的 5 倍。項目已在 fal 和 OpenRouter 提供,定價為每秒半美仙;五秒短片約需 2.5 美仙,100 段影片約為 2.50 美元。

較低成本適合需要大量試作的影片創作者、AI-native creative studio,以及把影片生成功能整合到產品的開發者。Wonder Studios 測試後表示,模型讓團隊可以在相同時間和預算內反覆推進創意;不過,來源內容未提供具體畫質指標、支援格式或詳細使用流程。

  • 建基於 Wan 2.2,主打相近質素與更快生成
  • 生成速度較基礎模型快 5 倍
  • 每秒半美仙,適合大量試作和版本比較
  • 可在 fal 和 OpenRouter 使用
  • 技術效率來自 TBC 對活神經元計算方式的研究

項目主頁

Categories: AI productions, 模型, 視頻模型, Video, Image, World-Action Model, Content Creator

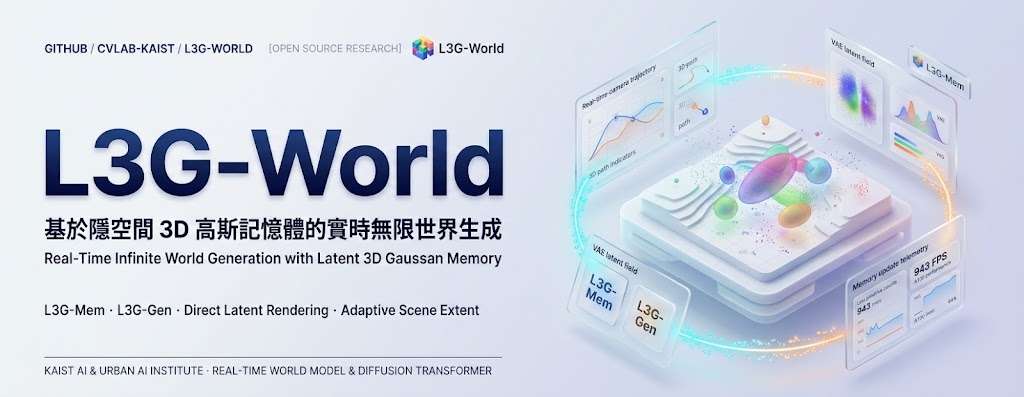
L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

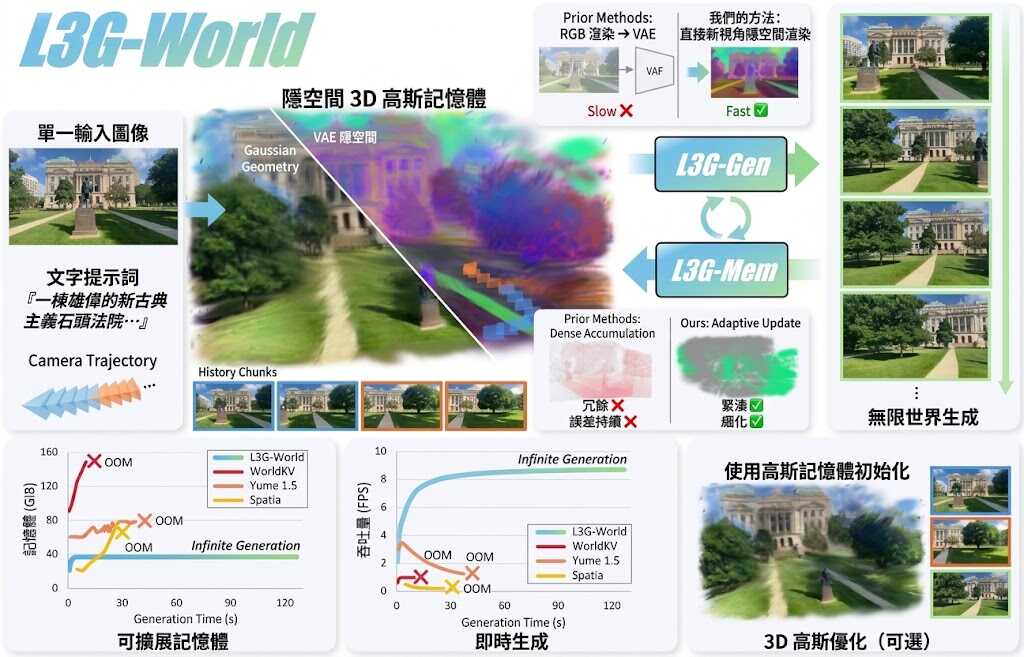
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

CLI-Anything 讓 AI 代理直接操控軟件

CLI-Anything 把圖像、CAD、3D 等軟件包裝成可供 AI 代理操作的 CLI,打通代理與既有工具之間的斷層。

icon

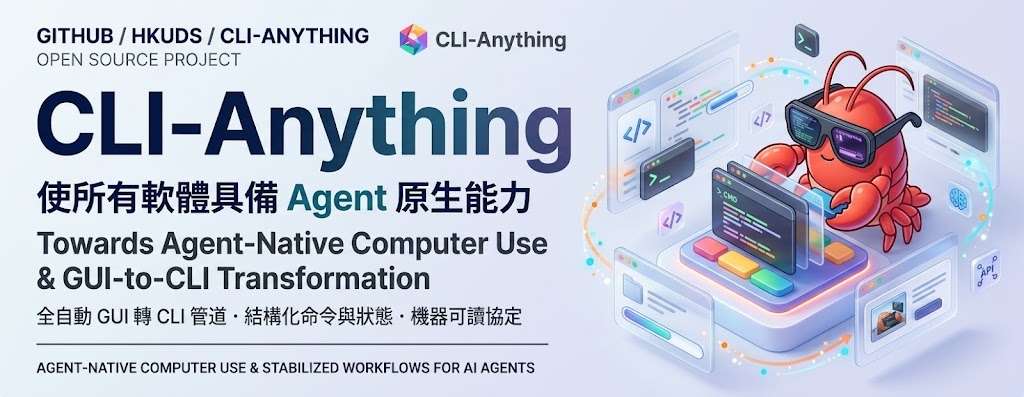
當 AI 代理需要製作 CAD、3D 場景、圖表、遊戲或字幕,CLI-Anything 會把原本面向人類操作的軟件轉成可調用的 CLI。它屬於開源的 Agentic 工具與 CLI 生成框架,處理的是代理缺乏一致介面、難以持續操作軟件及產出可驗證成果的問題。

項目以 /cli-anything 作為主要入口,並配合預覽、即時預覽及 trajectory loops,讓代理不只發出指令,還能逐步產生和檢查真實 artifact。README 亦列出 Cursor plugin、Hub 及 skills,反映它同時照顧 CLI 生成端和代理使用端;舊版本則可能要改用 /cli-anything:cli-anything。

和只依賴 GUI 操作或個別 API 整合的做法相比,CLI-Anything 嘗試為不同軟件建立較統一的代理介面,方便重用流程,但效果仍取決於每個軟件的 CLI harness 是否完整,以及代理能否正確理解工具狀態。項目提供 CLI-Hub,使用者可瀏覽、安裝及管理社群建立的 CLI;原始資料未交代各 harness 的詳細安裝步驟、資源要求或一致的性能基準。

CLI-Anything: Turn ANY App into a CLI for Claude Code & Codex (GIMP, Blender, LibreOffice & More!)

• 支援把多類軟件轉成 AI 代理可調用的 CLI
• 以預覽與 trajectory loops 協助產生可檢查的成果
• 提供 CLI-Hub 管理社群 CLI
• 適合需要串連設計、製作及自動化流程的團隊
• 仍需逐一確認各軟件 harness 的成熟度

對熟悉 Cursor 或其他代理工作流的開發者,這套方法適合用來延伸圖像處理、CAD、3D 製作及內容生產流程;對只想即時使用單一軟件的使用者,則要先確認所需 CLI 是否已建立及可用。

GitHub

Categories: 開源, 香港大學, Agentic, API, Image, World-Action Model, 框架, 軟件, 工具, IDE, 3D, 編程, Skill 技能

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

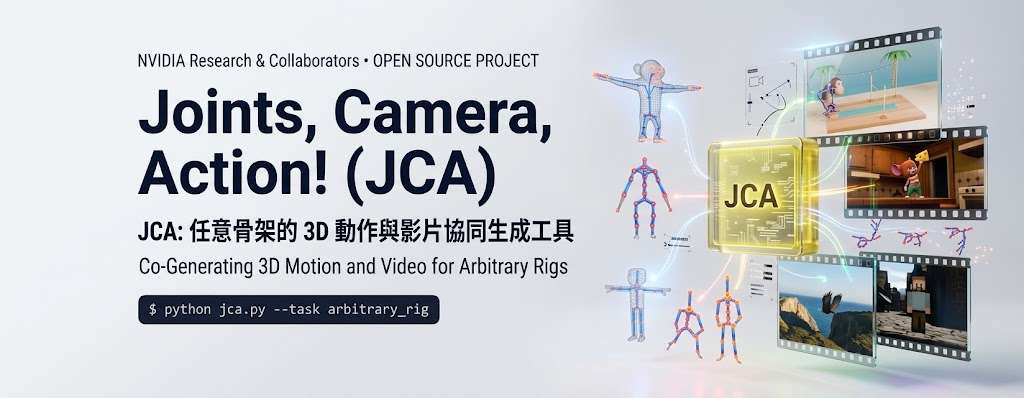
Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

Scene-Designer:智能 3D 場景生成與設計

Scene-Designer 把場景生成、質素評估與反覆修正放進同一套 Agent 訓練流程,減少無效改動。

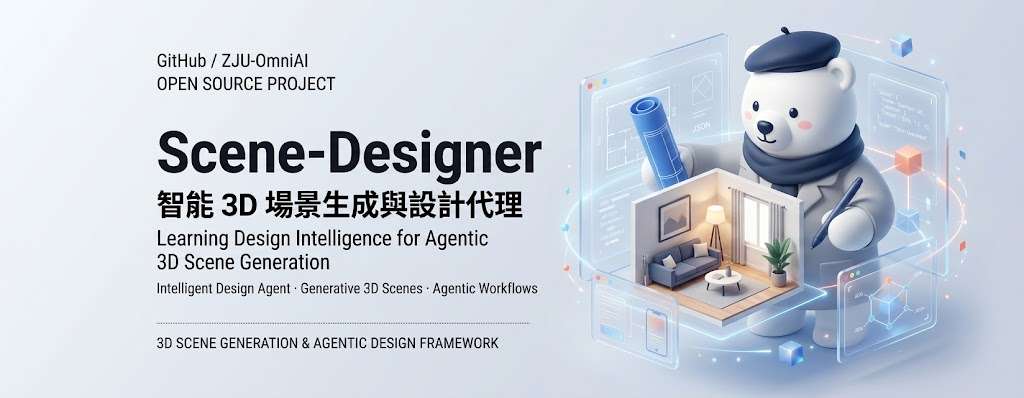
Scene-Designer bear logo

3D 場景生成最難的地方,往往不是砌出物件,而是知道場景是否合理,以及修正錯誤時避免愈改愈亂。Scene-Designer 是一個面向 Agentic 3D Scene Generation 的研究框架,目標正是讓模型學習設計場景、評審質素,再按評語作有效修正。

  • 以 Scene-OTA-35K 的 Observation–Thought–Action 軌跡學習設計與修改流程。
  • 透過 Scene-OTC-15K 的 Observation–Thought–Critic 經驗,比較場景質素。
  • 用 Branch-ranking reward 比較同一父場景產生的分支。
  • 以 Improvement reward 判斷子場景是否真正優於原場景。

Causal Trajectory Consolidation 會移除沒有下游貢獻的無效操作,同時保留有效決定及必要中間狀態。Scene perturbations 則刻意加入佈局偏差、功能退化和物理違規,再建立偏好比較,令模型不只是 spotting 錯誤,而是學習指出哪個場景較好。

Scene-GRPO 結合分支排名與改進獎勵,讓代理在相同起點的候選場景中選擇較佳設計,並減少沒有帶來實際進步的反覆修改。這種做法比只追求最終生成結果的訓練多了一層質素判斷,亦直接回應通用模型「識錯但不懂有效修正」的問題。

研究團隊比較了模型與 GPT-5.2 在成對場景比較及四場景偏好排序上的表現;首頁亦提供十組 prompt-to-scene 示範。不過,公開資料未交代完整安裝流程,Hugging Face 上已列出 Scene-Builder-Qwen3-VL-8B-Instruct 模型與 Scene-OTC-Bench 資料集,較適合具 3D 生成、Agent 訓練及模型評估經驗的團隊先行研究。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, OpenAI, 影像模型, World-Action Model, 框架, 3D, Dataset 數據集

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。

項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

Page 1 of 4
1 2 3 4