PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

MaP-WAM:把記憶變成計劃

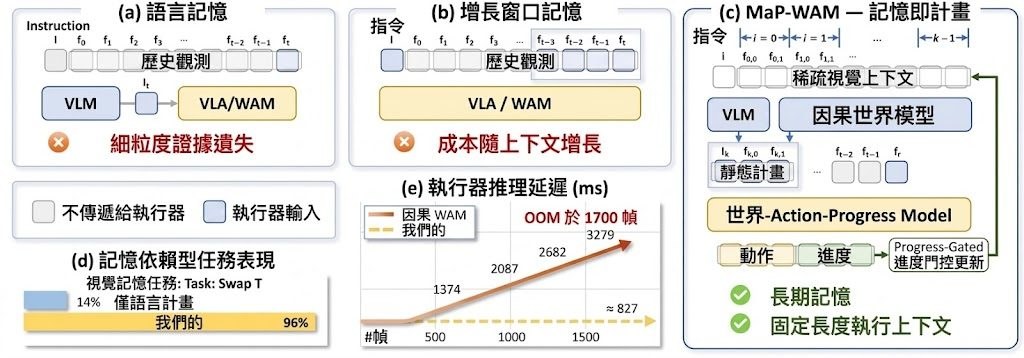
MaP-WAM 將機械臂長任務拆成「記憶 → 計劃 → 行動」三步,先保留稀疏視覺證據,再壓成固定長度的計劃執行,讓 executor 不再因歷史增長而越來越慢。

Repository image for aipixel/MaP-WAM

做過長任務的 robot policy 都知道,當動作序列拉長,模型要嘛靠語言摘要回憶過去,要嘛硬把一堆畫面塞進上下文,結果前者丟失精確視覺證據,後者則隨步數累積越來越慢。MaP-WAM 走的第三條路:把記憶視為「規劃時的證據」,而非「執行時的負擔」。它由哈爾濱工業大學、南洋理工大學及山東大學等團隊共同提出,屬於 VLA 框架與 World-Action Model 思路的延伸。

主流機器人策略通常採用馬可夫公式,但許多複雜的現實世界操縱任務本質上是非馬可夫的,需要超越當前觀察的長視野記憶。MaP-WAM 的核心分三層:每完成一段任務,便把該段的語言指令與少量真實執行幀打包成 episodic memory;之後由視覺語言模型生成下一段的語言計劃,並由因果世界模型補出對應的視覺引導;最後由 World-Action-Progress(WAP)模型在同一上下文內同時輸出動作 chunk 與進度,再以 plan-observation alignment 校正遞迴估計、以 progress-gated transitions 決定何時更新記憶並請求下一段計劃。由於已完成片段的 episodic 證據與當前計劃都可被 cache,executor 的上下文長度保持固定。

在 RMBench 上達到 83.3% 成功率、真機實驗約 78.0%,同時 executor 維持近似常數的 per-chunk 延遲。在三個長任務記憶方案中,這套設計拿來對比的恰是「語言記憶丟視覺證據」與「滑動視窗記憶吃 GPU」這兩個老毛病,並以固定上下文的方式直接拆解效率與覆蓋率的取捨。

適合關注機器人長任務、World-Action Model、VLA 框架的研究團隊與工程團隊參考。模型 checkpoint 標示為 Coming Soon,現階段只能讀 paper 與項目頁理解思路。

重點摘要:

  • Memory-as-Plans:將長任務記憶拆成「已完成片段的稀疏視覺證據 + 語言計劃」,而非把所有歷史塞回 executor。
  • WAP 模型:在同一上下文內同時輸出動作 chunk 與任務進度,並透過 plan-observation alignment 校正遞迴估計。
  • 固定上下文執行:已完成片段與當前計劃皆可 cache,executor 上下文長度不再隨歷史增長。
  • 對比清晰:直接挑戰語言記憶丟失視覺證據、滑動視窗吃 GPU 記憶體兩種主流做法。
  • 現況限制:訓練與推理程式碼、模型 checkpoint 均未釋出,目前僅有 paper 與項目頁可參考。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, VLA, World-Action Model, Robotic, 框架

Show-Harness:VLM 極簡語意操縱機械臂

Show-Harness 把機械人控制壓縮成一組離散語意動作單位,讓視覺語言模型直接負責物理決策,省去針對特定硬件的預訓練與額外參數。

Show-Harness

機械人領域一直有個尷尬落差:底層視覺語言模型(VLM)識睇識講,但要佢實際控制一隻機械臂,往往要再預訓練、加 VLA 頭或寫一大堆適配層。Show-Harness 嘗試用另一種方式切入──直接把動作壓縮成一組細粒度、離散的語意單位(例如 MV_FWD、GRASP、ROTATE_CW),由 VLM 逐個 token 推理,再交俾硬件專屬嘅 interpreter 去 deterministically 落地成實際機械動作。換句話,VLM 唔再需要理解「毫米」或「關節角度」,只需揀語意單位。

你可以用兩種方式跑:直接接駁前沿閉源 VLM 做 zero-shot 控制,又或者拎幾個 GPU 小時微調小型開源 VLM,產出每秒 12 至 33 Hz 嘅本地執行版本。Franka、AgileX Piper(單臂同雙臂)、ManiSkill、Isaac Lab 都共用同一套詞彙同一個 prompt,唔使逐隻 robot 寫 prompt。項目同時附帶 GUMI:一個瀏覽器內嘅 GUI 操作介面,等你可以用鍵盤滑鼠親身「玩」機械人收 demonstration,完全唔需要專業遙操作硬件。

  • 極薄中介層:VLM 只負責揀語意 token,所有 metric 細節由 interpreter 處理,避免額外模型容量開支
  • 跨硬件共用詞彙:Franka、AgileX、ManiSkill、Isaac Lab 共用同一套動作字典與 prompt
  • 兩種部署路徑:前沿閉源 VLM zero-shot,又或者 LoRA 微調小型開源 VLM,本地即可執行
  • GUMI 無硬件收數據:瀏覽器內 GUI 操作即收 demonstration,省去 teleoperation 設備
  • 插件式消融設計:一個目錄、一個 boolean flag,閂咗就等同冇裝

相對於 π0.5 同 GR00T 呢類 VLA 路線,Show-Harness 嘅取捨偏向「interface 解耦」──唔再要求模型本身內化硬件物理量,而是把 metric 還返俾環境層解讀。對做具身研究、想快速換 embodiment 驗證嘅團隊,或者資源有限、要靠 LoRA 微調部署嘅實驗室都幾實用;研究 embodied agent 同 VLM 接駁嘅開發者都可以直接拎去試 prompt 同詞彙設計。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 模型訓練, VLA, Robotic, Dataset 數據集

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

TANGO:人形機器人穿越凌亂房間,全靠語言指令

TANGO 是一個讓人形機器人聽到自然語言指令後,自動調整手腳、軀幹與步態避開雜物的全身控制框架,可以理解成把機械人導航從「會走」升級成「會穿過沙發底下」。

TANGO architecture and data-generation pipeline.

如果叫一部人形機械人從客廳走到廚房,但途中堆滿紙箱、雜物、窄縫,一般導航演算法只懂「規劃路徑」,對它來說幾乎等於廢武功,因為雙腳、雙手、腰部其實要邊行邊配合地形郁動。TANGO(whole-body Vision-Language-Action model)正正為這種場景而設計:收到一句自然語言指令,加上前置與向下望的 RGB 影像後,模型直接輸出 29 個自由度(29-DoF)的全身關節角度,配合 6D 底盤旋轉表示,令機械人能夠一邊行、一邊擺手收腹避開障礙。

訓練數據全部來自模擬器,背後有一套名為 Plan-Edit-Track 的流水線:先用全局路徑規劃,再做全身逆向運動學(Kinematics)動作生成,接住用障礙感知編輯避開擺位,最後用強化學習追蹤確保動作真實做得出嚟。訓練集基於 VLNVerse 與 SAGE-3D 場景,再加入側向、貼地、頂部等多類障礙,務求貼近真實家居亂況。

TANGO💃🏻 Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model

模型結構本身亦幾講究:底層係一個 70 億參數(7B)的視覺語言骨幹,配搭一個用 flow-matching(流匹配)訓練嘅 MM-DiT(Multi-Modal Diffusion Transformer,多模態擴散 Transformer)動作專家,再加一個低階全身追蹤器負責即時執行。部署時 VLA(Vision-Language-Action,視覺語言動作)模型喺伺服器低頻運行,追蹤器喺機械人 onboard 高頻運行,做到實時反應。

實驗結果方面,TANGO 喺模擬與真機測試都提升咗語言導航表現,最重要係零樣本遷移(zero-shot transfer)直接落 Unitree G1(宇樹 G1)人形機械人,唔使額外真實數據再訓練。對研究 VLA、機器人導航或人形機械人部署嘅團隊嚟講,呢套 pipeline 連數據生成到模型結構都幾值得拆解。

重點摘要:
– 語言指令直接對應全身 29-DoF 動作,涵蓋手、軀幹、步態協調
– Plan-Edit-Track 流水線全模擬訓練,配合 VLNVerse 與 SAGE-3D 場景生成
– 採用 7B 視覺語言骨幹 + flow-matching MM-DiT 動作專家雙模組設計
– 伺服器跑 VLA、機械人 onboard 跑追蹤器,支援實時控制
– 零樣本遷移至 Unitree G1,無需真實訓練數據

項目主頁

Categories: 香港大學, 模型, 視覺模型, 多模態模型, 模型訓練, Video, VLA, Robotic, 框架, Dataset 數據集

VLA 模型只學動作不夠,INDI 把「意圖」蒸進解碼器

POSTECH 提出的 INDI 框架,將行為意圖從凍結的教師視覺語言模型蒸餾到 VLA 動作解碼器,讓機器人部署時不需教師也能自主推斷行為目標。

Repository image for Leesangoh/INDI

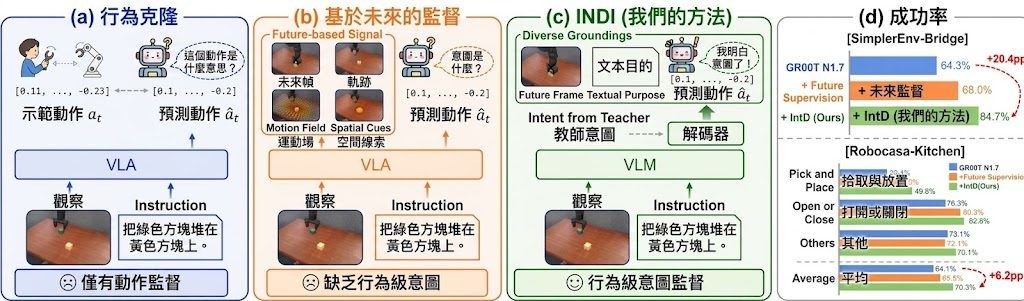
機械人模仿學習長期面對一個老問題:VLA(Vision-Language-Action)模型靠行為克隆訓練時,往往只學到「要做出什麼動作」,卻忽略了「為什麼要做這個動作」。POSTECH 團隊提出的 INDI(Intention Distillation),正正想修補這個缺口。

做法上,訓練期間會有一個凍結的教師視覺語言模型(VLM),負責將示範片段解讀為意圖表徵;動作解碼器則在中間層同時學習還原這個意圖與預測動作。部署階段不需要帶著教師模型,策略網絡自己就能從標準 VLA 輸入還原意圖並執行。對比傳統行為克隆或加入未來幀、軌跡這類「未來監督」做法,INDI 蒸餾的是行為背後的共同語義目標,而非某一種可能的實現。

實驗結果顯示,INDI 將 GR00T-N1.7 在 SimplerEnv-Bridge 的成功率由 64.3% 提升至 84.7%,在 RoboCasa Kitchen 也由 64.1% 升至 70.3%,π0.5 兩個基準皆有穩定增長。真實機械人任務平均成功率由 62.0% 提升至 68.7%,長時序任務最高有 12 個百分點的改善。研究團隊亦驗證還原出的潛在變量確實被解碼器使用,並能捕捉行為目標與執行進度。

對從事機械人基礎模型、VLA 微調,或關注長時序操作任務的團隊而言,INDI 提供了一條不增加部署成本、只改訓練目標的改良路徑。

INDI 重點摘要:

  • 意圖蒸餾而非動作模仿:用凍結教師 VLM 把行為意圖蒸進解碼器中間層
  • 部署零負擔:推理階段不需要教師模型,策略網絡自行還原意圖
  • 跨基準穩定提升:GR00T-N1.7 與 π0.5 在 SimplerEnv-Bridge、RoboCasa 皆有增長
  • 真實場域驗證:真機任務平均成功率提升約 6.7 個百分點,長時序任務最高 +12pp
  • 潛在變量可解讀:還原出的中間表徵與行為目標、執行進度高度相關

項目主頁 · GitHub

Categories: 開源, 視覺模型, 多模態模型, VLA, Robotic, 框架

StreamPI 機械人模型的記憶系統

StreamPI 為單幀 Vision-Language-Action 模型加入記憶與幾何線索,並將多幀推理的延遲增幅壓至較低水平。

Overview of the StreamPI architecture and streaming inference workflow

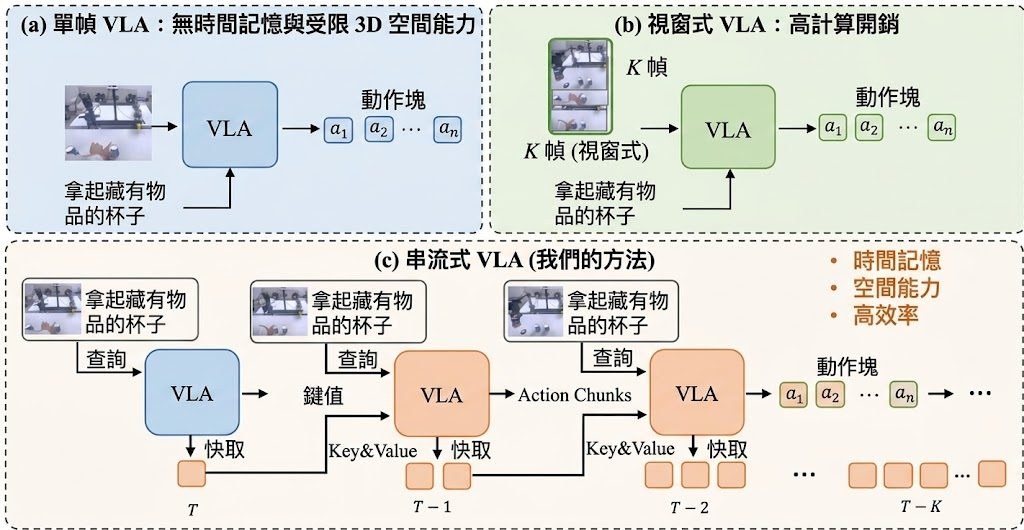
機械人執行抓取、插入等連續任務時,只看當前畫面容易失去物件位置變化;StreamPI 將每組視覺觀察與語言指令視為一個時序單元,屬於為 Vision-Language-Action (VLA) 模型加入串流時序推理能力的框架,針對的正是單幀 π₀.₅ 無法保留歷史觀察的限制。

它沒有額外加入模型參數,而是把多組 token 接在同一序列,再用 block-wise attention mask 控制資訊流。每個單元內採用雙向注意力,讓視覺與語言充分融合;單元之間採用因果注意力,配合 KV cache 保留過去內容,避免每次重新處理完整歷史。重複放入語言指令亦可令任務目標在視覺內容增加後保持清晰。

  • 以預訓練單幀模型延伸至單幀或多幀推理
  • 不增加參數,支援彈性上下文長度
  • 以 random-interval sampling 配合 temporal masking,模擬非固定觀察時間
  • KV cache 適合串流推理及非同步機械人控制
  • RTX 4090 由一幀增至五幀,平均延遲只由 94.4 ms 升至 103.6 ms

訓練時加入隨機幀間隔,讓模型接觸不同觀察節奏;研究資料亦提到每三幀取樣可令動作更快、更平順。這比固定時間同步的訓練更貼近真實機械人環境,但效果仍取決於感測器頻率、控制週期及任務本身,不能只以幀數推斷所有場景都會改善。

項目建基於 openpi,並提供 JAX multi-node distributed training 的額外支援;README 同時列出 real-robot 任務及示範影片。現有資料未提供完整安裝流程、可直接下載的模型權重或測試指令,官方項目頁只表示程式碼及權重預定於 2026 年 8 月 30 日公開,因此目前較適合機械人研究團隊參考其架構和評測方向,而非當作即時可用的套件。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 香港, Dataset 數據集

GigaBrain-0.7 讓機械人跨場景理解並執行任務

由家居整理到工業操作,GigaBrain-0.7嘗試令機械人適應更多身體形態與工作環境。

GigaBrain-0 Overview

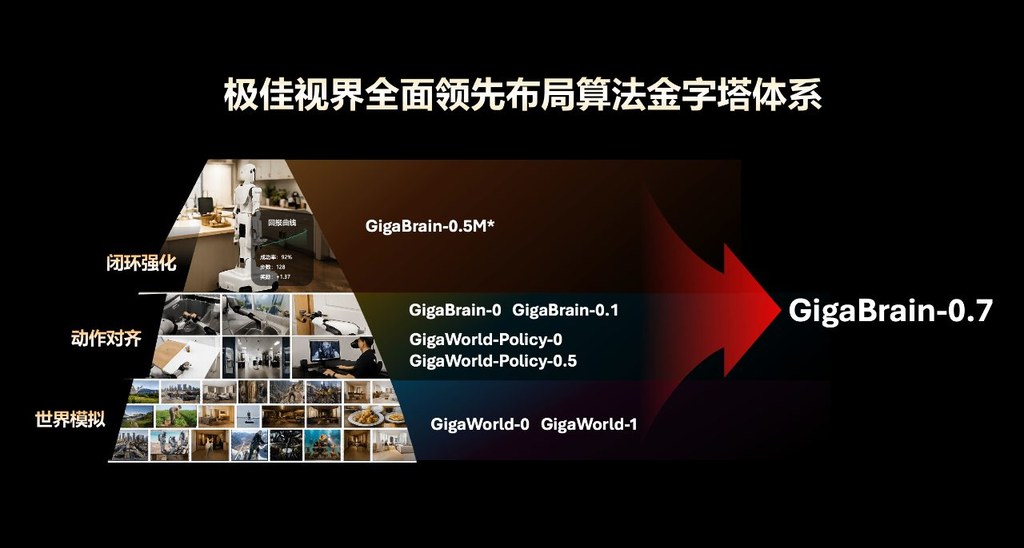
由家居整理到工業操作,機械人要面對的不只是看懂畫面,還要理解指令、預測下一步並控制不同硬件。GigaBrain-0.7 屬於 Vision-language-action (VLA) embodied foundation model,透過統一 understanding、prediction 與 action,處理跨任務及跨機械人形態的泛化問題。

項目以 three-system architecture 組織模型能力,並把預訓練資料擴展至超過 37,000 小時的異質 embodied data,再以 one-stage alignment training 同時優化 vision-language understanding 和 multi-embodiment action generation。相比 GigaBrain-0 系列及包括 π 0.5 在內的先進模型,開發團隊聲稱它在 foundation zero-shot capabilities、language-conditioned instruction following 及 post-training task success rates 均有明顯提升。

GigaBrain-0.7 已提供程式碼、模型和 sample data,模型及資料亦連接至 Hugging Face;但 VLM evaluation code、RoboColiseum、RoboTwin2.0 和 EBench benchmark code 仍列在待辦清單。這代表項目適合研究團隊先重現流程及測試資料管線,未必已具備完整、即插即用的標準化評測環境。

讀者可從以下幾點理解其價值與取捨:
– 支援多種機械人形態,目標是提升跨硬件泛化能力。
– Maker H01 及主流機械人平台涵蓋家居和工業場景。
– 大規模異質資料有助擴闊任務範圍,但亦提高訓練及硬件需求。
– 開放程式碼、模型與樣本資料,方便研究及二次開發。

對機械人研究、具身智能及需要跨平台控制的團隊,GigaBrain-0.7提供了較完整的模型、資料與訓練實作入口;商業落地仍需自行驗證安全性、硬件兼容性、延遲及長時間任務穩定度。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, Dataset 數據集

τ₀-VLA:為長程機械人任務補上分層推理

τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

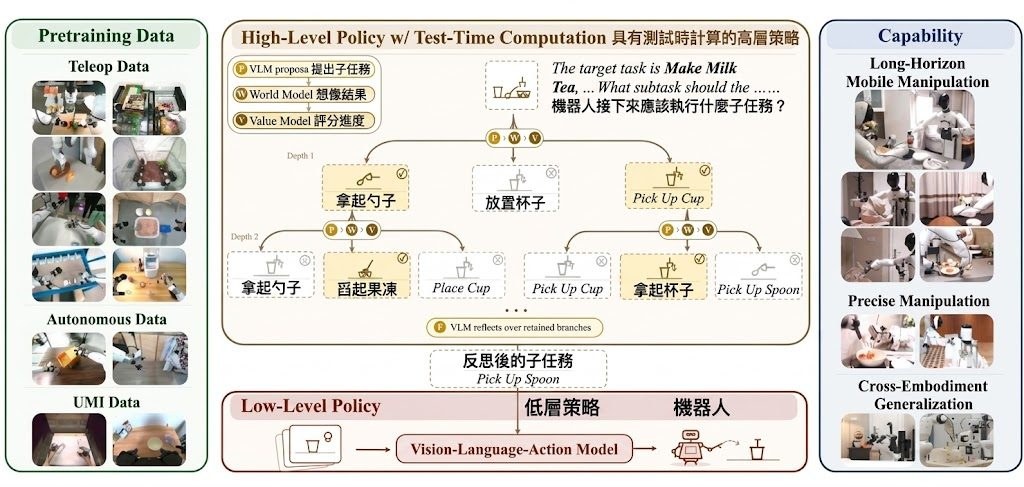
τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

RynnValue 用秒估計機械人完成時間

它不只判斷機械人有冇做對,仲會估計距離完成仲差幾多秒。呢種時間式價值訊號,令強化學習獎勵設計變得直接得多。

RynnValue overview

機械人操作最難的不只是識別動作成敗,而是要持續知道距離完成指令仲有幾遠。RynnValue 就是針對呢個空缺而來的模型項目:它把機械人影片連同文字指令一齊讀入,逐格預測剩餘完成時間,並輸出自然語言分析,讓進度估計、失敗偵測與 VLA(vision-language-action)policy 的獎勵建構可以共用同一套訊號。

它和常見進度分數或偏好標註做法的分野很清楚。RynnValue 不靠人工標出「較好」軌跡,也不把進度硬壓成 0 到 1,而是直接學習 goal-conditioned cost-to-go 的物理時間;標籤來自時間戳,配合子任務切分與 cutoff relabeling,於是能擴展到 7,000 多小時、約 300 萬段 instruction-conditioned clips 的異質機械人資料。這個取捨帶來的好處是可擴展,代價則是模型必須更好地處理長尾任務時長與不同視角、不同 embodiment 的差異。

RynnValue 連同完整工具鏈一併提供。你可以把它理解成一套由 HuggingFace 相容模型、影片推理示範,到 reward-model benchmark 與強化學習介面都包起來的研究型工具組;當中 RynnValue 建基於 RynnBrain,實作在 Qwen3-VL architecture 之上,除了預測 absolute 與 relative temporal value,亦會生成影片描述,並判斷 instruction–video 是否匹配、任務是否成功。

  • 核心能力是把「距離完成尚餘幾多秒」變成稠密 value signal
  • 訓練毋須 preference 或 progress annotations,較易放大量異質資料
  • 8B 版本在 RBM-EVAL-OOD 的平均 Kendall’s τₐ 達 0.675,高於文中對照的 fully preference-supervised 方法 0.655
  • 可直接接到 reward shaping,用作 policy ranking、evaluation 與 reinforcement learning critic

為免模型偷看序列位置去猜進度,作者加入 temporal-order shuffling、random temporal sampling,以及 value-isolation attention;消融結果亦顯示這些設計不是裝飾,拿走後指標會明顯下跌。再進一步,它把輸出的 value 轉成 potential-based shaping reward,在雙臂 Franka 的真實機械人學習中,無論 online 定 offline 都比最強 reward-model baseline 有更高成功率。

最受惠的會是做機械人操作、VLA 訓練、reward modeling 與 embodied AI 評測的團隊,尤其想減少人手標註成本、又需要跨資料來源泛化能力的人。限制同樣存在:這類時間距離訊號雖然比二元成敗更細緻,但對任務切分、影片品質與觀測覆蓋仍然敏感,而且它目前聚焦於 robot manipulation,不代表可直接外推到所有 agent 場景。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, Dataset 數據集

Page 2 of 5
1 2 3 4 5