ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

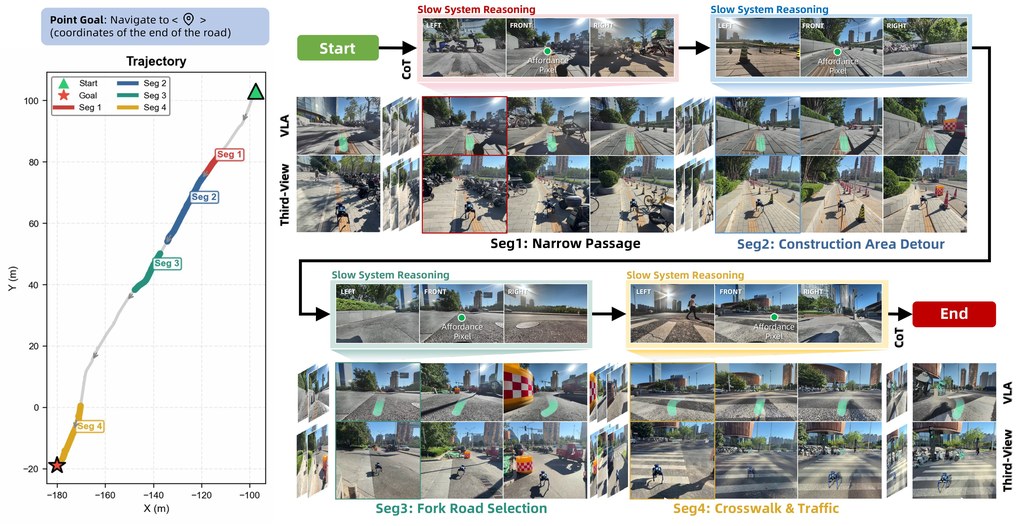
它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。
項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

RCORE 為什麼我打不開抽屜

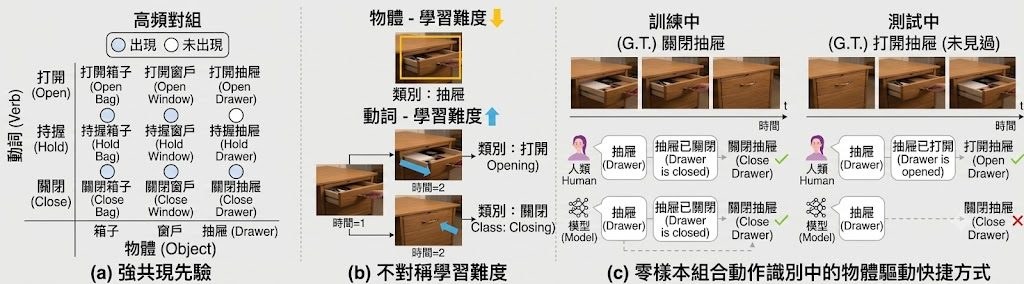
同一個抽屜,模型可能只見到物件就判成「關上」。RCORE 針對這種偏差補上時序線索,重點不在多記類別,而是少走錯路。

RCORE teaser

見到抽屜就猜「關上」、見到杯就猜「拿起」,正是 Zero-Shot Compositional Action Recognition (ZS-CAR) 最容易失手的位置。RCORE 是一個研究型模型項目,處理的是新 verb–object 組合辨識,核心不是再加更多標籤,而是壓低模型依賴物件類別走捷徑的傾向。

現有做法多數沿用已見過的共現關係去推斷動作,作者指出這種 fixed compositional supervision 會令模型把 object 當成近路,忽略影片中的 temporal evidence。RCORE 的回應很直接:用 CPR(Co-occurrence Prior Regularization)補足原本缺席的組合監督,同時把常見配對當成 hard negatives;再用 TORC(Temporal Order Regularization for Composition)迫使 verb 表徵對時間順序敏感,而不是學成靜態語意。

這個取向的價值,在於它不是單純追求更強 backbone,而是修正 ZS-CAR 的學習偏差。論文亦加入 FSP、FCP 與 Compositional Gap 這幾個診斷指標,不只看最後準確率,亦檢查模型是否真的較少受 co-occurrence patterns 牽引;已公開資訊指出,它在 Sth-com 與 EK100-com 都能改善 compositional generalization。

  • 重點放在減少 object-driven shortcuts,不是單靠物件猜動詞
  • CPR 針對訓練配對偏斜,TORC 針對時序線索不足
  • 準備 Python 3.10、requirements,以及特定 tokenizer 詞彙檔
  • InternVideo2 1B backbone 依賴 flash-attn,CLIP / InternVideo2-Base 則較易測試

部署與測試方式偏向研究流程:先安裝相依套件、準備資料,再跑 training 與 evaluation;它較適合做影片理解、組合泛化或 benchmark 分析的團隊,而不是即插即用的產品工具。相關模型與骨幹包括 CLIP、InternVideo2-Base、InternVideo2 1B;對於想研究模型為何會「看錯動作」的人,RCORE 比單看分數更有參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, Qwen, VLA, Robotic, Python, Dataset 數據集

ARDY 讓 3D 角色動作可即時受控

想像你一邊改文字指令,一邊即時見到角色順住路徑、姿勢同目標動起來。ARDY把可控性同即時回應拉到同一個工作流入面。

Og image

一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。

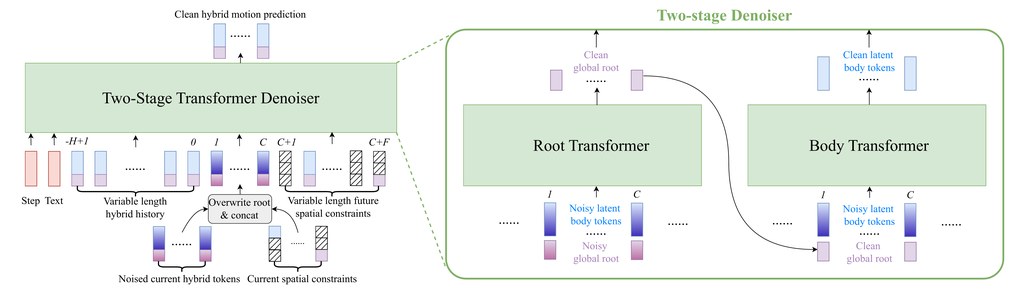
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。

它支援的約束方式幾完整,包括 root paths、waypoints、full-body keyframes,以及 sparse joint positions/rotations,亦可混合使用。更重要的是,約束唔一定只限當前生成視窗,較遠將來的目標都可以先講定,令角色更容易朝長程目標連續行動,而唔係每幾步就失去方向。

  • 支援 online text-to-motion generation,可即時改提示詞
  • 可加入 root paths、waypoints、full-body keyframes 同 sparse joint constraints
  • 兼顧即時反應、動作品質同長距離控制
  • 面向動畫、模擬、humanoid robotics 等互動工作流

資料提到,ARDY 以大型 motion capture dataset 訓練,並直接用文字標籤與來自真實姿勢抽樣的 kinematic constraints 作條件,令模型原生學會受控生成。研究團隊亦展示了互動式 demo,涵蓋動態文字控制、關鍵幀約束、路徑跟隨同即時 locomotion control;定位上,它較適合需要邊調邊看結果的內容製作與研究場景。

項目主頁 · 模型

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, VLA, 提示詞, Robotic, 框架, 軟件, 3D, 動畫, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

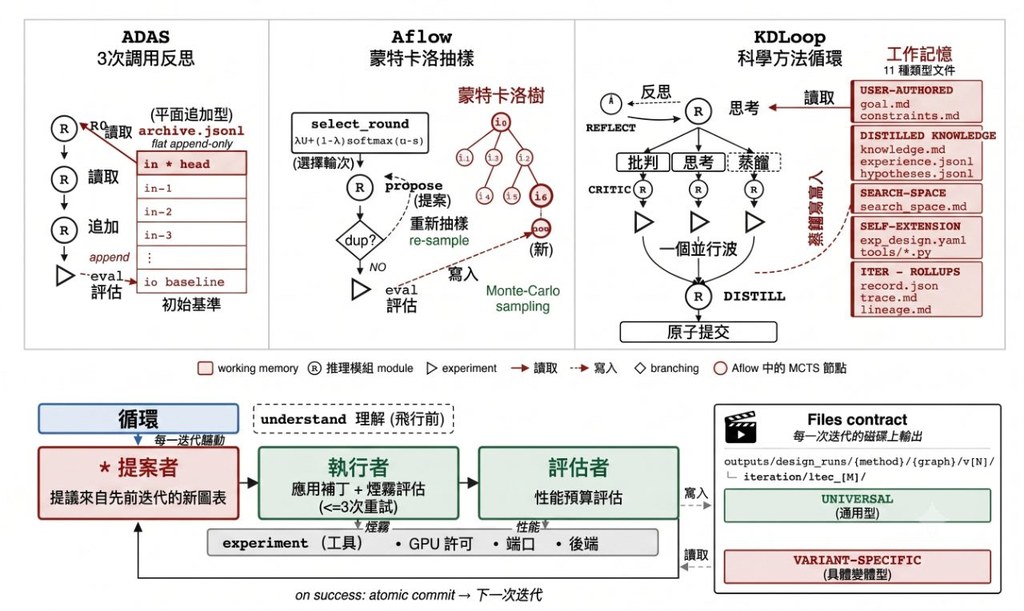
這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

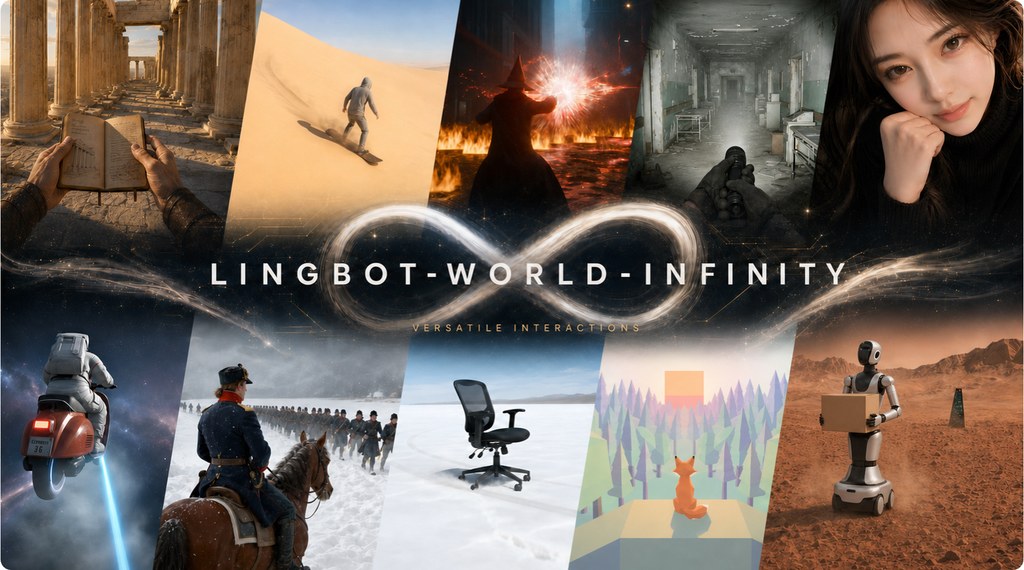
最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

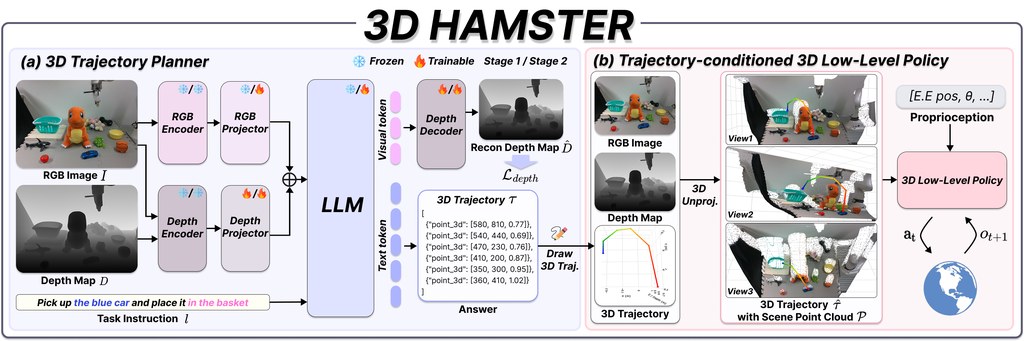
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • 走 RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

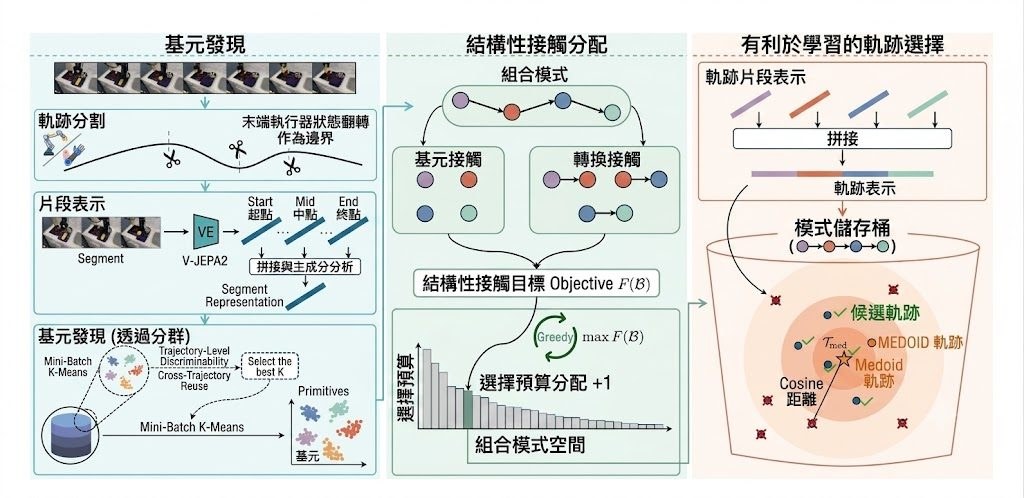
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

MIRA 把《Rocket League》變成可互動世界模型

MIRA 唔係單純重播比賽片段,而係讓四名玩家動作一齊驅動畫面生成。你可以把它理解成一個能即時模擬 2v2 對戰走勢的世界模型研究項目。

Repository image for mira-wm/mira

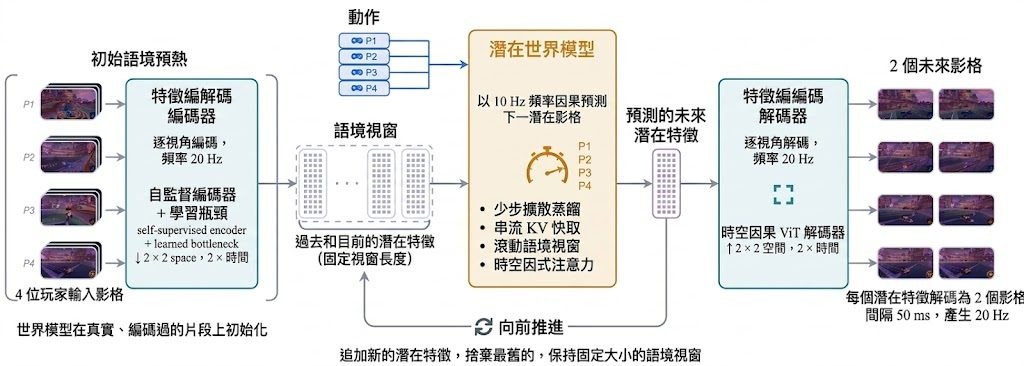
打機畫面一路變化,背後又有四名玩家同時輸入動作,呢類情境一向好難靠 world model 穩定重建。MIRA 屬於開源框架兼研究型模型項目,處理的是多人互動環境中,如何按四條 action streams 即時生成《Rocket League》對戰畫面,令 2v2 比賽可以直接在模型內運行。

現有做法多數集中在 single-player world models,其他角色通常只被當成環境一部分;作者明確反對呢種 fixed framing,因為多人場景入面,畫面變化要分得清楚邊個玩家造成。MIRA 改用 multiplayer conditioning,並配合 Representation Autoencoders 同 latent diffusion,目標唔只係畫面似真,而係令物理互動、攻守切換同多角色行為保持連貫。

個項目的取向相當鮮明:它唔係先追求最輕量部署,而係用 5B parameters 模型換取即時互動與長時間 rollout 穩定性。資料來自 10,000 小時 gameplay,README 亦公開了 RocketScienceDataset,當中每個 sample 都包含四個同步視角、逐格 keyboard action 同 game state,對做世界模型、VLA 或互動模擬研究的團隊都很有參考價值。

  • 屬於開源框架加世界模型研究項目,重點是部署、資料使用與評估多人互動生成
  • 與單人 world model 最大分別,在於同時按四名玩家動作生成畫面,而唔係把其他玩家當背景擾動
  • 官方指出模型可在單張 NVIDIA B200 GPU 上以 20 FPS 生成完整 2v2 對戰
  • 相關資料集 rocket-science 提供同步視角、動作與 game state,方便重做測試與分析
  • README 提供 pixi 環境安裝與 test suite 入口,但更完整部署細節仍要靠原始程式與技術報告配合理解

就公開結果看,MIRA 最有說服力的地方唔係單一 benchmark 數字,而係它把「多人動作歸因」變成核心問題,再補上對物理理解的 targeted evaluations。官方亦表示,雖然模型只用短片段訓練,distributional quality 可維持到五分鐘量測範圍,實驗中甚至能持續更長時間;不過硬件門檻高,定位更接近前沿研究平台,而唔係一般人可隨手在本地執行的輕量工具。

項目主頁 · GitHub · Paper

Categories: 開源, 世界模型, NVIDIA, Gemini, VLA, Dataset 數據集

InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

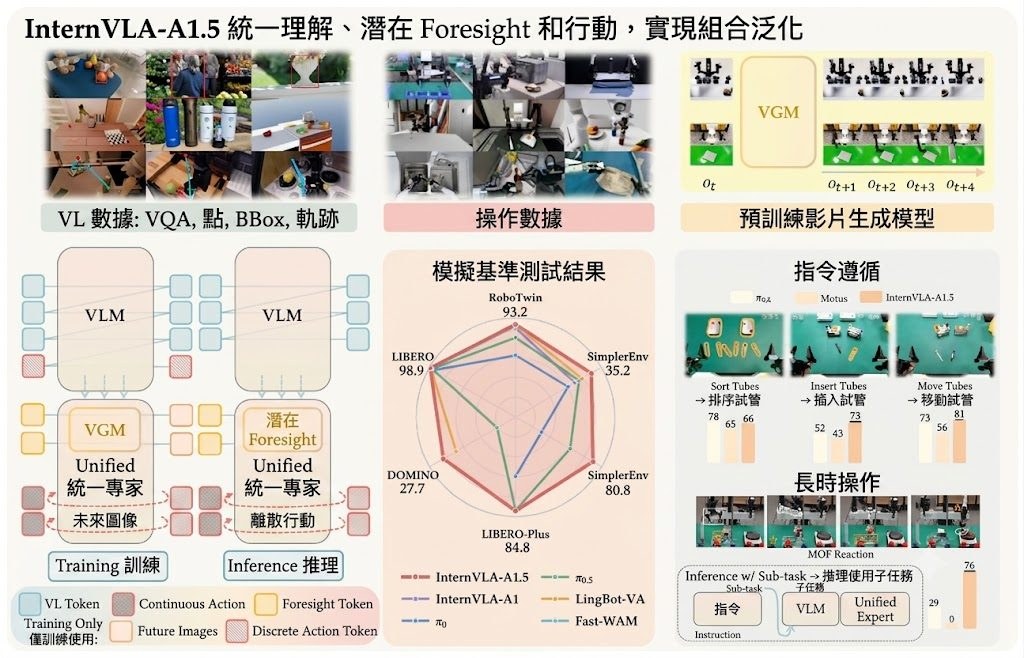
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集

EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

Page 3 of 4
1 2 3 4