jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。
GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

ComfyUI-MiniMaxH3-TimelineDirector:一張圖跑出無斷點長影片

想在 ComfyUI 內一次過生成超過一分鐘的影片,又要角色口型與背景音樂全程對得齊?這套 MiniMax H3 Timeline Director 插件把分段、續接、漂移修正全部收埋喺一張圖。

Creator WeCom contact card

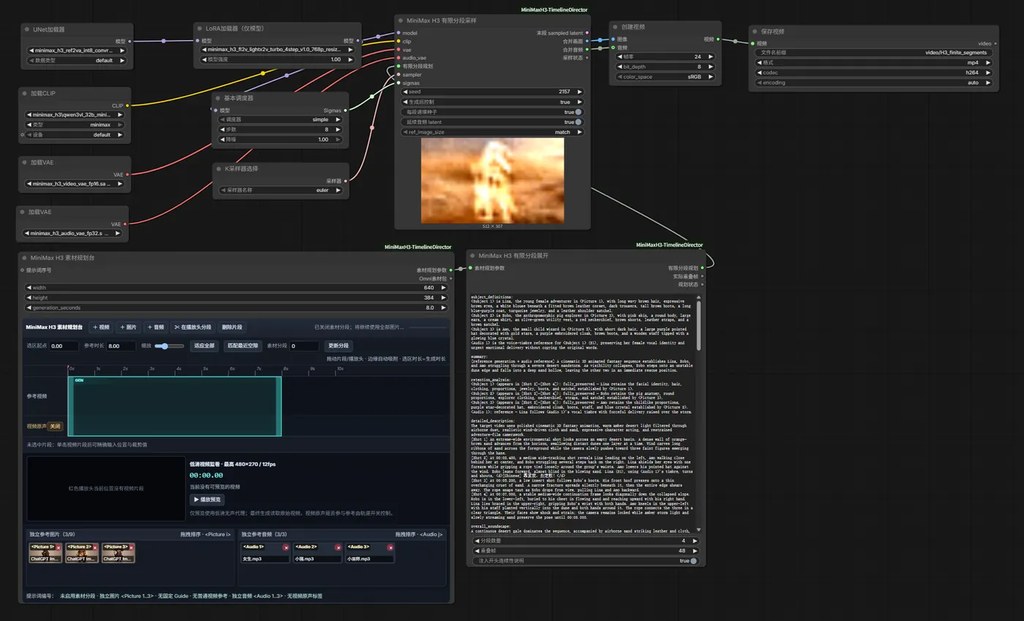
MiniMax H3 官方最令人卻步嘅限制之一,就係單次生成時長偏短,想做一段完整 Demo 或者長 Demo 都要靠 Loop 節點逐段駁,駁完口型同音軌成日走樣。ComfyUI-MiniMaxH3-TimelineDirector 嘅切入點正正喺呢個位:佢提供一個 Full Timeline Director 工作流,把 T2V、Image Reference、音訊驅動、角色替換、動作遷移、數字人同一條龍長片生成,全部塞入同一張 ComfyUI 圖。

插件會把目標時長拆成連續 GEN 窗口,並用同一個共享 seed 串接前一段嘅 AV-latent 尾部,配合 Drift-Control 影片遮罩同 Soft AV 音訊連續性處理,再做 overlap 移除並最終同步輸出成片。長度上限唔再由 Loop 節點或者重複 Sampler 鏈決定,而係睇本地 VRAM、RAM、磁碟空間同 ComfyUI 執行限制。

佢同一般「駁長片」做法最大嘅差異,係對齊音訊嘅方式。當你將一段長 MP3 標記為 Locked Original Audio,插件會將聲音按 sample 位置精確切片,注入每段 AV latent,並以零音訊降噪遮罩保留;Timeline 比音源短就截斷,比音源長就用靜音補尾,用戶唔使再人手對 MP3 metadata 或 codec priming delay。Long-form digital humans 同角色演唱場景亦靠同一條路徑處理:角色圖同長 soundtrack 鎖定後,手動 GEN 窗口即可逐段推出口型同步。

時間軸方面,每段 Clip 設有三種模式——Fixed Guide、Editable Reference、Boundary Only,支援 move、trim、split、delete、snap 同數值定位;只有同 cyan 生成範圍相交嘅媒體先會進入當前 Reference 或 Guide 計劃,避免雜訊干擾。

實際最易受惠嘅人,係要做完整 MV 級 Demo、產品概念片、教學影片、或者 AI 短劇分鏡嘅創作者同中小型團隊。官方已放出兩條約 52.6 秒 / 1263 幀嘅直接生成示範,包括純 latent 續接同 48 幀 Reference overlap 兩個 case,可直接喺 GitHub Release 拎 MP4 對照效果。

  • 類型:ComfyUI 插件 / 時間軸導演工具
  • 核心能力:一張圖內分段續接生成無斷點長影片,音訊 sample-sliced 注入 AV latent
  • 同類差異:唔靠通用 Loop 節點或重複 Sampler 鏈,直接由 AV-latent 尾部續接
  • 適用場景:長片數字人、角色演唱、概念片、教學影片等需要連貫長片嘅創作
  • 部署方式:經 ComfyUI Manager 或手動放入 custom_nodes 目錄後啟動 ComfyUI,載入 example_workflows 內嘅 All-in-One 工作流即可

項目主頁 · GitHub · Youtube 教學

Categories: 開源, ComfyUI, AI productions, 數字人, Video, Image, Audio, 教學, 工具, Content Creator, 音樂, MiniMax

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md。

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, 庫, Skill 技能

TempCloze:揭開 Video-LLM 的時間盲區

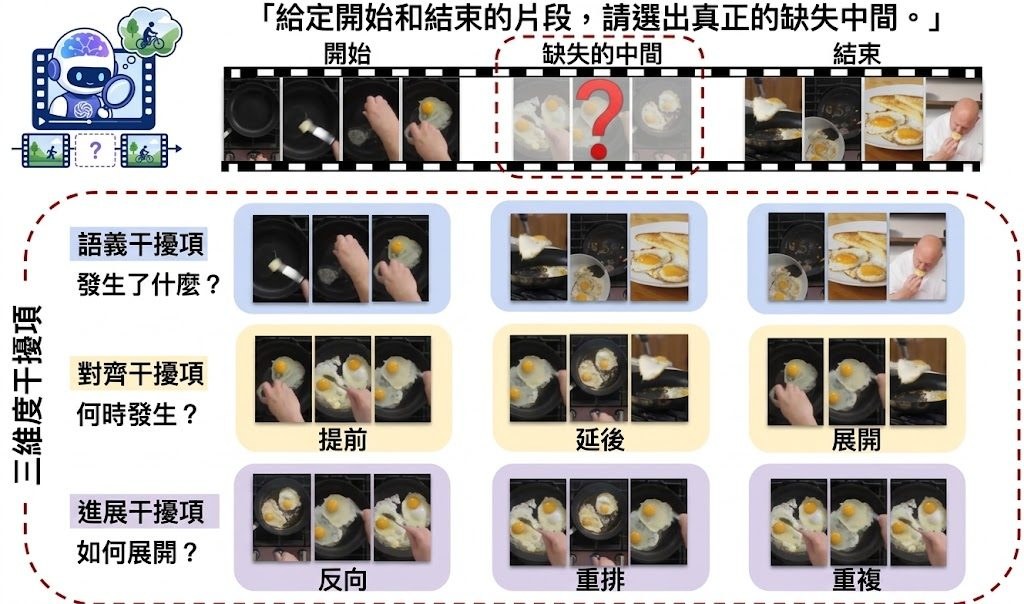
TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距

GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

pipeline

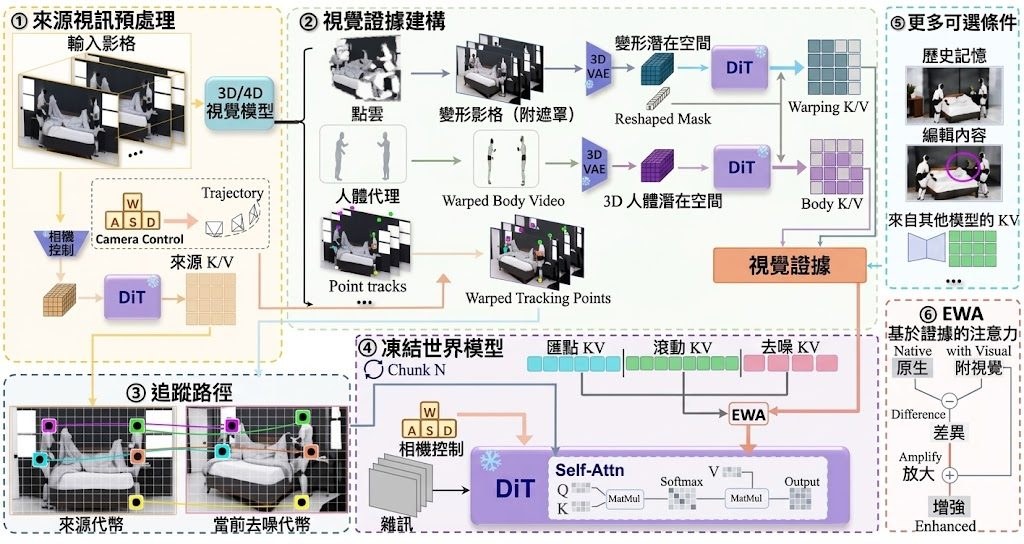
對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorld、yyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

MiniMax H3 首尾幀工作流:ComfyUI 一張面板切換三模式、輸出帶聲影片

這個 ComfyUI 工作流把 MiniMax H3 的首尾幀、Turbo LoRA、影片與音訊 VAE 全部封進子流程,外層直接選模型、改步數與時長,最後由 SaveVideo 輸出 24fps 的帶聲短片。

MiniMax H3 总控面板使用指南

想用兩張圖片框住一段六秒帶聲音的影片,再順手在 ComfyUI 面板上換模型、改步數,這個工作流把這件事收得很緊。整套流程把 MiniMax H3 的基礎模型、Qwen3-VL 文本編碼器、影片與音訊 VAE,以及四步 Turbo LoRA 全部塞進一個子流程,常用參數留在外層,內層只負責解析度對齊 32 倍數、計算幀數、把影片與音訊解碼後合成輸出。

跟一般 ComfyUI 影片節點相比,它最直接的差異是「首尾幀可選」:上方節點接首幀、下方節點接尾幀,兩個都填就是首尾幀生成,只填首幀就退回傳統圖生視頻,兩個都跳過則變成純文生視頻,三種模式不用複製工作流,直接在同一張畫布切換。音訊方面也省事,音訊 VAE 跟影片 VAE 分開載入,輸出端靠 SaveVideo 一次寫入 mp4,不用再手動合成聲道。

部署門檻主要在三個地方:ComfyUI 要支援子圖功能、要額外安裝 ComfyUI-MiniMax-H3-Turbo 節點包以取得 MiniMaxH3TurboLoRA,以及 Hugging Face 上的五個權重檔案要放到對應的 diffusion_models、text_encoders、vae、loras 目錄。JSON 內只記錄檔名而非圖片本體,使用前要把首幀、尾幀重新上傳;工作流也沒有附帶顯存或速度數據,必須自己測試本地硬體夠不夠撐得起 int8 基礎模型加 Qwen3-VL 32B 文本編碼器。

對已經在跑 ComfyUI、又想試 MiniMax H3 首尾幀能力的人,這個工作流算是最低摩擦的入口:不用自己接駁一堆節點,也不用研究子流程內部的取樣細節,外部面板就涵蓋了模型選擇、步數、目標時長、種子、寬高比與百萬像素等設定。對只想快速驗證概念或做短影音素材的內容創作者,這種「拉進畫布、換圖、寫 prompt、執行」的流程會比從零搭建省下不少時間。

重點摘要

  • 類型:ComfyUI 工作流 JSON,屬於模型整合與流程封裝類工具,目標是簡化 MiniMax H3 帶聲影片生成。
  • 核心能力:首尾幀、首幀圖生視頻、文生視頻三種模式可切換,並內建音訊解碼與合成。
  • 關鍵依賴:ComfyUI 需支援子圖,另需安裝 ComfyUI-MiniMax-H3-Turbo 節點包與五個 Hugging Face 模型檔案。
  • 輸出規格:24fps,寬高自動對齊 32 倍數,時長與步數可在外層調整。
  • 限制:未提供顯存峰值、速度與相容性測試,需自行驗證本地硬體;JSON 內只存圖檔名,圖片要重新上傳。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, Video, Image, Audio, 工具, Content Creator, MiniMax

PWM(Programmable World Model) 以世界模型驅動影片生成

AlayaLab 開源的 Programmable World Model 把世界狀態與畫面生成拆開管理,讓角色、事件與鏡頭外的物件都能被查詢、修改與驗證,不再只靠潛在影像記憶。

Programmable World Model overview

影片世界模型能夠即時渲染出像真的畫面,但畫面背後其實欠缺一部「世界引擎」——狀態藏在影像序列裡,難以檢查、編輯或驗證,鏡頭一轉,鏡頭外的角色與潛在事實就會被悄悄遺忘。AlayaLab 開源的 Programmable World Model(簡稱 PWM)正正針對這個痛點,把世界狀態的維護與視覺生成徹底解耦,由一個 state executor 負責推進世界狀態,再由 deterministic compiler 把以 state-augmented 3D OBB 描述的狀態投影成 pixel-aligned controls,最後才交給影片模型渲染畫面。

這個框架真正解決的問題,是讓世界「可被編程」。同一份世界狀態可以驅動任意鏡頭、任意視覺風格,角色即使離開畫面依然存在,事件具備不可逆性,亦可由規則觸發;使用者可以用類似 WASD 的方式操控,並預先以語言定義世界規則。一個 VLM-based agent 會讀取參考圖與開放式文字,自動寫出可執行的世界規格。

PWM 屬於框架類項目,定位接近研究原型。與 Genie 3、GameNGen 等同類做法相比,PWM 的取捨在於放棄純端到端的潛在表達,換取可查詢、可驗證、可長時序的狀態;對於遊戲開發者、需要可控互動世界的模擬研究者,以及想用程式化方式生成可控影片內容的團隊,這種顯式狀態設計明顯更貼近「世界引擎」的真正需求。

目前 PWM 已釋出技術報告,推理程式碼與預訓練權重尚未開源,因此暫時只能從紙面層面理解並等待官方補上權重。從架構看,這個方向對於追求可控性與持久性的應用場景會有明顯吸引力。

重點摘要:

  • 狀態與畫面解耦:狀態由 executor 維護,畫面由影片模型渲染,互不綁定
  • 可查詢、可驗證的世界事實:角色、事件與鏡頭外實體都能被檢查與修改
  • 持久世界:鏡頭外的物件與潛在狀態不再被遺忘,長時序互動更可靠
  • VLM agent 自動生成世界規格:以參考圖加文字描述即可寫出可執行的世界規則
  • 尚待補完:推理程式碼與預訓練權重仍未釋出,目前以技術報告形式呈現

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 世界模型, Video, Image, 框架, 3D

Page 21 of 55
1 … 19 20 21 22 23 … 55