Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。
GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

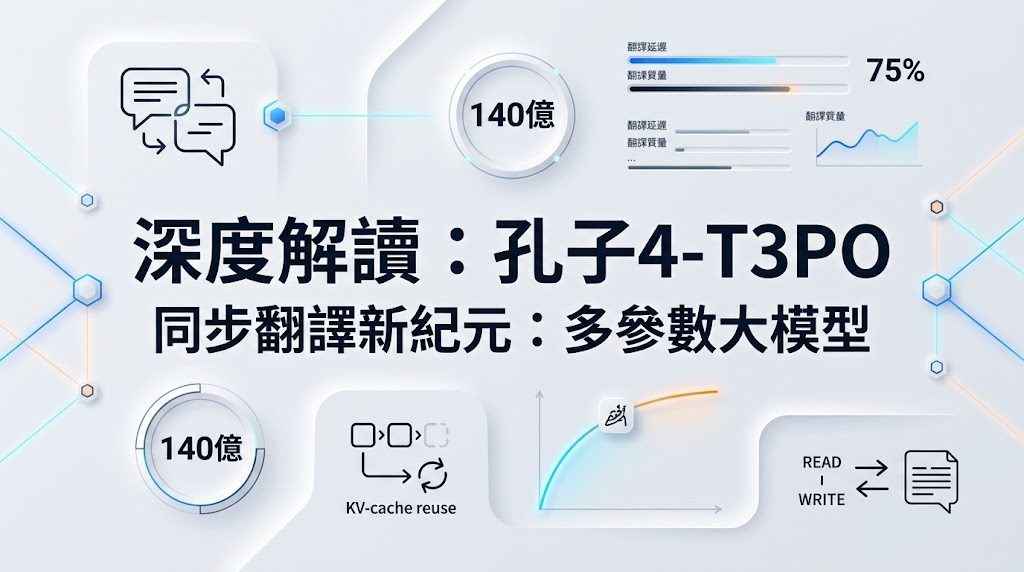
會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。

GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。

Og image

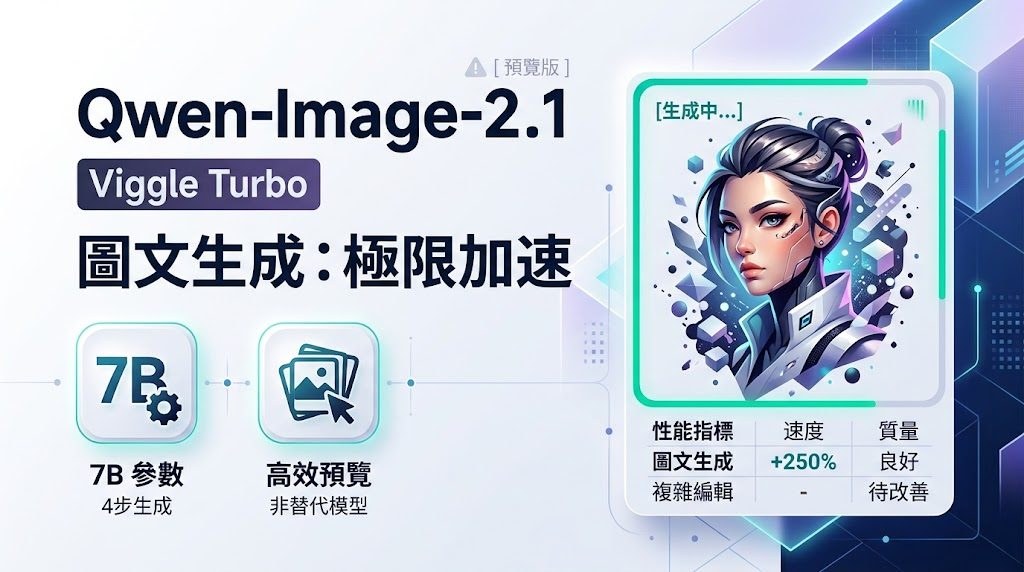
面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型

Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

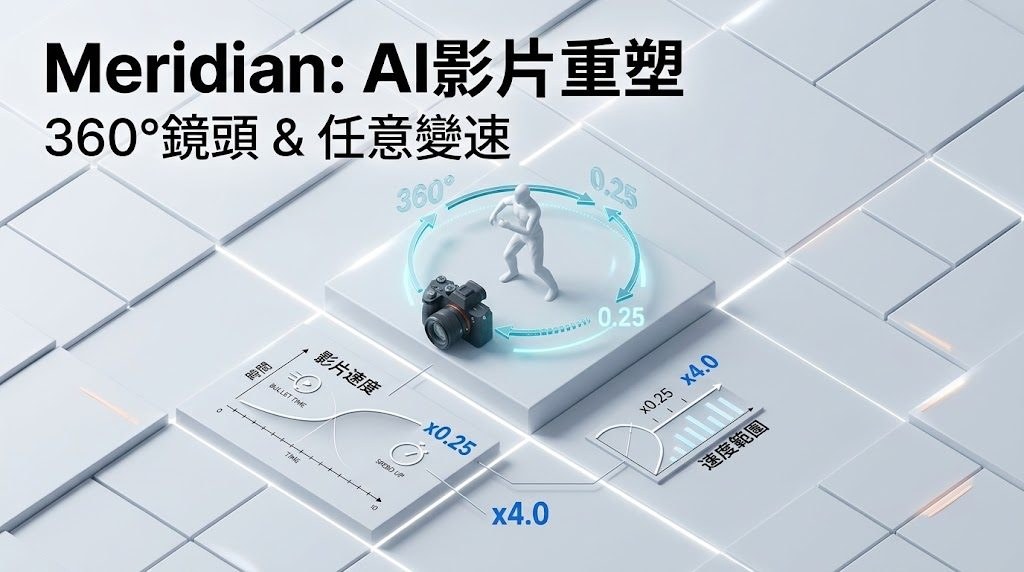
Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

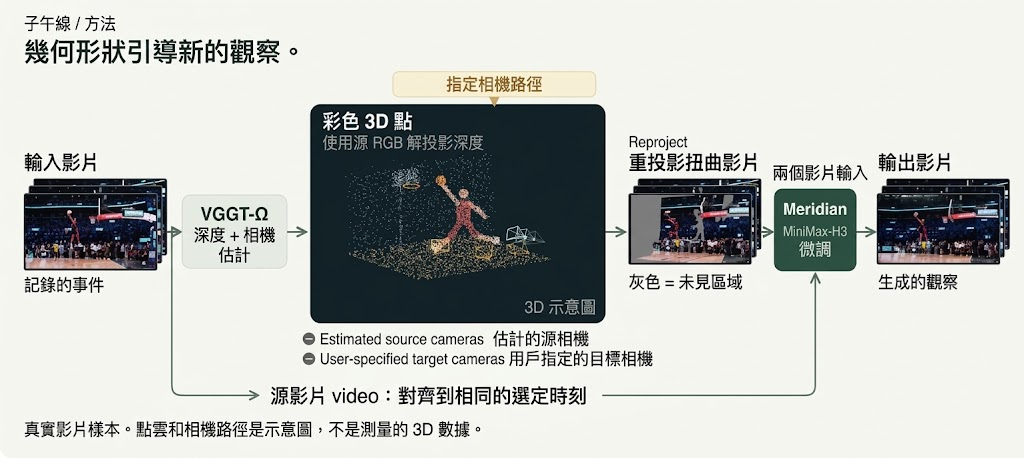
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

ImIR 免提示詞處理六類影像修復,

ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

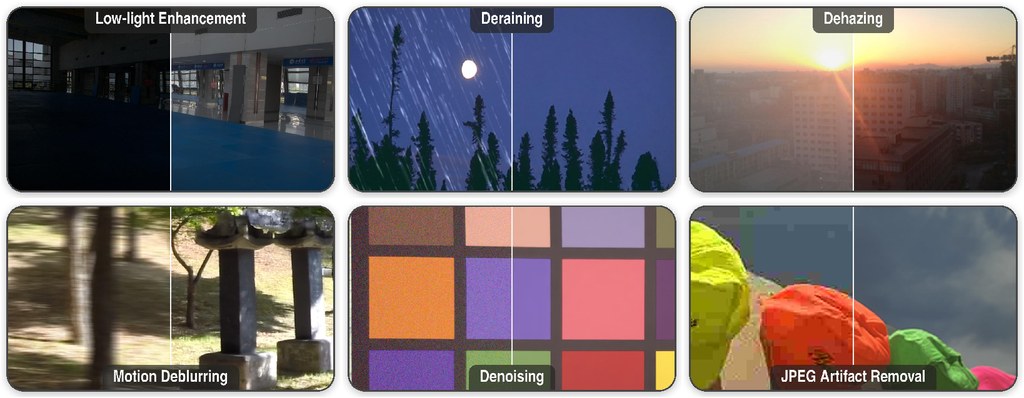
ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

RULER 讓 SVG 生成更貼近人類判斷的評分

生成SVG時,圖像看似相似,未必代表指令已經做到。RULER用逐項評分改善模型訓練,毋須配對的標準圖像或人工偏好標籤。

RULER-generated eye icon with eyelashes and a blue iris

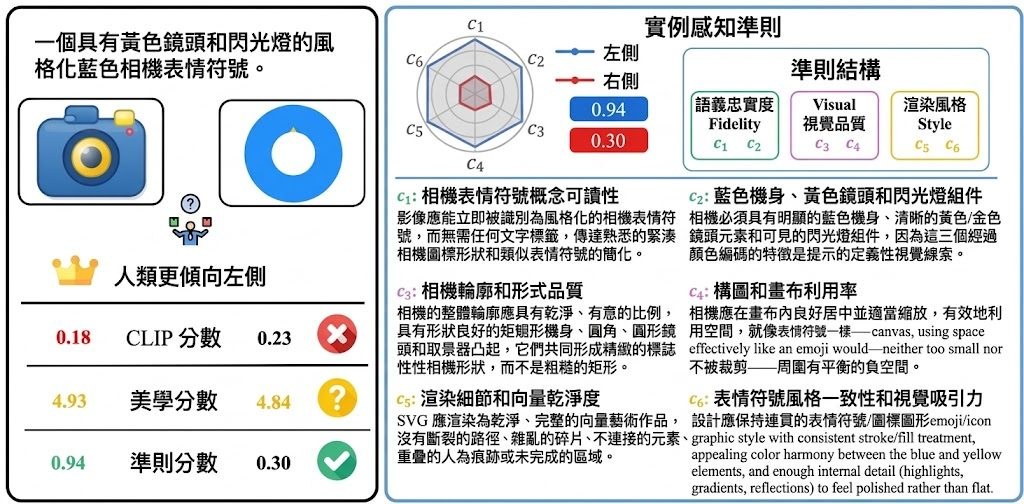
想把「畫一個指向東北的指南針」轉成SVG,模型要同時掌握主體、方向和風格;但這類開放式生成通常沒有唯一正確圖像,傳統分數未必能指出作品究竟錯在哪裏。RULER是一套用於SVG生成評估及強化學習訓練的方法,嘗試把籠統分數拆成可逐項檢查的要求。

它會只根據文字指令,為每個生成任務建立六項評分準則,涵蓋語意、視覺和風格,再由視覺語言模型評分渲染後的作品。各項得分按權重合成較細緻的獎勵,供 Group Relative Policy Optimization(GRPO)優化模型;整個流程不需要配對SVG標準答案或人工偏好標籤。

這種做法針對的是CLIP、Aesthetic等單一分數難以判斷SVG細節,也可能令強化學習模型迎合分數、產生 reward hacking 的問題。研究團隊表示,多軸評分比單一指標更貼近人類判斷;在MMSVG-Illustration和MMSVG-Icon上,rubric分數分別由0.432升至0.693,以及由0.395升至0.683,並超越專門SVG模型,表現可媲美規模大得多的DeepSeek-V3。

  • 每條指令會生成專屬評分準則,而非所有作品共用一把分數尺。
  • 評分同時檢查語意、視覺和風格,獎勵可用於GRPO訓練。
  • 不需要標準SVG圖像或人工偏好標籤,適合缺少標註資料的生成項目。
  • 評測結果顯示評分準則的設計是提升開放式SVG生成的重要因素。

項目主頁

Categories: 香港科技大學, Image, 提示詞, 香港

Calliope:由故事到成片 : ComfyUI 本地工作流

Calliope 將故事拆成劇本、鏡頭片段,再交由本機 ComfyUI 生成影片,兼顧創作流程與資料私隱。

Repository image for benjiyaya/Calliope

由一個故事構想開始,Calliope 會整理情節節拍、角色與場景,再按場景寫出貼近劇本的內容,拆成多個鏡頭片段交給 ComfyUI 生成影片。它屬於本地優先的 story-to-video 工具,處理的是文字創作與影片生成之間需要反覆整理、分鏡和合成的工作。

LLM 負責故事結構及逐場景腳本,ComfyUI 則按既有 workflow 和模型逐個產生片段,兩者分工清楚;完成後再由 ffmpeg 加入 crossfade、匹配音量並串成完整影片。項目資料放在 SQLite,媒體保存在本機資料夾,只有你指定的 LLM endpoint 可以是雲端服務,因此私隱程度和可控性較依賴本身的模型及 ComfyUI 配置。

Make AI Micro Dramas From Script to Video Locally Using Calliope 1.5

使用前需要 Python 3.11+、Node.js 18+、已安裝模型的 ComfyUI、OpenAI-compatible LLM endpoint,以及可從 PATH 呼叫的 ffmpeg。前端是 SvelteKit,後端採用 FastAPI;啟動兩者後,在 Settings 設定 LLM、ComfyUI URL 及可選的 agent 分工,亦可調整並行工作數、輪詢間隔和等待上限,長時間影片工作可把預設 30 分鐘 timeout 延長,或設為無限等待。

適合需要保留素材在本機的個人創作者、小型製作團隊,以及已經建立 ComfyUI workflow、想加入故事編排層的使用者。Dry-run 只會產生佔位結果,不能用來判斷真正的影片效果。

  • 流程完整:由故事、劇本、分鏡到片段合成集中處理
  • 本機優先:項目資料與媒體不必上載到雲端
  • 依賴明確:需要自行管理 ComfyUI、模型、LLM endpoint 和 ffmpeg
  • 可調整佇列:支援並行數、輪詢設定及長任務 timeout

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, API, Video, 工具, Content Creator, Python

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

OmniEdu 把課程理解帶進 AI

OmniEdu 不只回答題目,還會對照課程、診斷學習缺口,再決定下一步應給提示、提問或講解。

Repository image for haolpku/Omni-Edu

學生卡在一道題目時,答案本身未必足夠,真正需要的是知道漏了哪個前置概念,以及下一步應怎樣學。OmniEdu 屬於開源多模態模型家族,處理 K–12 學習與教學流程,將課程對應、解題、學習診斷和教學支援放在同一套模型內。

模型以 Qwen3.5-4B-Base、Qwen3.5-9B-Base 和 Qwen3.8-27B 為基礎,推出 4B、9B、27B 三個 checkpoint。訓練資料包括 69,999 個 instruction examples、15.96M supervised response tokens,當中 60,951 個屬教育專用資料,涵蓋超過 100 個來源;模型亦支援圖片等多模態輸入,能把問題、知識點、年級、先修關係和課程證據連繫起來。

可下載的權重和資料集適合教育研究團隊、教材平台,以及需要本地模型作學習分析的開發者;4B 較適合本地試驗,9B 和 27B 則提供更高能力但需要更多硬件資源。模型可透過 Transformers 或 vLLM 執行,公開配置使用 Qwen3_5ForConditionalGeneration,訓練序列長度為 32,768 tokens。

  • OmniEdu-27B 在 16 個模型比較中,取得 K12-Bench EM 63.12% 和 F1 76.69%,兩項均列第一。
  • OmniEdu-27B 在 MathFish 達 85.89% 準確率,並取得 LongTutor 3.02 教學分數。
  • EDUMATH MaC 為 86.95%,MathTutorBench Scaffold win rate 為 78.74%,兩項均列第二。
  • 模型的差異不只在答對題目,而是嘗試判斷誤解、缺失的先修知識,再選擇提示、引導問題、複習或解釋。

OmniEdu 的取捨也很直接:全參數 supervised fine-tuning 和長序列訓練有助整合教育情境,但 27B checkpoint 對硬件要求較高,模型的教學判斷亦應配合教師審核。對只需要一般問答的工作流程,它可能過於專門;對重視課程對齊和個別學習支援的團隊,公開權重與資料集則提供了可檢查、可延伸的起點。

項目主頁 · GitHub

Categories: 開源, 北京大學, 模型, 多模態模型, 模型訓練, Image, 教學, Dataset 數據集

VideoGen-Agent 讓影片生成懂得規劃、驗證與修正

影片生成不再只靠一次輸出,VideoGen-Agent會分步使用工具,檢查結果後再修正畫面與內容。

VideoGen-Agent logo

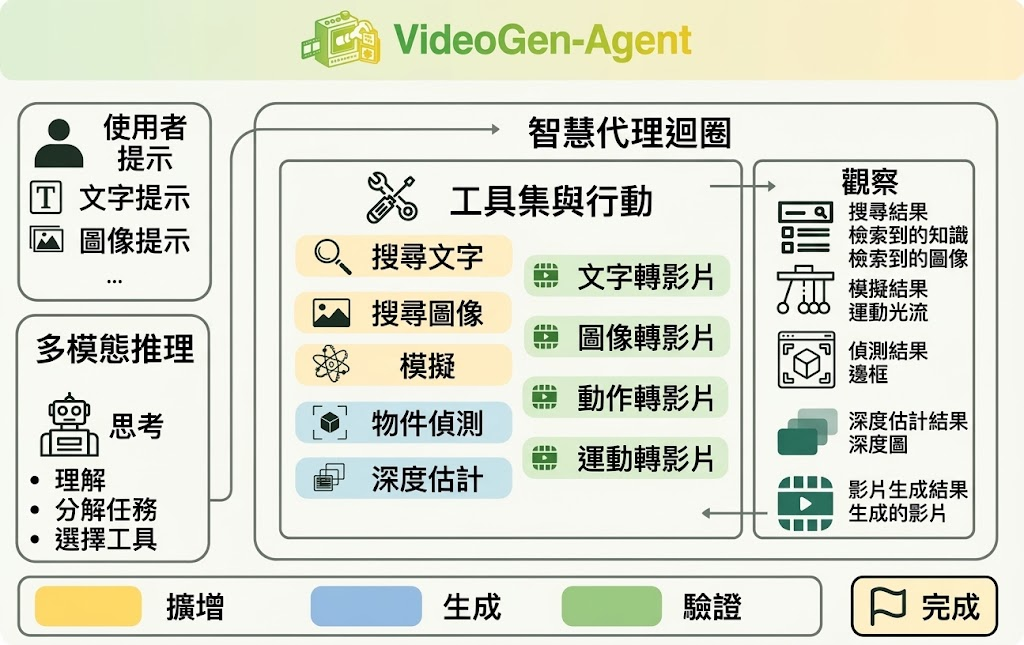
面對需要維持人物身份、物理關係、場景構圖或事件次序的提示詞,一次生成往往難以兼顧所有要求。VideoGen-Agent以多模態代理配合強化學習,讓影片生成流程加入規劃、工具操作和視覺驗證,逐步處理這些容易出錯的部分。

代理會在多輪互動中協調 augmentation、generation 和 verification 工具,根據提示詞及中途觀察結果決定下一步行動。訓練先以教師生成的工具使用軌跡建立基本行為,再透過 multitask agentic reinforcement learning 改善工具選擇和生成品質,並以混合獎勵同時評估工具呼叫有效性、任務配合程度及影片效果。

VABench 包含600個提示詞,涵蓋程序知識、單一及多個實體的身份保持、物理一致性、場景構圖和多鏡頭時間結構。以 Seedance 1.0 T2V 作為基礎生成器時,VideoGen-Agent分數由56.5提升至75.6;推理時換用 Toolset 2,即使不重新訓練代理,分數仍升至86.1,人類評審在雙選比較中有84.3%偏好升級後的配置。

• 以多步驟代理流程取代單次影片生成
• 結合 augmentation、generation 和 verification 工具
• 針對身份、物理一致性及事件順序等難題作出驗證
• VABench涵蓋600個多類型提示詞
• 程式碼及資料集當時仍標示為即將推出

這種做法較適合需要精準遵循複雜提示詞的影片創作、研究評測及工具驅動工作流。它仍依賴可用的生成與驗證工具,代理表現亦會受基礎模型、工具能力和評估方式影響,不能把分數提升直接視為所有影片場景都能獲得相同效果。

項目主頁

Categories: 香港中文大學, Agentic, AI productions, Video, 提示詞

Page 17 of 55
1 … 15 16 17 18 19 … 55