MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

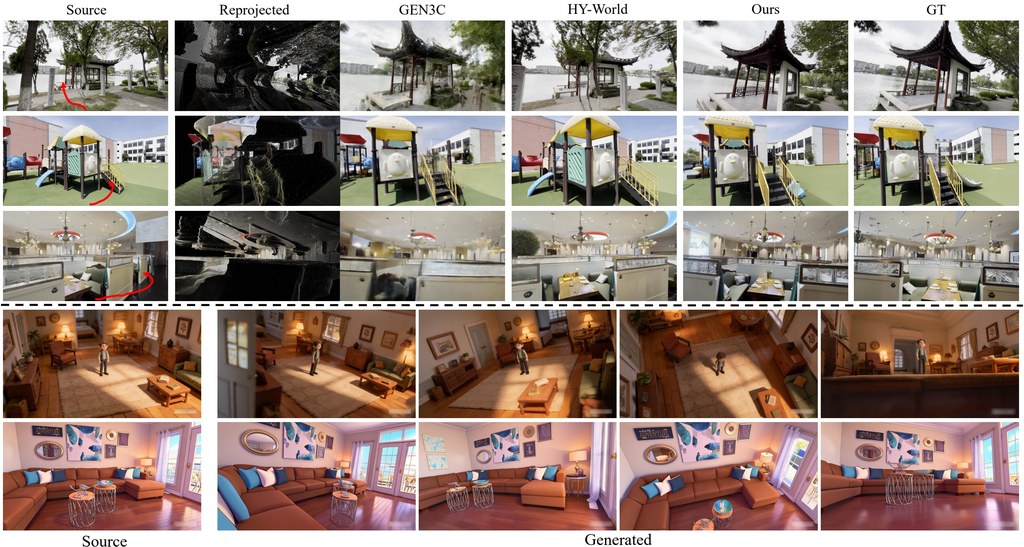
單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。
項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

RINO 用圖像編輯統一視覺任務

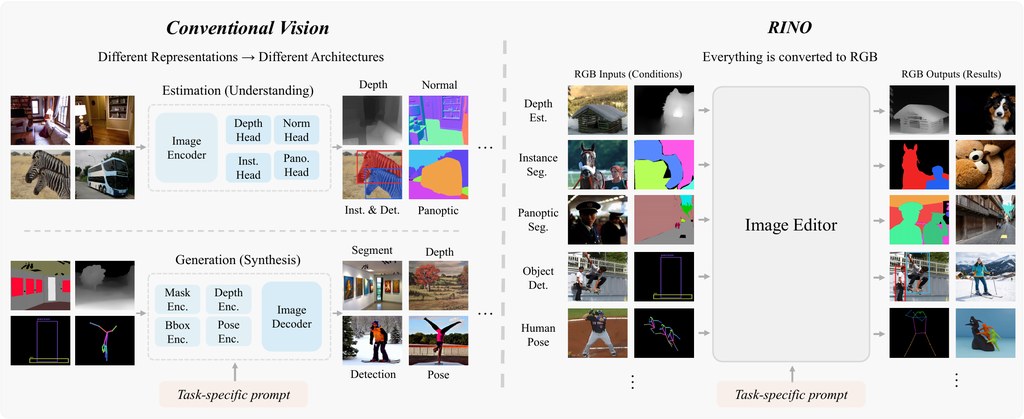
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

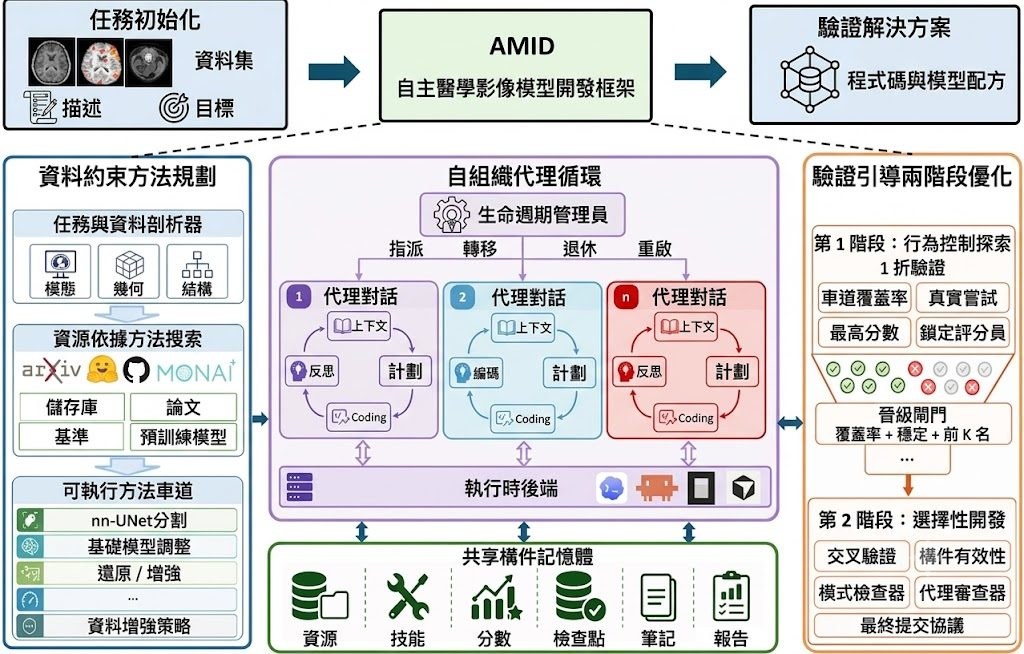
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

reasoning-blind-spots:找出 AI 推理盲點的測試集

blind-spots-bench 把看似簡單的題目變成壓力測試,幫你看清前沿模型在哪些推理步驟容易失手。

front page new

最值得留意的矛盾,是題目對人類不算難,卻會令前沿模型露出推理短板;blind-spots-bench 屬於基準測試與資料集項目,用來檢查 AI 在抽象、文字及多模態推理題上的失誤位置。

很多模型評測偏向看總分或通用能力,這個項目把焦點放在「盲點」:模型可能懂得生成流暢答案,卻在追蹤規則、連鎖映射或跨模態線索時走錯一步。資料集已放在 Hugging Face,格式包括 parquet,規模少於 1K,較適合做針對性壓測,而不是當成大規模訓練資料。

  • 定位清楚:針對 frontier AI models 的 reasoning capabilities 做壓力測試。
  • 工作流完整:以 Inspect AI 作為 evaluation framework,並提供 scripts 重現評測。
  • 可檢查答案:grader.py 負責 Scorer/Grader/Verifier logic,solver.py 處理 Solver/Generator logic。
  • 覆蓋形式:資料包含 Image 與 Text,題型可分為 Text-only 與 Multi-to-text。

安裝與部署層面,這不像一般應用工具按幾個掣便完成任務;較合理的理解是把它接入評測流程,透過 conf/ 的 Hydra 設定、scripts/ 的重現腳本,以及 notebooks/ 的分析視覺化,對模型輸出做批量測試與比較。

結果表列出 mean@4、pass@4、out-tks 與 cost ($/100) 等指標,並可見 GLM-4.7、GLM-5、GLM-5.1、GLM-5.2 等相關模型。它較適合模型研發團隊、評測工程師、AI 產品團隊用來補足一般 benchmark 看不到的錯誤模式;若只想找聊天機械人的日常排行榜,這個項目的粒度會顯得更偏研究與診斷。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, OpenAI, Image, 框架, Dataset 數據集

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

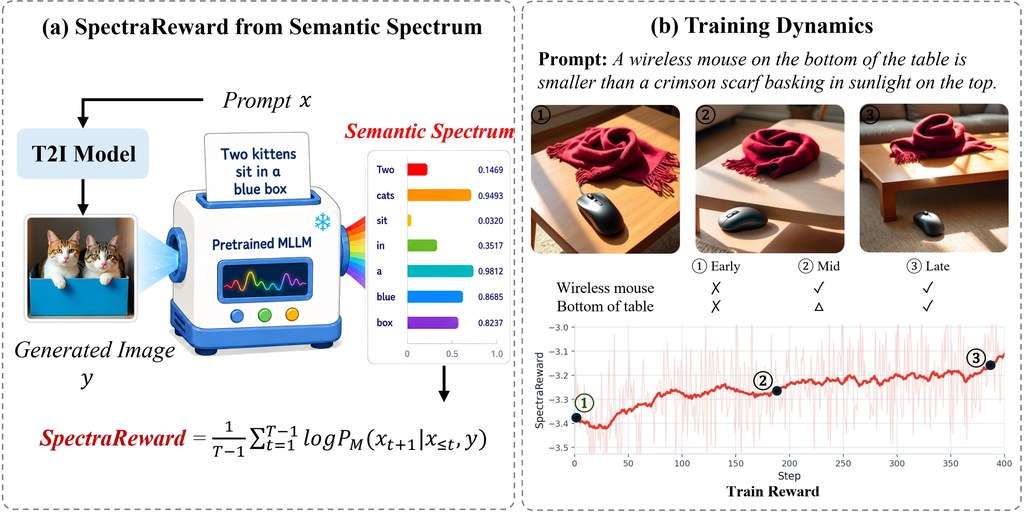
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

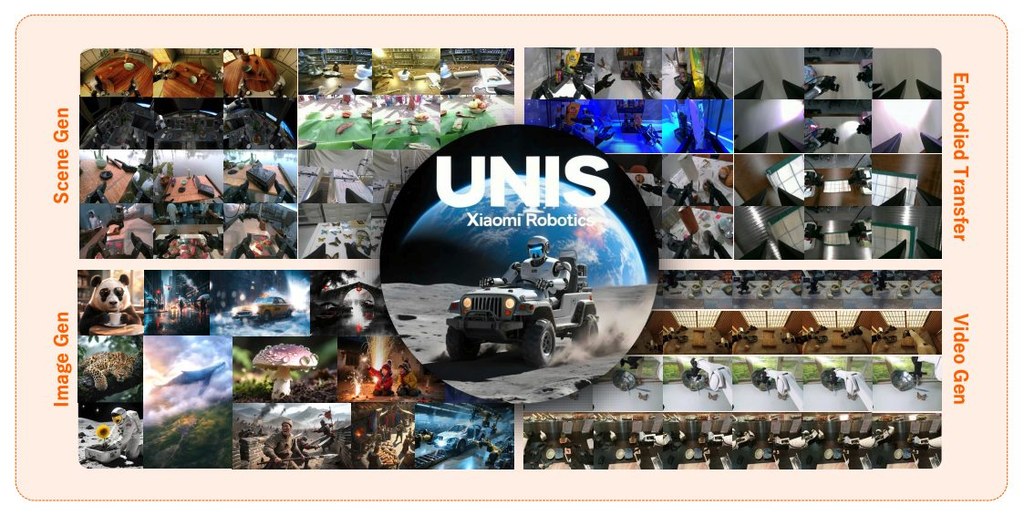
常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。

呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

Latent-Identity Tuning 人像身份細緻微調

人像生成最怕改少少就變成另一個人。Latent-Identity Tuning 嘗試把臉部特徵拆得更細,令同一身份可在不同提示詞下保持一致。

teaser site

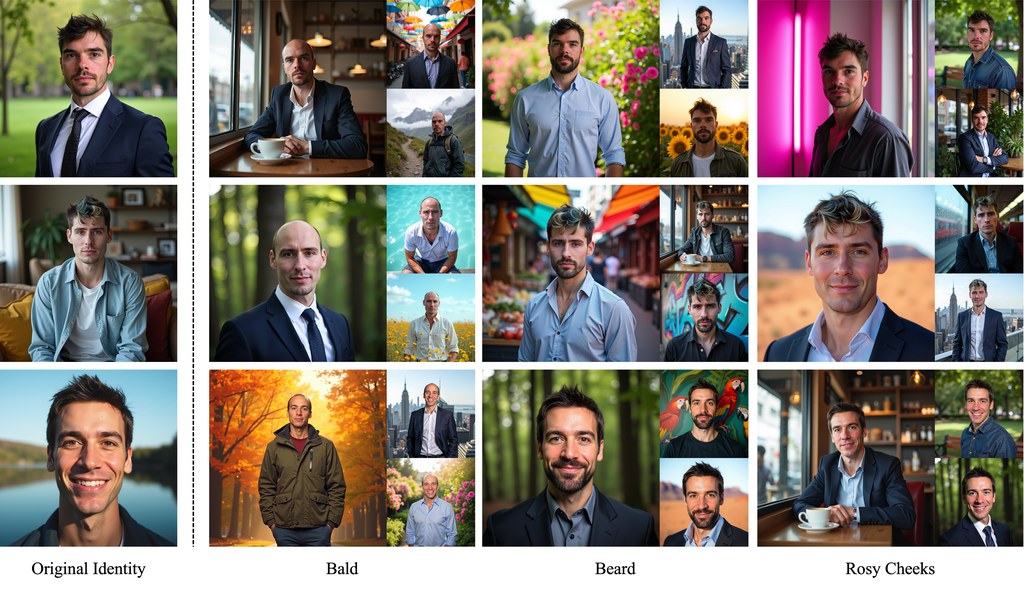
想修改鼻形、加鬍鬚或雀斑,同時又保留同一個人的辨識度,對 text-to-image (T2I) 個人化生成來說一直很難。Latent-Identity Tuning in Text-to-Image Personalization Models 聚焦在這個卡位:不只是改一張圖,而是調整某個人的身份表示,之後可在不同場景中生成同一個經過微調的人。

做法上,輸入人像會先經由預訓練 personalization encoder 轉成一組 identity tokens。研究發現,不同 token 會偏向捕捉眼、鼻、口、頭髮等不同區域或語義特徵,因此可以在這個 identity space 入面尋找有意思的方向,例如鬍鬚、捲髮或其他面部屬性,再沿着方向調整。

  • 直接微調 identity tokens,而不是只在單張圖片上修圖
  • 可做局部、細緻,而且語義較一致的人臉改動
  • 修改後的身份可配合不同 prompts 生成新圖
  • 透過 attention maps 觀察 token 與臉部區域的關係
  • 使用定性與定量實驗檢查局部編輯及跨圖身份一致性

和常見 image editing 相比,這個方法的差異在於它處理的是「身份的潛在表示」。換言之,改動不是鎖死在原圖姿勢、背景或光線,而是把編輯後的身份交給 T2I 模型,在新場景、新描述下仍盡量維持同一個人。

這類方法會較適合需要穩定角色形象的創作者、視覺設計工作流,以及研究人像個人化生成的人。限制上,資料未交代可直接使用的產品化介面或完整模型名單;引用模型方面,內容只提到預訓練 personalization encoder 與 text-to-image model,未列明具體基礎模型名稱。

項目主頁 · Paper

Categories: 數字人, Image, txt2img, 框架

CtrlVTON 把虛擬試穿變成可控編輯

想像網購試衫唔只係換件衫上身,連鬆身、束入褲頭同疊穿位置都可以指定。CtrlVTON瞄準的,正正是這種以往 VTO 很難處理的控制感。

NXN LABS

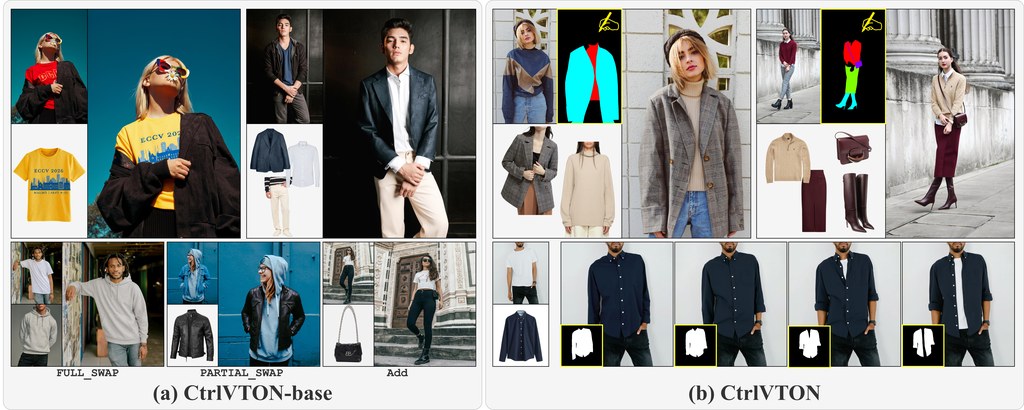
網購試衫最常見的落差,不是像不像,而是你根本無法指定件衫要點樣著。CtrlVTON 屬於影像生成與虛擬試穿項目,處理的是 Virtual try-on (VTO) 長期欠缺的可控性:同一件衫可以鬆身或貼身、束入或放出、打開或扣上,甚至改變穿著位置與疊穿方式。

現有做法多數把 VTO 當成 inpainting 問題,擅長補畫衣物,卻不容易精準跟住使用者指定的版型同位置。CtrlVTON 改用 image editing framing,再配合 segmentation mask 做 pixel-level control,重點不是單純生成得自然,而是令版面安排真正聽話。論文亦明確指出,它在服裝忠實度接近強勢 proprietary editing systems 的同時,對使用者提供的布局跟隨得更準。

支撐這套方法的另一半,是 Visual-Instance-Prompt Segmentation 與對應模型 VIP-SAM。以往常見的是 category-level visual-reference segmentation,但作者針對的是 instance-level 任務:先給你一張平拍服裝圖,再從人物穿著照片中分出同一件衣物。這一步對同類衣物干擾、遮擋,以及布料變形都更敏感,所以 VIP-SAM 會把 support features 提早注入 SAM backbone,目標是令定位更穩。

  • 把 VTO 由 inpainting 轉成 image editing,控制粒度更細
  • 用 segmentation masks 指定服裝大小、風格與身體上的位置
  • VIP-SAM 先解決「相中究竟係邊一件衫」的 instance-level 分割問題
  • 一個框架內處理 garment swapping、layering、selective switching、multi-garment composition
  • 已公開 VITON-HD-edit dataset,並有 arXiv 論文可交叉核對方法與結果

理解這個項目的較合理方式,不是把它當成即裝即用成品,而是研究型原型加資料集組合。,測試與部署會圍繞論文、GitHub 儲存庫,以及 Hugging Face 上的 VITON-HD-edit dataset 展開;較適合做可控試穿研究、電商影像流程驗證,或想比較 LoRA 式輕量微調能否取代大型封閉編輯服務的團隊。限制也很清楚:Project Page 尚未公開,README 釋出的安裝與推理細節仍不完整,現階段更適合有影像模型基礎的人先跟論文設定重現,再評估能否接入產品流程。

GitHub · Paper

Categories: 開源, Image, 影像模型, 影像處理, Dataset 數據集

ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

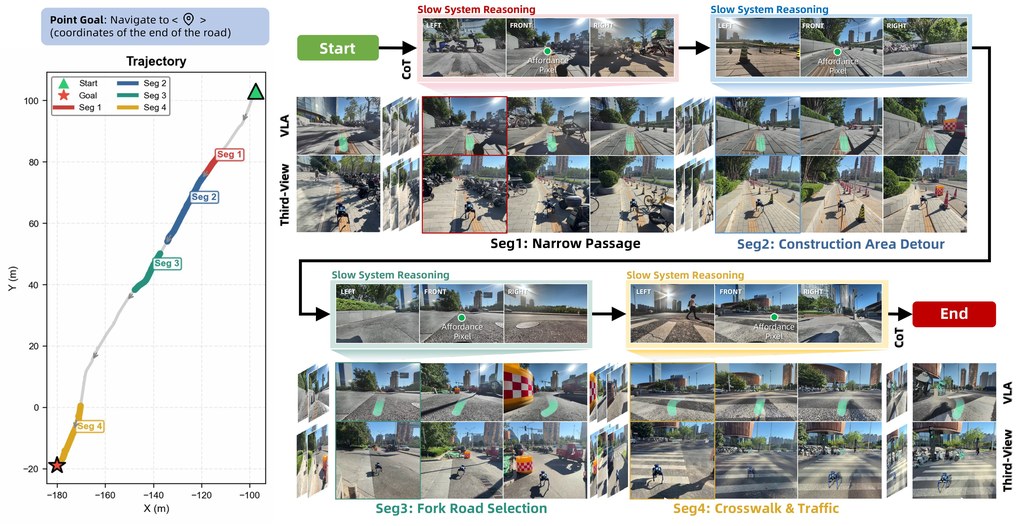
做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。

項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

MedPMC 把醫學圖文資料做成可訓練基座

想做醫學影像與文字理解,卡位通常唔係模型,而係乾淨又夠大的圖文配對。MedPMC 把這件事連同訓練流程一併開放,方向相當務實。

Repository image for Yale-BIDS-Chen-Lab/MedPMC

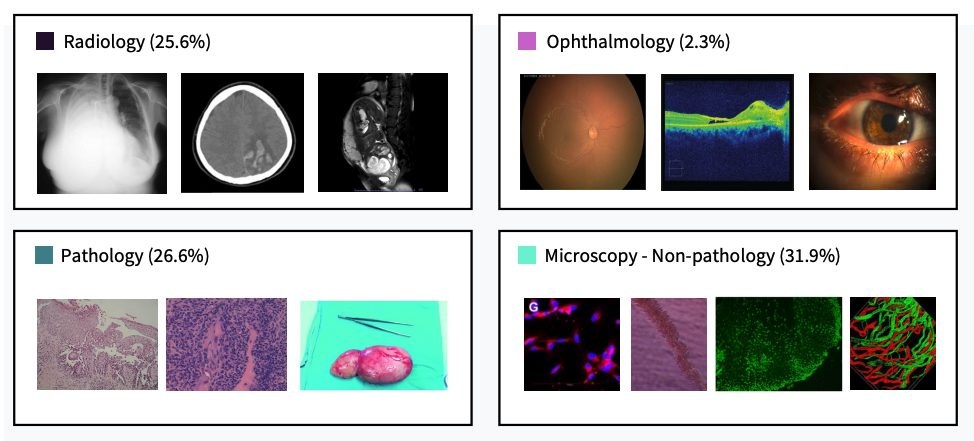
做醫學多模態模型,最難往往不是再堆一個新架構,而是先整理到可用的圖文資料。MedPMC 屬於Dataset 數據集加模型訓練程式碼項目,核心價值是把 PubMed Central (PMC) 文獻中的醫學圖片與文字抽取、清理,再接上訓練與評估流程,處理的是醫學 vision-language 資源長期分散、難重現的問題。

目前最值得留意的是 MedPMC Dataset 首個版本,提供約 1,100 萬組 medical image-text pairs;同時亦有基於 MedPMC-11M 訓練的 MedPMC-CLIP。這種做法與不少只放模型權重、或只交出資料連結的項目不同,它把 dataset curation、preprocessing、model training、evaluation 放在同一個代碼庫,較適合研究團隊沿住同一條流程再做微調或重跑實驗。

部署與測試的理解方式很直接:資料集與模型都已放到 Hugging Face,現階段較像給研究者先下載資料、檢查抽樣品質、再接入自家訓練管線。README 未提供很完整的操作文件,dataset viewer 亦未必可直接預覽,所以短期內它比較偏向有 Python 與資料處理能力的團隊,而不是即開即用的線上服務。

  • 約 1,100 萬組來自 PMC 的醫學圖文配對,是項目現時最重要資產
  • 連同 MedPMC-CLIP 一併釋出,方便由資料走到模型驗證
  • 重點不在花巧介面,而在可重現的資料整理與訓練流程
  • 文件仍在補完中,benchmarks 與更多 training recipes 尚待發布

以現有資訊看,MedPMC 的強項是規模與研究流程整合,限制則是文件與基準結果仍未齊備,暫時較難單靠公開頁面判斷模型表現上限。對醫學 AI、視覺模型、RAG 前處理,或需要建立醫學圖文檢索基座的團隊來說,這個開源項目已有不錯參考價值;相關模型現時可確認的是 MedPMC-CLIP

項目主頁 · GitHub · 模型

Categories: 開源, RAG, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Image, Medical醫學, Python, Dataset 數據集

Page 9 of 16
1 7 8 9 10 11 16