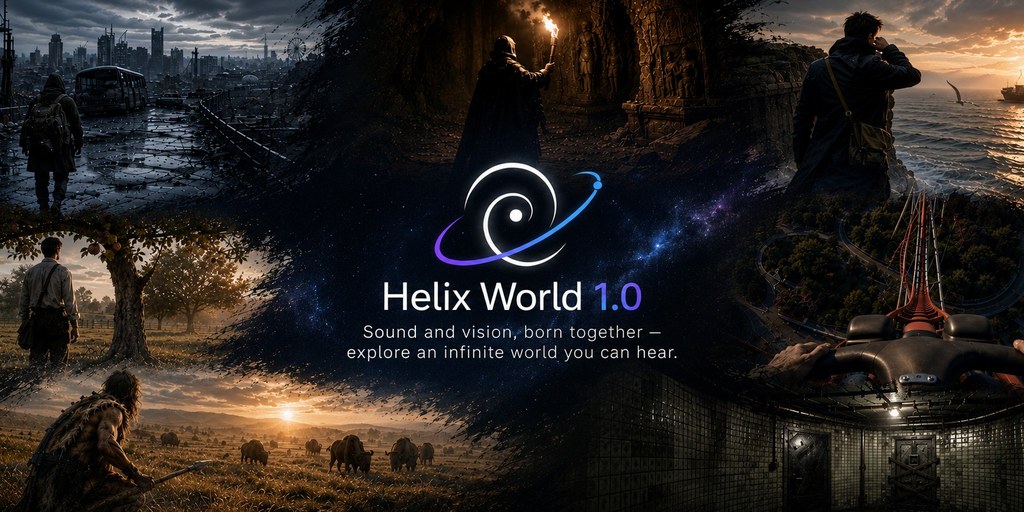
HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

GTR 以循環架構壓低高解像度視覺推理成本

GTR 以無 softmax 的循環式視覺骨幹處理多種密集預測,在速度與精度之間尋找更實用的平衡。

teaser

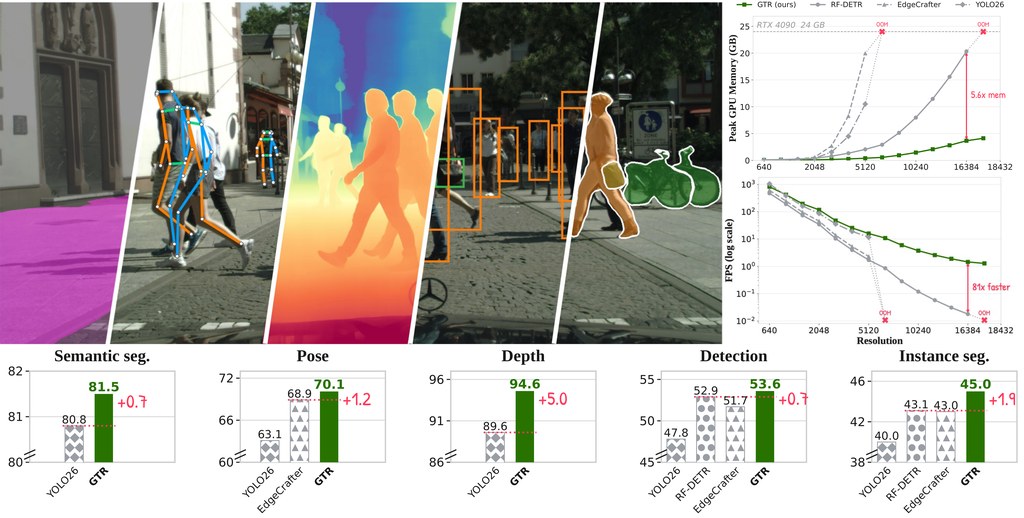
高解像度影像令全域 softmax attention 的計算量隨 token 數量平方增加,GTR 以無 softmax 的循環式視覺骨幹處理這個瓶頸,支援物件偵測、分割、姿態、深度及定向偵測。它屬於視覺模型,實際解決同一組影像特徵如何兼顧多種密集預測任務與推理速度。

GTR 由 12 層 Gated Linear Attention(GLA)組成,每層輪換二維掃描方向,再配合加入 3×3 depthwise convolution 的 Spatial SwiGLU,補足鄰近 patch token 的局部資訊。模型以 stride-16 單尺度特徵圖運作,並透過輕量三尺度 projector 和 query-based head 輸出不同任務所需結果。

  • 以單次平方 L2 loss,將學生模型最終 patch token 對齊 detection-specialized DINOv3 teacher
  • 同一個 GTR backbone 支援六類密集預測任務
  • RTX 4090、FP16、batch 1 下,GTR-L 達到 58.9 COCO box AP,median forward pass 為 1.908 ms
  • 提供 chunkwise CUDA operator,亦支援 TensorRT 部署到 DRIVE AGX Thor

倉庫包含環境準備、資料處理、訓練、評估、推理及 TensorRT 部署流程,適合研究高效視覺骨幹、車載感知或需要多任務共用模型的團隊。代價是 CUDA 專用算子及編譯流程提高了硬件依賴;官方延遲數字來自 RTX 4090 或 DRIVE AGX Thor 的特定設定,換用其他裝置時仍需重新量度。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 香港, 庫

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

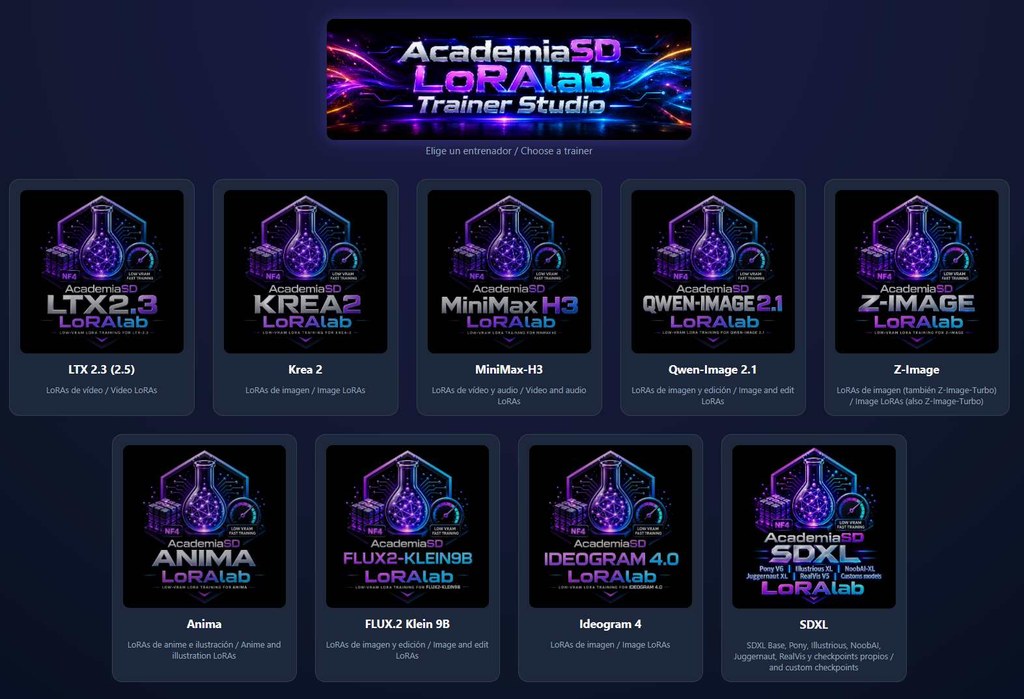
AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

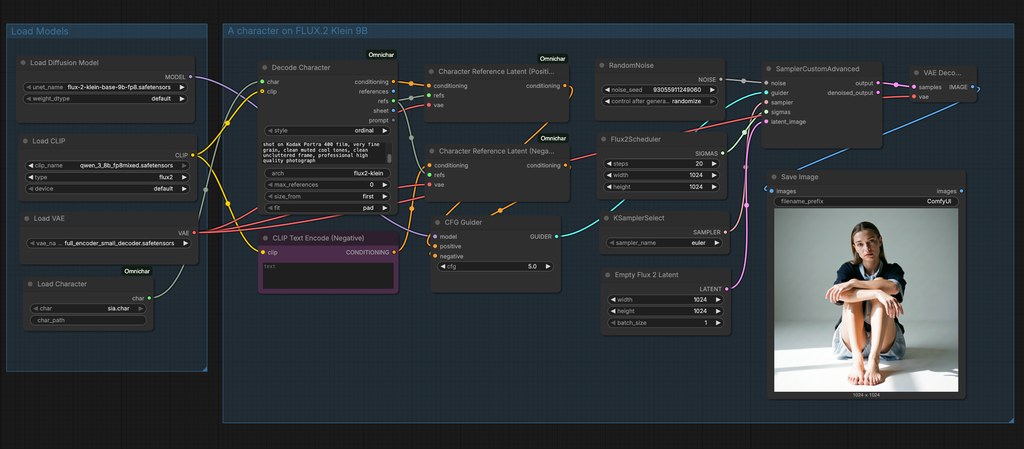
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

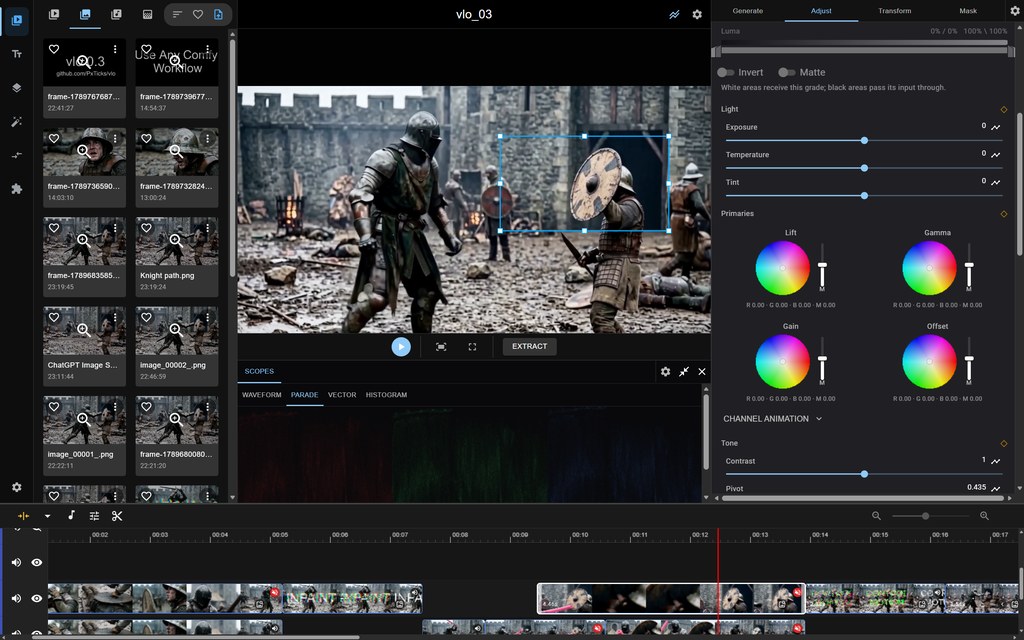
想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

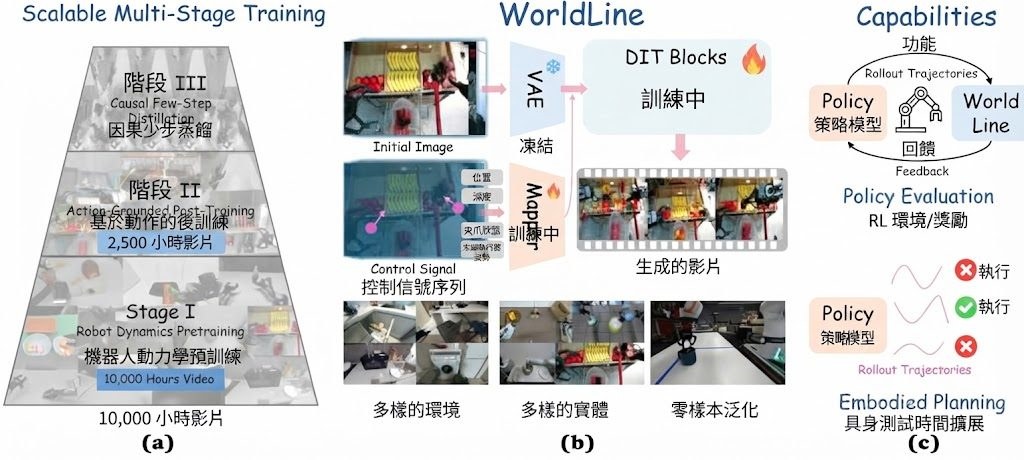
WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

Page 10 of 28
1 … 8 9 10 11 12 … 28