BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

DreamX-World:可互動世界模型

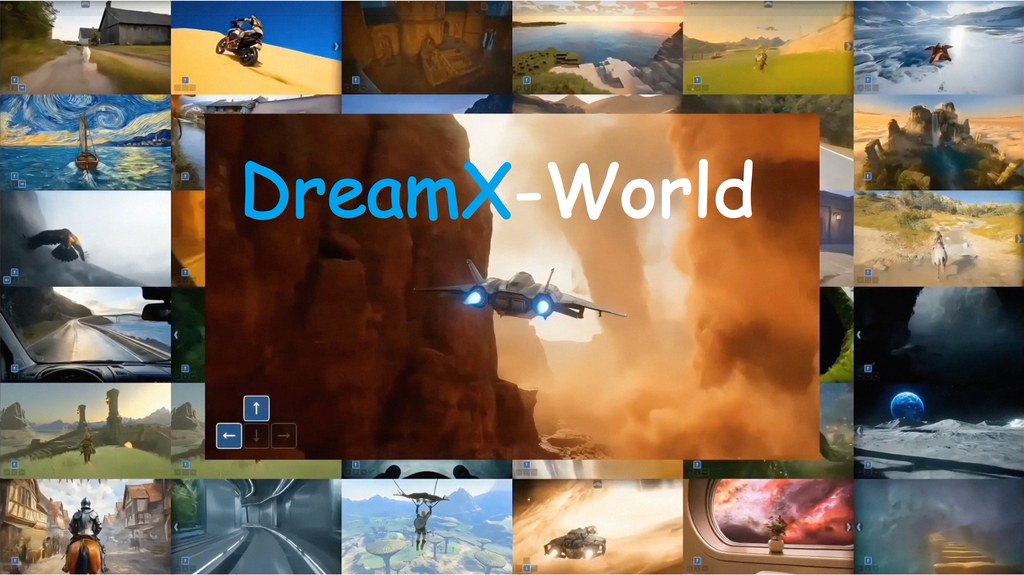
DreamX-World 想把影片生成推前一步,變成可控制、可探索的互動世界。重點不只畫質,還包括鏡頭一致性與長時段連續性。

dreamx world teaser fig

現時不少影片生成模型偏向做短片段合成,畫面可以靚,但一旦要控制鏡頭移動、返回之前看過的位置,或者在同一場景加入事件,往往會出現場景斷裂、風格飄移、前後不一致。DreamX-World 針對的正是這種固定範式的限制,把重點由「生成一段片」改成「維持一個可互動世界」。

這個項目屬於世界模型兼影片生成模型,目標是處理 interactive world simulation,讓文字或圖像驅動的影片不只會動,還能按事件提示改變場景。技術報告提到它支援 camera navigation、重訪已觀察區域,以及 compositional events,亦即多個事件可串連成多步世界變化,這比一般一次性生成更接近遊戲或模擬系統。

它的做法有幾個較鮮明的改動:先用 Unreal Engine 數據、gameplay footage 與 real-world videos 建立資料引擎,再加入 camera estimation 與嚴格過濾;之後用 E-PRoPE、causal forcing、DMD-style distillation、long-rollout training、Memory-Conditioned Scene Persistence 等方法,處理長時段生成常見的記憶斷層與色調漂移。報告亦指出,DreamX-World 1.0 在 5-second basic evaluation 拿到 84.76 overall score、73.75 camera-control score,整體分數高於 HY-WorldPlay 1.5 與 LingBot-World。

如果你想試這個項目,較合理的切入點是先看 DreamX-World-5B-Cam,因為它已公開模型與推理程式,主打 5 秒影片生成;想看長時段能力,就留意 Long-horizon DreamX-World-5B。它較適合研究 world model、互動影片、遊戲 AI 內容生成,或者想比較 autoregressive 與 bidirectional 路線差異的人。

  • 已公開相關模型包括 DreamX-World-5B-Cam 與 DreamX-World-5B
  • 5B-Cam 偏向短片與鏡頭控制,5B 則支援較長時段生成
  • 核心賣點是場景持續性、鏡頭控制與事件組合,不只追求單段畫質
  • 報告提到最高可達 16FPS(八張 RTX5090),反映它有考慮推理效率

整體來看,DreamX-World 的價值不在於再做一個普通 text/image-to-video 模型,而是把「可回看、可操作、可改變」放進同一個生成系統。現階段公開內容仍以模型與技術報告為主,但方法論已相當清楚,對世界模型這條路有明確野心。

GitHub: https://github.com/AMAP-ML/DreamX-World

Paper: https://arxiv.org/pdf/2606.16993

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Video, Image

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

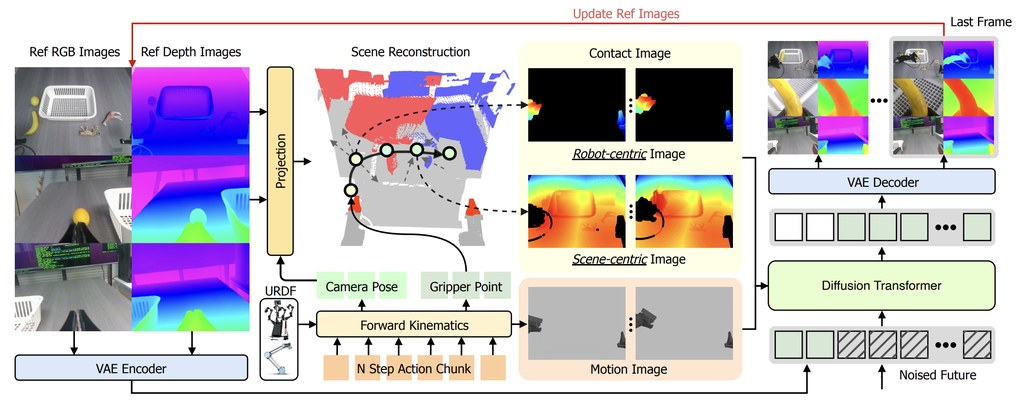
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, 庫, 編程, Win

elframe 簡易提取影片任何幀

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。 ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。

ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

本免費功能為本站測試 OpenSpec 開發成果
Categories: Image, 影像處理, 線上服務


PromeAI – 令草圖轉為逼真的照片或高質影片

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

【零門檻】1個AI工具,解放設計❗️|建築設計/室內設計/電商設計/遊戲設計|AI TOOLS FOR DESIGNERS
Categories: Video, Image, 線上服務


Page 27 of 28
1 … 25 26 27 28