dots.tts:支持廣東話的連續式語音合成

dots.tts 係一個 2B 參數 TTS 項目,主打直接由文字生成自然語音。它同時強調聲線模仿、情感表達同多語言表現。

dots.tts

dots.tts 是一個文字轉語音(Text-to-Speech, TTS)模型,主要用來將輸入文字轉成自然語音,並兼顧聲線模仿同情緒表達。它採用全連續、端到端的自回歸(Autoregressive, AR)設計,整條流程都唔用離散 token,這點同不少傳統 TTS 做法有明顯分別。

項目提供本地模型目錄或 Hugging Face repo id 載入方式,亦有 CLI、Python API 同 Gradio 網頁示範可試。用 --prompt-audio 配合 --prompt-text 可以做延續式 cloning;只給 --prompt-audio 時則走 x-vector-only cloning;而 --language 可幫多語言或 code-switching 文字鎖定語言標籤。

这开源TTS 太狠了:3 秒复刻音色+情绪迁移,还能实时朗读!

它的取向偏向高保真同穩定生成,而唔係只追求速度。官方數據顯示,dots.tts 在 Seed-TTS-Eval 取得較佳平均表現,zh / en / zh-hard 的 WER 分別係 0.94% / 1.30% / 6.60%,MiniMax multilingual benchmark 亦有 83.9 的平均 speaker similarity,反映它在聲音相似度同多語言能力上都有競爭力。

較適合做語音產品原型、配音流程、虛擬人聲、以及需要少量參考音去複製語氣嘅團隊。要留意參考音大約 10 秒較合適,而且 --prompt-text 必須同參考錄音內容一致,否則穩定性會下降。

  • 2B 參數、全連續 AR TTS,核心目標係文字轉自然語音
  • 支援 voice cloning、多語言同情感表達
  • 提供 CLI、Python API、Web Demo,方便測試同部署
  • 評測上在 Seed-TTS-Eval 同 MiniMax multilingual 都有強勢成績
  • 相關模型包括 dots.tts-base、dots.tts-soar、dots.tts-mf

GitHub: https://github.com/rednote-hilab/dots.tts

模型: https://huggingface.co/collections/rednote-hilab/dotstts
Categories: 開源, 文字轉語音, 模型, API, Audio, Clone, Python NLP, Python, 語音

MiniMax Hub:本機優先的多模態創作工作站

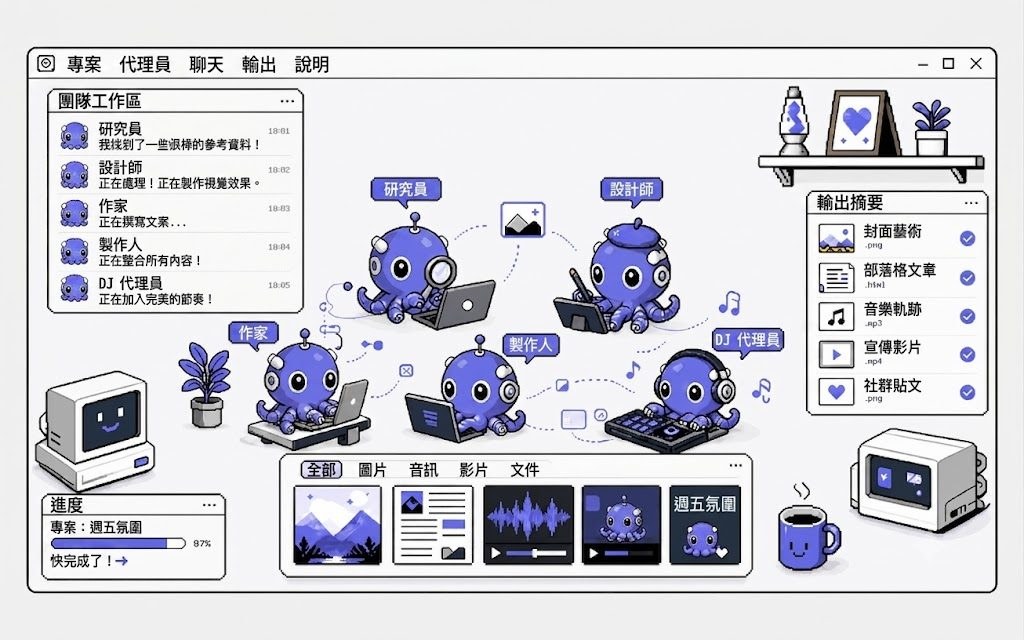
MiniMax Hub把文案、影像、影片與配音流程放進同一個創作畫布。重點是本機優先,素材可留在自己電腦。

MiniMax Hub

MiniMax Hub 是一個 Multimodal Creative Agent,定位像 AI 創作工作站,不只是聊天工具。它把 Copy Generation、Image Creation、Video Editing、Audio & Voiceover、Auto Packaging 與 Multi-format Export 整合在同一個流程,讓用家由想法到成片可在一處完成。

它支援 macOS 與 Windows 下載,輸入簡報、文字想法,或直接加入本機素材後,主代理會先理解創作目標,再做 Smart task decomposition,之後交由多個 agents 並行處理文案、視覺與音訊。用家仍可手動選模型,亦會在關鍵節點收到確認,避免流程完全黑箱。

這個項目在於把創作流程保存成可重用的 Skills。系統會隨工作過程累積你的做法與風格,之後可重複套用;如果需要,也可從 MiniMax Skills Market 啟用現成 Skills 或外掛。對經常製作短劇、電商內容、品牌 TVC 與廣告素材的團隊來說,這類流程重用能力相當實用。

  • 本機優先設計,頁面明確指出 local files stay on your machine
  • 單一畫布整合腳本、分鏡、影片、音樂與剪輯流程
  • 支援資產管理與 batch generation,可一次產出多個版本
  • 代理會自動分解任務,並在關鍵步驟要求人工確認
  • 可把工作流程沉澱成 Skills,逐步累積個人或團隊方法

MiniMax Hub較著重工作流編排與創作協作,而不是單一模型能力展示。網站未列出具體性能分數或公開評測結果,因此較適合把它理解為面向內容製作的本地化 AI 工具平台。文中未提供明確模型清單,只提到會自動匹配最合適模型。

項目: https://hub.minimax.io/

Categories: Agentic, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, Video, Image, Audio, 軟件, Mac, 語音, Win, 音樂, Skill 技能

Nemotron:NVIDIA 打造 Agentic AI 模型家族

Nemotron 不只是單一模型,而是一套面向 agentic AI 的開放模型與訓練資源。由邊緣裝置到資料中心,都有對應版本。

Watch the Nemotron Overview

Nemotron 是一個面向 agentic AI 的模型家族加開發資源項目,重點不是只放出權重,而是連 training recipes、deployment guides、資料準備與 use-case examples 一併提供,目標是縮短由研究到部署的距離。對想建立 AI agents 的團隊來說,這種整理方式比單獨下載模型更實用。

這個項目最實際的看法,是它把不同算力環境分得很清楚:Nano 針對 edge 和 PC,Super 主打單 GPU 高吞吐,Ultra 面向 multi-GPU datacenter applications。若你想先試概念,可由 Hugging Face 上的 Nemotron 模型開始,再按項目內的指引查看對應版本的訓練與部署資料。

創新點在於它不只講文字模型。Nemotron 3 Nano Omni 是 30B-A3B hybrid Mamba-Transformer MoE,原生支援 text、image、video、audio,定位為 agentic AI 的 multimodal perception sub-agent。這代表它較像多模態代理系統中的感知核心,而不只是一般聊天模型。

項目內容亦涵蓋 curate/、data prep/、sdg/ 和 translate/,即是連資料整理、Synthetic Data Generation (SDG) 與 corpus translation 都納入流程。這種由數據到模型再到部署的完整鏈條,對企業、研究團隊,以及想建立可重複流程的開發者尤其有吸引力。

  • 提供 Nemotron Nano、Super、Ultra 等級,對應不同硬件規模
  • 涵蓋 training recipes、deployment guides、資料處理與 SDG
  • Nemotron 3 Nano Omni 支援文字、影像、影片、音訊多模態輸入
  • 可配合 TensorRT-LLM 與 NIM microservices,部署彈性較高
  • 適合 agentic AI、Computer-use agents、企業內部 AI workflow 測試

如果你想找的是一個可直接抄答案的成品,Nemotron 未必是最快捷的選擇;但若你需要一套可追溯、可調整、可延伸的開放模型項目,它的結構相當完整。現有資料顯示它更偏向給認真做產品化或研究驗證的人使用,而不是單次玩票式體驗。

GitHub: https://github.com/NVIDIA-NeMo/Nemotron

Categories: Agentic, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, Anthropic, AGI

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

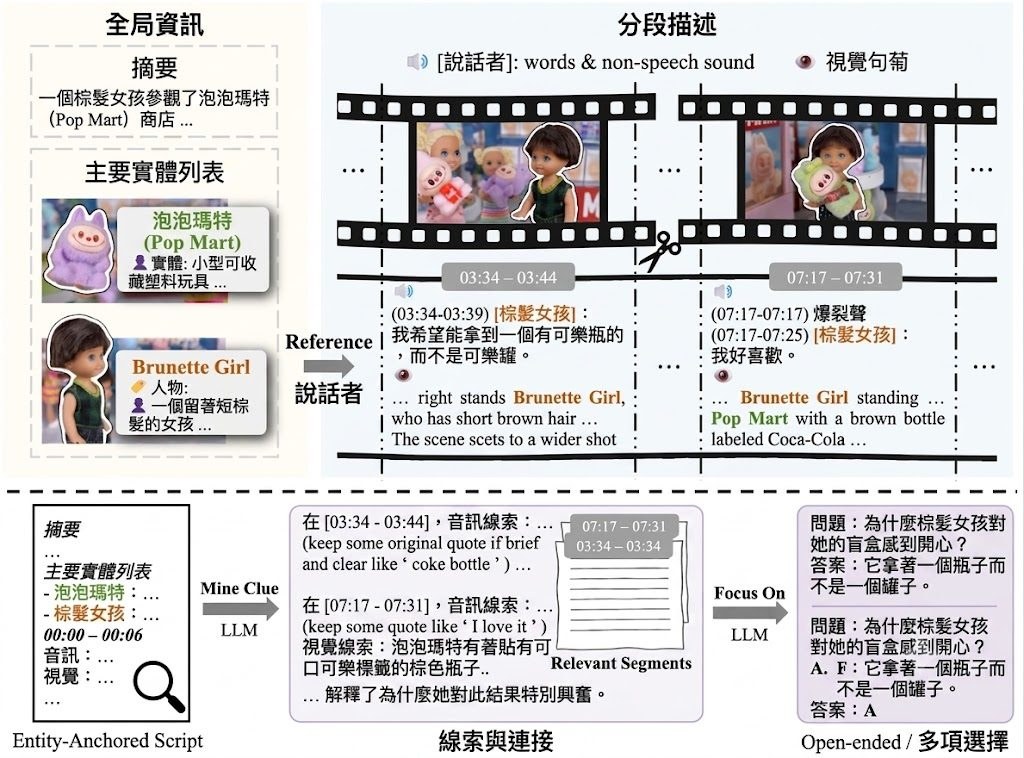
Framework Overview

現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, 庫, 語音, Dataset 數據集

MMAudio 自動配音效模型

Categories: 模型, Audio, 聲效

Hello2 – 高清 LipSync 工具

Categories: 模型, Video, Audio

LogicPro 11 -「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」
Categories: Audio

MVSEP – 自制 Karaoke 必備

新增了新版本的 BSRoformer 權重。目前它可能是世界上最好的可用模型。

新增了新版本的 BSRoformer 權重。目前它可能是世界上最好的可用模型。

Categories: Audio, 線上服務

RVC-Boss/GPT-SoVITS 語音合成模型

GPT-SoVITS 開源語音合成,支援 5 秒零樣本與 1 分鐘少樣本克隆,提升聲音相似度。支援中英日跨語言推理,提供 WebUI 工具及 Windows 預打包檔,方便快速建置語音模型。

功能:

  1. 零樣本文本到語音(TTS): 輸入5秒的聲音樣本,即刻體驗文本到語音轉換。
  2. 少樣本TTS: 僅需1分鐘的訓練數據即可微調模型,提升聲音相似度和真實感。
  3. 跨語言支持: 支持與訓練數據集不同語言的推理,目前支持英語、日語和中文。
  4. WebUI工具: 集成工具包括聲音伴奏分離、自動訓練集分割、中文自動語音識別(ASR)和文本標注,協助初學者創建訓練數據集和GPT/SoVITS模型。

如果你是 Windows用戶(已在 win>=10上測試),可以直接通過預打包文件安裝。只需下載預打包文件,解壓後雙擊 go-webui.bat 即可啓動 GPT-SoVITS-WebUI。預訓練模型

GPT-SoVITS语音克隆AI,只需一分钟素材训练模型,效果堪比商用。一键安装,附Colab脚本 | TTS | RVC|GPT-SoVITS Colab

從 GPT-SoVITS Models 下載預訓練模型,並將它們放置在 GPT_SoVITS\pretrained_models 中。

對於中文自動語音識別(另外),從 Damo ASR Model, Damo VAD Model, 和 Damo Punc Model 下載模型,並將它們放置在 tools/damo_asr/models 中。

對於UVR5(人聲/伴奏分離和混響移除,另外),從 UVR5 Weights 下載模型,並將它們放置在 tools/uvr5/uvr5_weights 中。

數據集格式

文本到語音(TTS)注釋 .list 文件格式:

vocal_path|speaker_name|language|text

語言字典:

  • ‘zh’: Chinese
  • ‘ja’: Japanese
  • ‘en’: English

示例:

D:\GPT-SoVITS\xxx/xxx.wav|xxx|en|I like playing Genshin.

Categories: 文字轉語音, Audio, 軟件

AudioBox –

Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。 馬上體驗 – 多種聲效 – 創作故事

Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。

馬上體驗 – 多種聲效 – 創作故事

Categories: Audio, 線上服務

Page 11 of 12
1 … 9 10 11 12