LoopCoder:只多跑一輪,成效反而更好

LoopCoder-v2 研究 PLT 在測試階段的迴圈次數選擇,顯示兩輪往往比三輪以上更穩定。對寫程式、工具呼叫和代理式任務,這個項目提供了更實際的取捨參考。

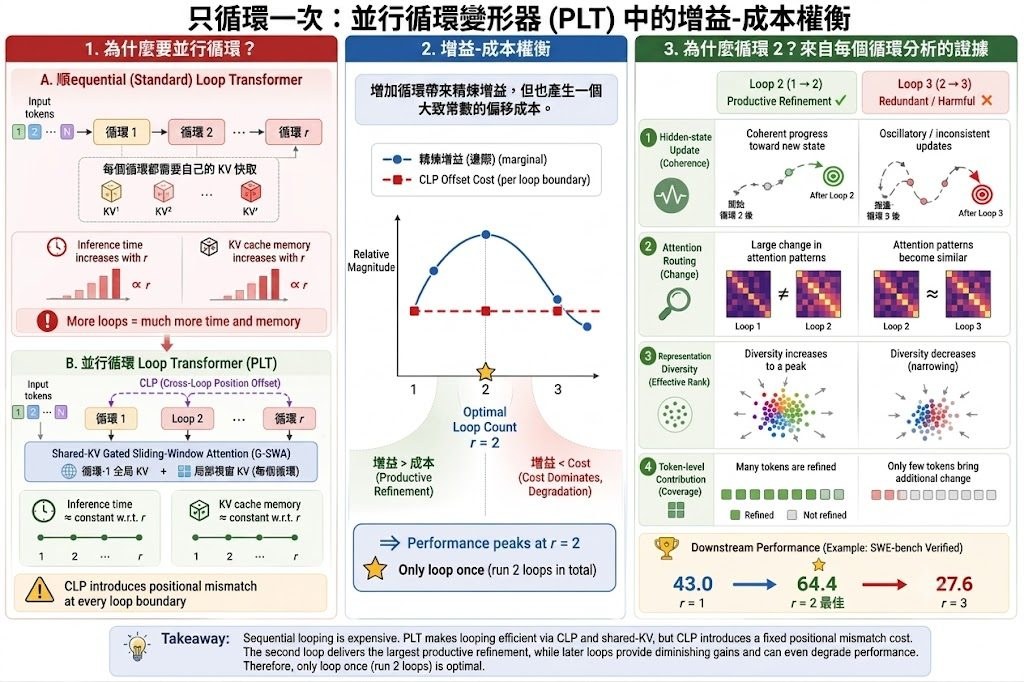
Only Loop Once: gain–cost trade-off in Parallel Loop Transformers

LoopCoder-v2 是一個基於 Parallel Loop Transformers(PLT)的程式碼模型系列,目標是解決「推理步數愈多,成本與表現未必同步上升」的問題。傳統 Looped Transformers 會透過重複共享區塊去增加 latent computation,但每多一輪都會拉高延遲和 KV-cache 記憶體;PLT 則用 Cross-Loop Position Offsets(CLP)和 Shared-KV Gated Sliding-Window Attention(G-SWA)把成本壓低,讓迴圈數變成可以調整的設計參數。

這個項目直接拆解「多跑幾輪到底值不值得」。作者用 gain–cost 角度分析 loop count:額外一輪可以帶來表示更新,但 CLP 也會引入位置不匹配的成本;兩邊一對比,就能解釋為何 LoopCoder-v2 在很多情況下是兩輪最好,而不是愈多愈好。這種分析方式比單看分數更有參考價值,因為它把效果升降和內部機制連在一起。

從結果看,LoopCoder-v2 的 7B 版本在多個程式相關測試都有明顯改善,尤其是 SWE-bench Verified 由 43.0 升到 64.4,Multi-SWE 由 14.0 升到 31.0,Terminal-Bench 亦有提升。相反,三輪或四輪時分數明顯回落,表示這個項目不是單純靠「加更多計算」換表現,而是存在一個較清晰的最佳點。作者亦用 hidden-state dynamics、attention evolution 和 output distribution shift 去佐證第二輪帶來主要增益,之後的輪次多數只會增加冗餘。

如果你想找的是可直接跑的模型,這個項目提供了 Hugging Face 上的 7B 權重,能透過 Transformers 載入後做文本生成或程式碼任務測試。適合關注 code generation、code reasoning、agentic software engineering、tool-use 的人,也適合想研究 test-time compute scaling、模型推理效率,或想比較 loop count 對表現影響的讀者。

  • 主要類型是模型研究項目,同時包含評測與推理分析
  • 核心結論是:兩輪通常是最佳平衡點,三輪以上可能反而拖低表現
  • CLP 令平行迴圈可行,G-SWA 則把 KV-cache 成本維持在近乎固定水平
  • 7B 版本在 SWE-bench Verified、Multi-SWE、Terminal-Bench、BFCL 等測試都有較完整結果
  • 適合用來分析程式碼模型、代理式任務,以及測試階段算力分配

GitHub: https://github.com/CSJianYang/LoopCoder

Paper: https://arxiv.org/pdf/2606.18023

Categories: 開源, Agentic, AI productions, RAG, 模型, 框架, 軟件, 工具, Python, 編程

[技術文章] KAIST 與 Qualcomm 重塑長影片 RAG 評測

這項研究先由 KAIST 與 Qualcomm AI Research 團隊提出新基準,再用新方法改善長影片 RAG 檢索。重點在於拆開評測檢索與生成,找出真正有效的證據片段。

Hero image preview

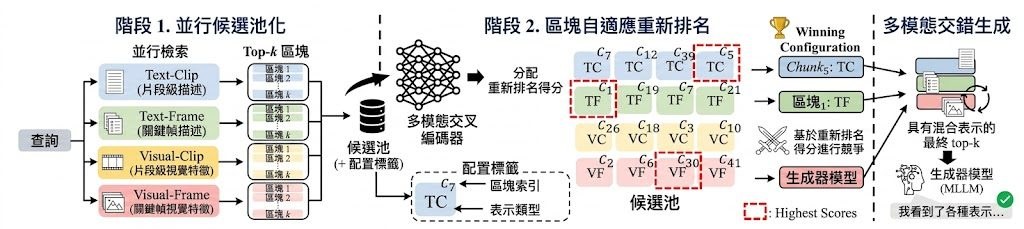
這項研究由 KAISTQualcomm AI Research、Qualcomm Korea 團隊合作提出,聚焦長時間第一身影片中的 Retrieval-augmented generation(RAG)。作者指出,現有 VideoRAG 常沿用「每條查詢只配一種 modality 與一種 temporal granularity」的固定範式,但長影片的證據片段差異很大,單一設定未必適合全部片段;加上不少既有 benchmark 的問題甚至不用看影片也能答中,令最終分數難以反映檢索是否真的做對。

因此,團隊提出 V-RAGBench,把資料整理成 ⟨query, evidence chunk, answer⟩ triplets,明確分開查詢、證據片段與答案。這種設計針對的是過去「只看最終回答正確率」的盲點,讓研究者可以更忠實地分開檢查 retrieval 與 generation,知道系統究竟是靠對的影片片段,還是靠語言偏見、常識或靜態線索作答。

方法上,作者再提出 CARVE。它不是替整條查詢預先選定一種設定,而是讓多個 retriever 以不同 modality 與 granularity 並行工作,再用 chunk-adaptive reranking 為每個 evidence chunk 挑出最合適的 winning configuration。之後,這些片段會連同各自勝出的設定一併送入 generator,形成 interleaved evidence,令檢索階段的片段級決策延續到生成階段。

對想使用這個項目的人來說,切入點很清楚:先用 V-RAGBench 測試自己的 VideoRAG 流程,分開看檢索與生成表現;若系統目前仍採用查詢級單一設定,可再比較 CARVE 這種片段級配置方式。這種思路較適合長影片問答、egocentric video 分析,以及需要從多模態證據中找出正確時間片段的 Agentic 系統。

  • V-RAGBench 以 evidence chunk 為核心,補足舊 benchmark 無法準確檢查檢索對錯的問題
  • CARVE 改為片段級選擇 configuration,不再假設一條查詢只需一套 modality/granularity
  • 作者指出 generator 最後接收的 chunks 會交錯來自多種 configuration,這是 query-level 方法做不到的
  • 論文稱 CARVE 勝過 8 個近期 VideoRAG baselines,顯示片段級決策在長影片檢索更有優勢

整體來看,這項工作不是單純再加一個 VideoRAG 方法,而是先批評舊有評測與建模範式,再用新 benchmark 和新 retrieval framing 一起修正問題。如果你關心的是長影片 RAG 到底應該取回什麼、以及取回後怎樣交給模型使用,這項研究提供了相當清晰的分析框架。

Paper: https://arxiv.org/pdf/2606.13141

Categories: Agentic, AI productions, RAG, 模型, 多模態模型, Video, 框架, 新聞, Dataset 數據集

PyRAG:多跳推理RAG值唔值得留意

PyRAG把RAG拆成可執行步驟,重點在多跳推理。適合重視答案來源的人。

Repository image for GasolSun36/PyRAG

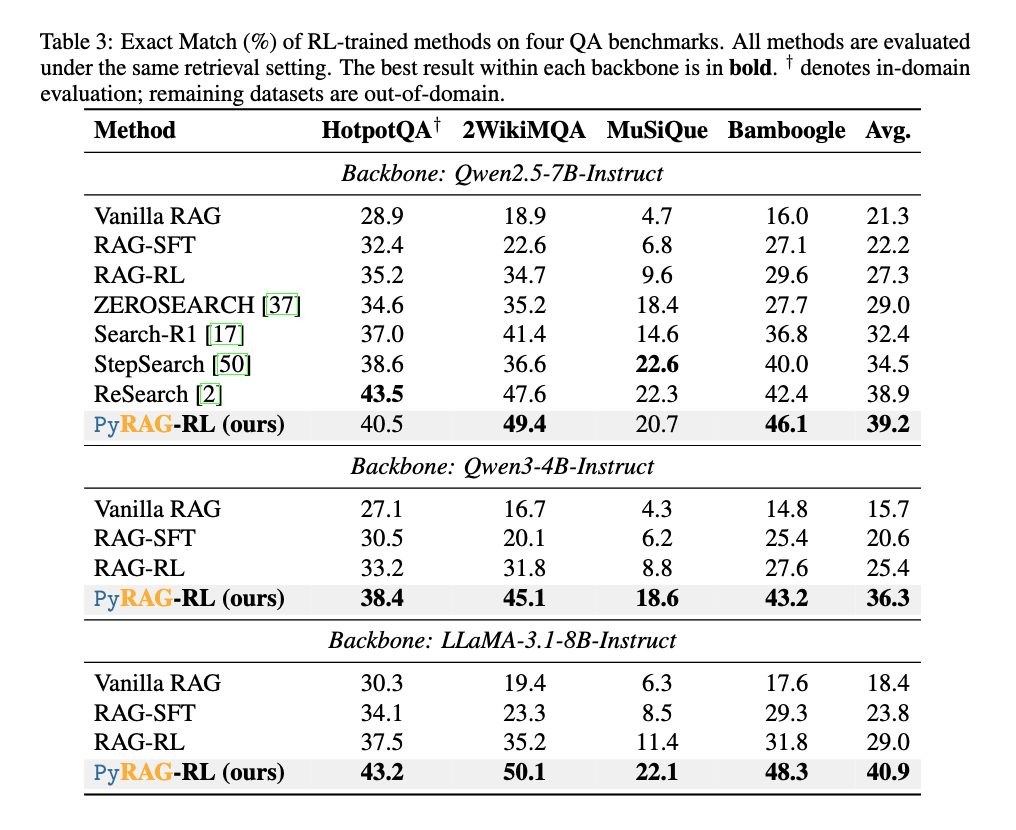
PyRAG看起來是一個以 Python 為主的 RAG 實驗專案,重點不是搜一次資料就作答,而是把檢索、推理、再檢索拆成可執行流程。對一般讀者來說,可把它理解成較重視「答案點樣得出來」的問答系統。

實際使用時,通常會先接入文件庫、知識庫或程式碼內容,再讓系統按問題逐步找線索,最後整理成答案。遇到要前後串連資訊的問題,例如先查概念、再補細節、最後整合結論,這類多跳流程會比普通 RAG 更合適。

  • 做什麼:把檢索增強生成變成多步查找與推理
  • 主要創新:中間步驟可追蹤,較易查證與除錯
  • 適合場景:複雜問答、研究助理、文件或程式碼知識庫
  • 相關模型:概念上可配合 GPT、Llama、Mistral 等生成模型,以及 BGE、E5 類嵌入模型;實際支援要看設定

我覺得它最吸引的地方,是不像一般聊天機械人那樣直接「估答案」,而是更像逐步查證。對想減少模型亂作、又要向同事交代答案來源的人,這方向特別有價值。

不過,從公開描述看,PyRAG較像研究型工具,實際兼容名單與部署成熟度仍要自行核對。若你只想快速搭一個簡單問答系統,傳統 RAG 可能更省事;若你重視可追溯性,它就值得留意。

網址: https://github.com/GasolSun36/PyRAG

Categories: 開源, 香港科技大學, RAG, 框架


檢索增強生成流程中融合 HyDE

在 RAG(檢索增強生成,Retrieval-Augmented Generation)流程中融合 HyDE 技術,特別是在社交群組 AI 助理的應用場景。影片詳細說明了 RAG 的基本原理、技術演進、現實挑戰,以及 HyDE 方法如何解決多輪群聊語意檢索問題、具體提升個人化推薦的效果。 這案例對 RAG 技術實戰落地非常有啟發,尤其在社群、記憶建構、個人化需求場景的處理方式。若你有自己的群聊 AI 專案,這種查詢增強流程、高維語意檢索建議、如何平衡效率與準確,是值得深入借鑑的。

I asked them to show me their RAG pipeline...

在 RAG(檢索增強生成,Retrieval-Augmented Generation)流程中融合 HyDE 技術,特別是在社交群組 AI 助理的應用場景。影片詳細說明了 RAG 的基本原理、技術演進、現實挑戰,以及 HyDE 方法如何解決多輪群聊語意檢索問題、具體提升個人化推薦的效果。

  • 語意密度失衡:單一查詢若囊括多個主題(如運動、用餐、過敏),其向量可能遠離相關用餐記錄,導致錯誤檢索。HyDE 協助切分查詢語意,生成能精準接近真正目標向量的候選,提升召回率。​
  • 模型選型與延遲:現成 embedding 模型雖然容易部署,但當候選文檔增加,模型必須在準確率、延遲、用戶體驗之間平衡(過多候選會加劇延遲及降低內容相關性)。​
  • Tone Matching:HyDE 生成的假想對話需盡量貼近用戶原始語境;目前主流 embedding 更偏向語意,語氣風格次要,但理想設計仍會嘗試符合真實對話氛圍。

這案例對 RAG 技術實戰落地非常有啟發,尤其在社群、記憶建構、個人化需求場景的處理方式。若你有自己的群聊 AI 專案,這種查詢增強流程、高維語意檢索建議、如何平衡效率與準確,是值得深入借鑑的。

Categories: RAG, 教學

ZARA 人類身體活動識別框架

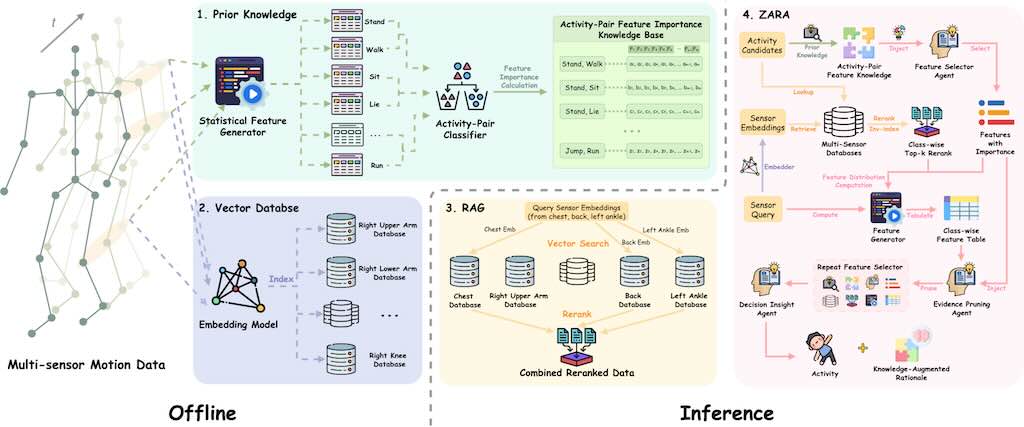
ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。 ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。

ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

Categories: 開源, RAG, 視覺模型, Medical醫學


從零寫AI RAG 個人知識庫

影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。 影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。

影片中,作者使用了 Google 的 embedding 模型和 ChromaDB 向量資料庫來實現這個架構。

  • RAG 架構簡介 解釋了 RAG 的基本原理,即將長文章拆分成小片段,對每個片段進行 embedding,然後儲存到向量資料庫中,並在使用者提問時找出最相關的片段發送給大型語言模型。
  • 文章分塊 示範如何將一篇關於「令狐沖轉生為史萊姆」的虛構文章進行分塊處理。他首先使用雙回車符作為切分依據,然後進一步優化,將以警號開頭的標題與後續的正文合併。
  • Embedding 與資料庫儲存 介紹如何使用 Google 的 embedding 模型對分塊後的文本進行 embedding,並將這些 embedding 及其原始文本儲存到 ChromaDB 向量資料庫中。作者特別提到 Google embedding 模型的「儲存」和「查詢」兩種模式。
  • 查詢功能 說明如何透過查詢 embedding 模型並從 ChromaDB 中檢索出與使用者問題最相關的文本片段。
  • 整合大型語言模型 最後,展示如何將查詢到的相關文本片段與使用者問題一起發送給大型語言模型(Gemini Flash 2.5),以生成更準確的回應。

影片強調動手實作的重要性,鼓勵觀眾親自寫一遍程式碼以加深理解。

从零写AI RAG 个人知识库
Categories: 開源, RAG, Embedding, Gemini, 教學

RAG 智能升級

影片介紹如何用 LangGraph、Agentic RAG、Nano-GraphRAG 和 Claude 3.7 Sonnet 製作一個具備推理能力的代理 Agent。作者透過展示了使用不同的工具,令 AI 模型能夠使用計算機、字典和搜尋引擎來增強 AI 模型的能力。

影片介紹如何用 LangGraph、Agentic RAG、Nano-GraphRAG 和 Claude 3.7 Sonnet 製作一個具備推理能力的代理 Agent。作者透過展示了使用不同的工具,令 AI 模型能夠使用計算機、字典和搜尋引擎來增強 AI 模型的能力。

RAG Intelligent Upgraded: Agentic RAR + Nano-GraphRAG + Claude 3.7 Sonnet (Oxford Univ)
Categories: 開源, RAG, LangGraph

Transformer Lab 桌面 LLM 工作台

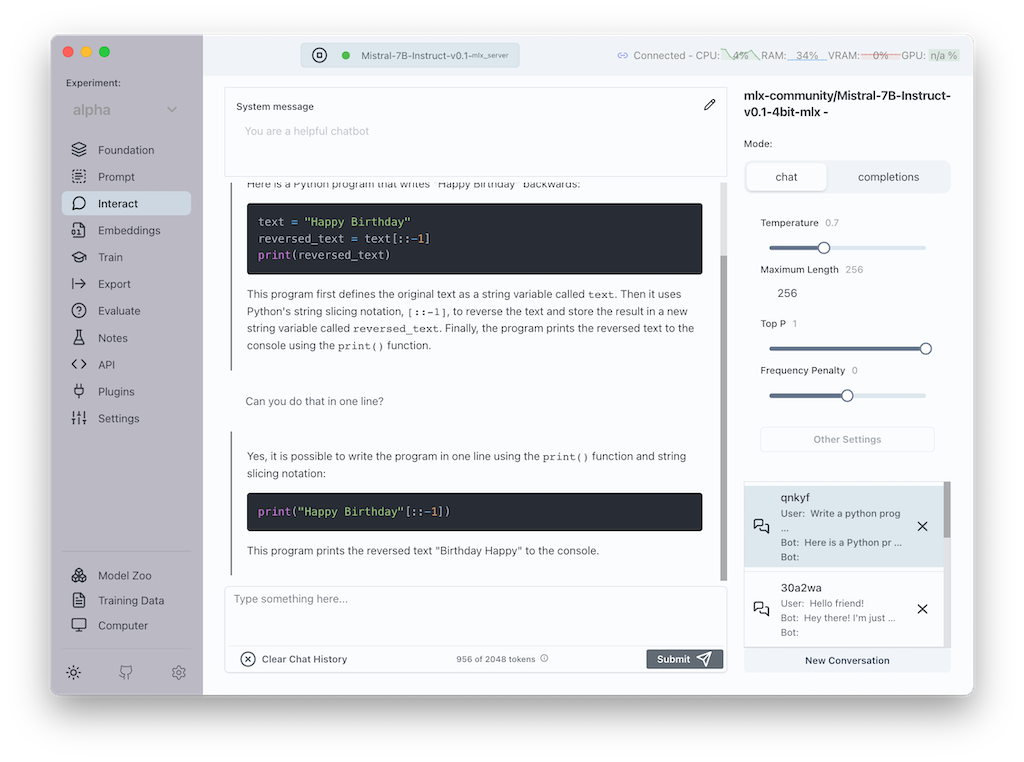
Transformer Lab 是個免費的開源 LLM 工作平台,方便進行微調、評估、匯出和測試,並支援唔同的推理引擎和平台。Transformer Lab 適用於擁有 GPU 或 TPU 的電腦,亦支援 MLX 的 M 系列的蘋果電腦。主要功能包括下載開源模型、智能聊天、計算嵌入、創建和下載訓練數據集、微調和訓練 LLM、以及使用 R A G 與文件互動。

Transformer Lab 是個免費的開源 LLM 工作平台,方便進行微調、評估、匯出和測試,並支援唔同的推理引擎和平台。Transformer Lab 適用於擁有 GPU 或 TPU 的電腦,亦支援 MLX 的 M 系列的蘋果電腦。主要功能包括下載開源模型、智能聊天、計算嵌入、創建和下載訓練數據集、微調和訓練 LLM、以及使用 R A G 與文件互動。

MAC ImageWIN Image

Categories: 開源, RAG, 軟件, 工具

Page 3 of 5
1 2 3 4 5