Spectral-Spatial-Interpretation(SSI ) 讓多光譜模型看清每個通道的作用

多光譜模型不只要知道哪個位置重要,還要分辨該位置由哪些通道推高或拉低分數。SSI 以 Shapley values 提供更細緻的解釋。

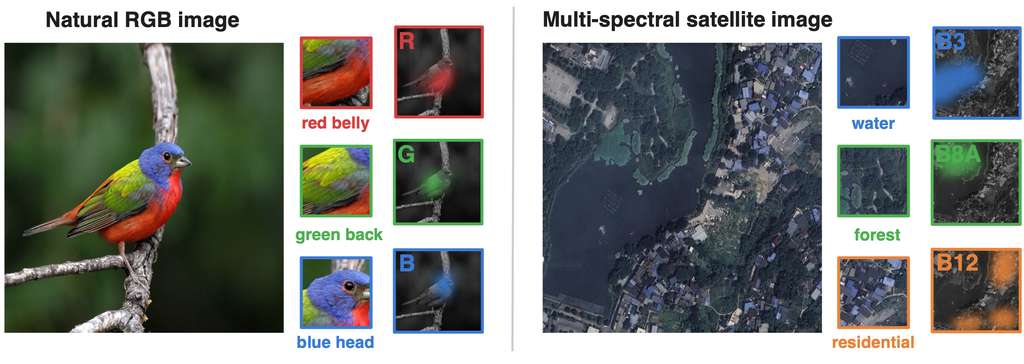
Figure 1: spatially varying channel relevance in RGB and multispectral images

面對多光譜影像,單一熱圖往往只說明哪裏重要,卻未能交代該位置的光譜通道如何影響結果。SSI(Spectral-Spatial Interpretation)屬於模型解釋工具,為每個空間 cell 和 channel 計算帶正負號的 attribution,拆解模型分數由哪個位置及哪個通道推動。

SSI 固定該 cell 以外的影像內容,只在 cell 內比較不同通道組合,再以 Shapley values 分配貢獻。所有通道貢獻會加總至該 cell 從遮罩狀態到原始狀態的分數變化,因此可分別彙整成 spatial map 或 spectral summary;正值代表推高分數,負值代表拉低分數。

項目提供獨立 NumPy 實作,支援 exact subset enumeration 和 sampled channel permutations,亦附有瀏覽器 Playground、Visual Atlas 及五分鐘互動教學。測試時可先用 Playground 觀察結果,再以 ssi.py 對自己的模型分數和遮罩 baseline 重現分析;通道數增加時,精確枚舉的成本亦會上升,抽樣排列是較可行的取捨。

與 Integrated Gradients (IG)、DeepSHAP、KernelSHAP 及 rank-1 RISE 比較,SSI 在三個資料集、兩種 masking baseline 下,三項指標的平均結果均居首;例如 mean-baseline HLS joint deletion 為 0.1545,KernelSHAP 為 0.2096。它較適合需要同時追蹤空間位置與光譜通道的遙感、農業或科學影像團隊,但要留意各 cell 的貢獻不一定能加總成整張影像相對 baseline 的總變化,因為 SSI 解釋的是條件式局部遊戲。

  • 同時回答「哪裏重要」與「哪個通道重要」
  • 保留正負貢獻,能分辨推高或壓低分數的因素
  • 支援精確計算及排列抽樣兩種方式
  • 可用 spatial map、spectral summary 和 deletion 指標檢查結果
  • 適合多光譜模型,但需留意計算成本及跨 cell 互動限制
項目主頁 · GitHub

Categories: 開源, 模型, Image, 影像處理, 教學, 工具

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

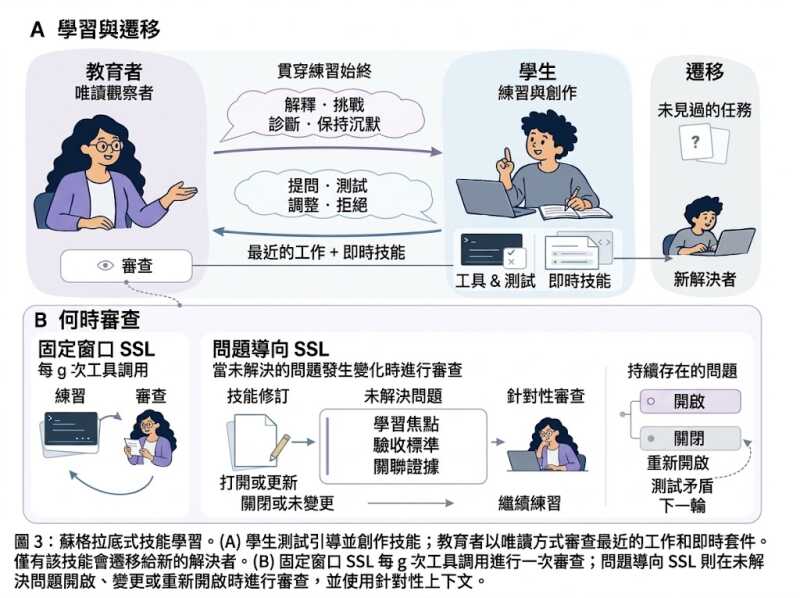
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

Google Classroom 用 Gemini 摘要學生如何使用 AI 筆記本

老師派出 AI 筆記本後,終於可以了解學生如何使用,而不只知道作業有沒有交。Gemini 會整理全班的參與情況、常見問題和個別對話紀錄。

Og image

學生完成 AI 筆記本作業後,老師可以透過 Gemini 生成的摘要,了解全班怎樣使用這個學習空間、哪些內容較易掌握,以及哪些地方仍有疑問。這項功能面向 Google Classroom 的教師主導式 Gemini Notebook,處理的是派出 AI 作業後難以掌握學生學習過程的問題。

摘要提供班級整體參與情況、學生對話中的常見主題,以及個別學生的聊天紀錄。老師可先用摘要掌握共同情況,再查看原始對話核對細節;學生亦會在筆記本內收到通知,知道對話內容會向老師開放。

學校管理員則可在 Admin console 設定 Gemini Notebook 的外部分享權限,包括 Trusted Domains。這適合跨校合作教學,但可分享範圍仍由學校管理員控制;來源沒有提供功能推出時間表或使用設定步驟。

  • Gemini 摘要班級使用情況與常見學習問題。
  • 老師可查閱個別學生的對話紀錄,核對摘要內容。
  • 學生會收到對話可供老師查看的通知。
  • 管理員可透過 Trusted Domains 控制跨校分享。

對需要檢視全班學習狀況、跟進個別疑問,或與其他學校協作的教師和管理員,這項更新可減少逐一翻查對話的需要。它提供的是使用情況整理與檢視工具,不能單憑摘要取代老師對學生理解程度的判斷。

項目主頁

Categories: Google, Gemini, 教學, 工具, 新聞

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

用 5 百萬次人類投票煉成的文生圖獎勵機制,公開給開源社群

Arena.ai 提出一套文生圖模型的後訓練方法,把人類偏好分數加上自動評分量尺,結果讓 FLUX.2-dev 與 Ideogram 4 同時衝上排行榜高位。你可以把它理解成幫文生圖模型「補課」的兩條評分線。

Og image

文生圖模型越來越強,但要靠後訓練再往上推,卻卡在同一個難題:到底要拿什麼訊號當作優化目標。Arena.ai 這項工作直接把答案拆成兩條互相補位的獎勵線,再把他們公開給社群參考。

第一條線來自 Text-to-Image Arena 上大約 500 萬組真實人類對決投票,用 Bradley–Terry 目標訓練出一個偏好獎勵模型,負責衡量視覺品質、構圖、美感這些廣義的好看與否。這個偏好模型在 MMRB2 基準上比其他獎勵模型表現更好,而且訓練資料越多,後訓練成果也越好。

第二條線則對應一個偏好資料看不到的問題:圖片可以極漂亮,卻把提示詞裡的物件寫漏、多塞東西,或者走偏要求的風格。Arena.ai 用視覺語言模型自動產生一組評分量尺,針對提示詞忠實度、相關約束、以及常見的獎勵漏洞行為打分,把這些規則式分數一起混入優化目標。

比起 Flow-GRPO 或 DiffusionNFT 這類只靠單一獎勵訊號的後訓練方法,這套組合給人的差別感在於:美感與合規不再互搶資源。經過他們的後訓練食譜,FLUX.2-dev 在 Arena 即時文生圖排行榜上多了 69 分,Ideogram 4 更拿到 1224 分,超越 2026 年 9 月 4 日之前所有公開上架的開源模型。

項目主頁 · Paper

Categories: 開源, 模型訓練, Image, txt2img, 提示詞, 教學, Dataset 數據集, 強化學習

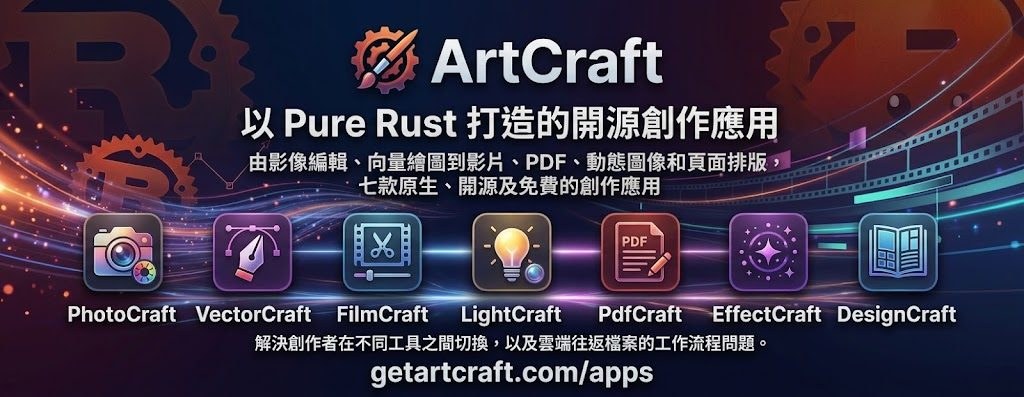
ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

SoL-Refiner 高解像度影片生成加速 27 倍

先完成低解像度草稿,再用一次去噪提升至高解像度,SoL-Refiner 大幅縮短影片生成時間。

Og image

高解像度影片生成往往受限於大量時空 tokens,SoL-Refiner 以影片精修模型處理這個瓶頸:先由不同基礎生成器製作較低解像度草稿,再用一次目標解像度去噪輸出最高 4K 影片,毋須進行多步精修。

NVIDIA Research 的訓練流程結合高解像度持續訓練、frame-based RL post-training,以及 one-step distribution-matching distillation,並支援 bidirectional 和 streaming inference。方案可接駁 MiniMax H3、SANA-Video、Cosmos-Nano 和 WAN 等不同生成器,令精修模組毋須綁定單一模型。

  • 一次高解像度去噪,減少第二階段採樣成本
  • 支援多個影片生成器,改善跨模型工作流程
  • 在 2K 保持具競爭力,4K 指標優於 LTX-2.3
  • WAN 和 Cosmos-Nano 測試中,平均質素亦有所提升

以五秒、1344×768、24 fps 影片測試,MiniMax H3 直接生成高解像度版本需 152.3 秒;低解像度生成加 SoL-Refiner 的兩階段流程只需 5.6354 秒,量得 27.03 倍牆鐘速度提升。測試使用 NVIDIA GB200,每個階段各佔用一張 GPU,實際速度仍會受硬件、基礎生成器和影片設定影響。

SoL-Refiner 適合需要大量高解像度影片、但又要控制推理延遲的內容製作流程。它以額外的低解像度生成階段換取更快的高解像度輸出,質素和速度之間的取捨仍取決於輸入草稿及所選生成器。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, 教學, Python, LTX, MiniMax

Page 2 of 21
1 2 3 4 … 21