AlayaVista:全景潛態驅動嘅可串流世界模型

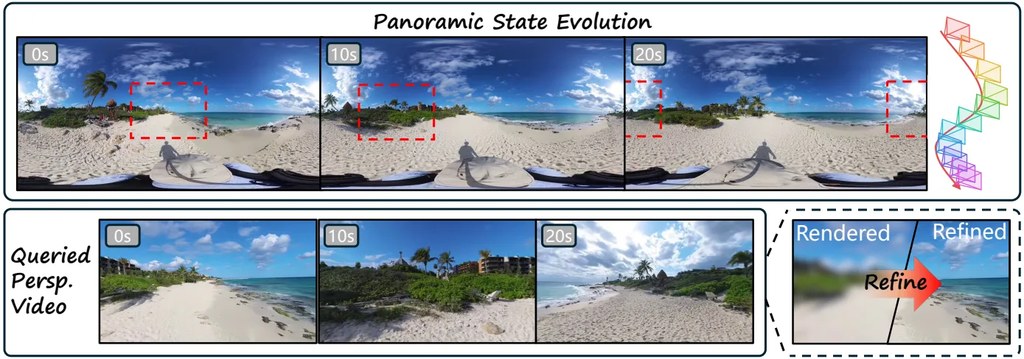
AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

ComfyUI-MiniMaxH3-TimelineDirector:一張圖跑出無斷點長影片

想在 ComfyUI 內一次過生成超過一分鐘的影片,又要角色口型與背景音樂全程對得齊?這套 MiniMax H3 Timeline Director 插件把分段、續接、漂移修正全部收埋喺一張圖。

Creator WeCom contact card

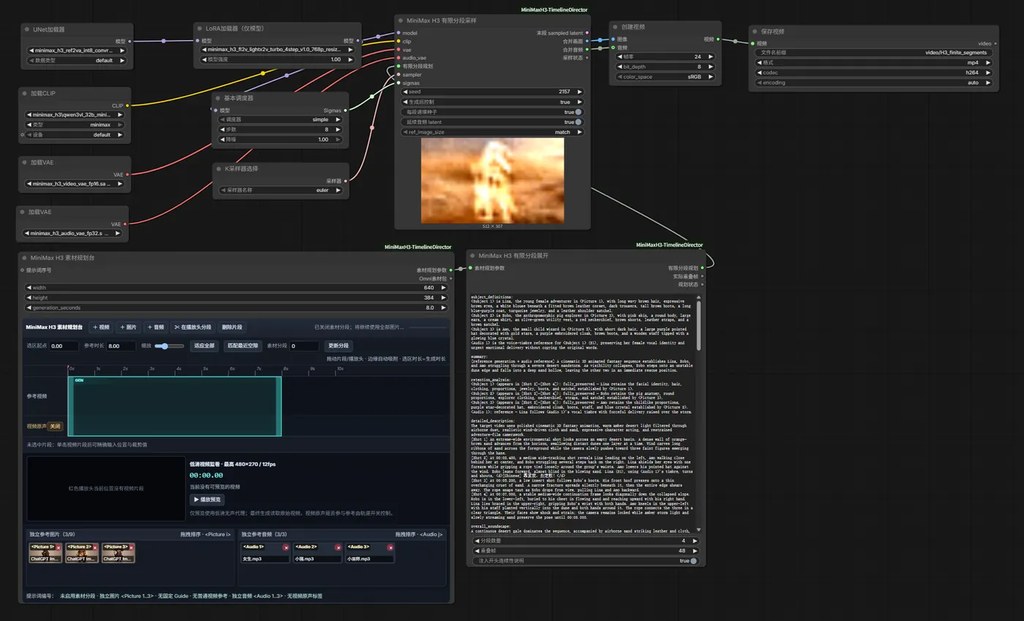
MiniMax H3 官方最令人卻步嘅限制之一,就係單次生成時長偏短,想做一段完整 Demo 或者長 Demo 都要靠 Loop 節點逐段駁,駁完口型同音軌成日走樣。ComfyUI-MiniMaxH3-TimelineDirector 嘅切入點正正喺呢個位:佢提供一個 Full Timeline Director 工作流,把 T2V、Image Reference、音訊驅動、角色替換、動作遷移、數字人同一條龍長片生成,全部塞入同一張 ComfyUI 圖。

插件會把目標時長拆成連續 GEN 窗口,並用同一個共享 seed 串接前一段嘅 AV-latent 尾部,配合 Drift-Control 影片遮罩同 Soft AV 音訊連續性處理,再做 overlap 移除並最終同步輸出成片。長度上限唔再由 Loop 節點或者重複 Sampler 鏈決定,而係睇本地 VRAM、RAM、磁碟空間同 ComfyUI 執行限制。

佢同一般「駁長片」做法最大嘅差異,係對齊音訊嘅方式。當你將一段長 MP3 標記為 Locked Original Audio,插件會將聲音按 sample 位置精確切片,注入每段 AV latent,並以零音訊降噪遮罩保留;Timeline 比音源短就截斷,比音源長就用靜音補尾,用戶唔使再人手對 MP3 metadata 或 codec priming delay。Long-form digital humans 同角色演唱場景亦靠同一條路徑處理:角色圖同長 soundtrack 鎖定後,手動 GEN 窗口即可逐段推出口型同步。

時間軸方面,每段 Clip 設有三種模式——Fixed Guide、Editable Reference、Boundary Only,支援 move、trim、split、delete、snap 同數值定位;只有同 cyan 生成範圍相交嘅媒體先會進入當前 Reference 或 Guide 計劃,避免雜訊干擾。

實際最易受惠嘅人,係要做完整 MV 級 Demo、產品概念片、教學影片、或者 AI 短劇分鏡嘅創作者同中小型團隊。官方已放出兩條約 52.6 秒 / 1263 幀嘅直接生成示範,包括純 latent 續接同 48 幀 Reference overlap 兩個 case,可直接喺 GitHub Release 拎 MP4 對照效果。

  • 類型:ComfyUI 插件 / 時間軸導演工具
  • 核心能力:一張圖內分段續接生成無斷點長影片,音訊 sample-sliced 注入 AV latent
  • 同類差異:唔靠通用 Loop 節點或重複 Sampler 鏈,直接由 AV-latent 尾部續接
  • 適用場景:長片數字人、角色演唱、概念片、教學影片等需要連貫長片嘅創作
  • 部署方式:經 ComfyUI Manager 或手動放入 custom_nodes 目錄後啟動 ComfyUI,載入 example_workflows 內嘅 All-in-One 工作流即可

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, Video, Image, Audio, 教學, 工具, Content Creator, 音樂, MiniMax

[教學影片] Seedance 2.5 逼近寫實 AI 影片生成

Seedance 2.5 走向超寫實 AI 影片生成,重點放在畫面真實感同創作效率。這類工具適合想快速做出貼近真人拍攝效果嘅內容製作者。

Og image

Seedance 2.5 透過影片生成能力,主打把 AI 片段做得更貼近真實拍攝感,適合內容創作者、短片製作同需要快速試片嘅工作流。片段描述雖然唔多,但方向好清楚:重點唔係花巧效果,而係提升畫面可信度同整體觀感。

對一般創作者嚟講,呢類模型最有用之處係可以縮短由構思到成片嘅時間,尤其係要做概念片、廣告草稿、社交平台短片,或者先行測試視覺風格嘅時候。它強調 ultra realistic,代表畫面一致性、材質細節同動態自然度會係主要賣點。

不過,原始資料只提到示範與推廣用途,未有交代訓練細節、評測指標、輸入限制或實際可否隨意下載使用,所以唔適合自行推斷佢嘅開放程度。現階段較合理嘅理解係:Seedance 2.5 係一個面向高寫實影片生成嘅模型/服務,重點在於實用視覺效果,而唔係提供完整技術規格。

  • 主打超寫實 AI 影片生成
  • 適合短片、概念片同視覺草稿
  • 核心價值係提升真實感同創作效率
  • 原始資料未交代下載、開放程度同技術細節
  • 內容明確偏向影片模型與線上服務場景

項目主頁

Categories: Video, 提示詞, 教學

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

OpenMAIC:把課堂內容變成多代理互動教學

把主題或文件直接轉成可互動課堂,連投影片、測驗和小組活動都一併生成。它更像一個面向教學流程的多代理 AI 平台。

OpenMAIC

OpenMAIC 是一個多代理 AI 教學平台,處理的是把零散素材快速整理成可教、可互動的課堂內容。使用者只要輸入主題,或者上傳文件、音訊、影片,再加上網頁搜尋素材,系統就會組織出投影片、測驗、互動模擬和專題式學習活動,並由 AI 老師和 AI 同學在課堂內即時互動。

它和一般內容生成工具的分別,在於不只產出講義,而是把整個教學流程串起來。OpenMAIC 內部採用 chat-first 的工作區,支援持久化 session,任務可以在伺服器重啟後繼續,亦可中途取消、回復和調整,較適合需要反覆修訂課程的教育團隊、培訓人員和內容製作人。

  • 可由文字主題或外部素材直接生成完整課堂
  • 支援投影片、測驗、互動模擬、PBL 和 .pptx 匯入
  • 接入 OpenClaw 後,可由 Feishu、Slack、Telegram 等訊息工具建立課堂
  • 可自行接入模型、媒體、搜尋供應商和儲存後端
  • 官方提供 Live Demo,亦可用 Vercel 一鍵部署
OpenMAIC GitHub Setup Guide: From Text Prompt to Local MP4 Classroom Export

OpenMAIC 以多代理協調做編排,並結合 LangGraph、Next.js、React 和 TypeScript。超過 20 項內建技能,定位不是單純聊天機械人,而是把教學內容生產、互動和發佈收束到同一條工作流。

GitHub

Categories: 開源, Agentic, 框架, 教學, LangGraph, OpenClaw

[影片教學] 利用開源探索 3D 世界

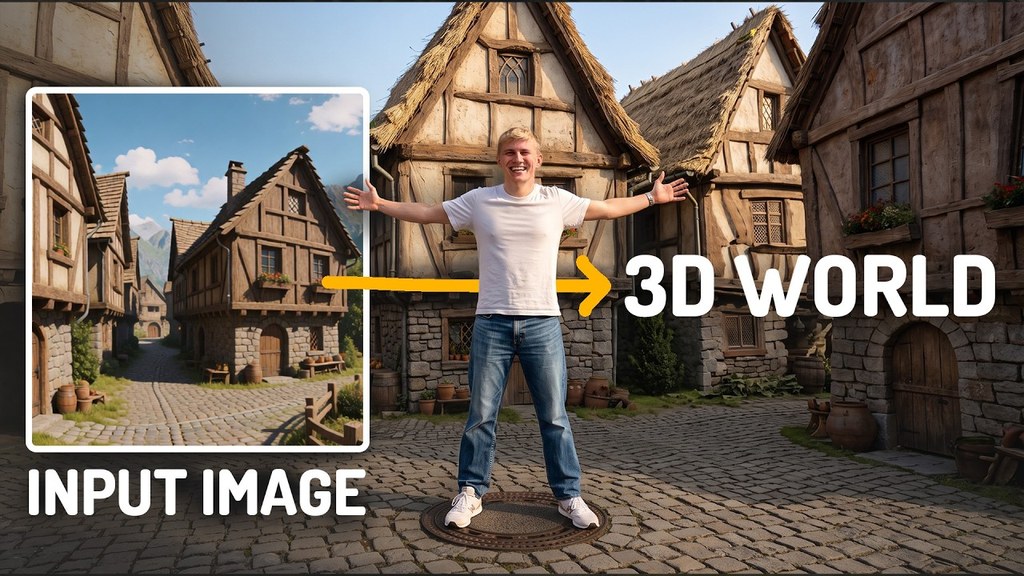
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: AI productions, 世界模型, Image, 影像處理, 教學, 3D

DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

MiniMax H3 在 ComfyUI 實現換臉換身工作流

MiniMax H3 配合 ComfyUI 自訂節點,示範如何建立換臉與換身流程,方便整理影像生成工作流。

Og image

由換臉延伸到換身,影片示範 MiniMax H3 在 ComfyUI 中處理人物影像替換的完整流程,重點放在如何把不同步驟串連起來,減少使用者自行摸索節點配置的時間。

流程以 ComfyUI 為操作環境,並配合 custom nodes 建立 Face Swap 和 Body Swap 工作流。對需要處理人物素材、測試影像生成效果,或想將換臉與換身加入現有影像項目的創作者,這類示範可作為起點。

影片涵蓋的內容包括:
– MiniMax H3 在 ComfyUI 中的工作流安排
– Face Swap 換臉流程
– Body Swap 換身流程
– custom nodes 的配合方式
– 從輸入素材到結果輸出的完整操作示範

使用者仍需按素材類型、節點版本及本地環境調整設定,並留意人物影像替換涉及的肖像權與授權問題。

項目主頁

Categories: 開源, ComfyUI, 教學, 安全, MiniMax, UI/UX

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cppOllamaLM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cppOllamaLM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: 模型, 教學, Mac, LLaMa, Ollama

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

Page 1 of 19
1 2 3 19