Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Agentic, 模型訓練, Qwen, API, LLaMa, Ollama, 編程, Dataset 數據集

MiniMax H3:全模態影音生成說明書

MiniMax H3 把文字、圖片、影片與聲音整合到同一套生成流程,並支援同步影音輸出。

Og image

MiniMax H3 面向需要由多種媒體素材生成影片的場景,輸入可包括文字、圖片、影片及聲音,輸出則涵蓋影片與同步音訊。它屬於通用 omni-modal generative system,並非只處理 text-to-video,亦標示支援 image-to-video、video-to-video、audio-to-audio-video 等流程。提供的內容未載明它基於哪個 base model,亦無法確認是否由其他模型 fine-tuned from。

這種統一處理方式適合將參考圖片、動態片段或聲音一併納入生成條件,減少工作流程需要分拆成多個模型的情況。metadata 指向 Diffusers,並列出 multimodal、synchronized-audio-video 及 reference-to-audio-video 等能力;不過目前資料未交代模型架構、參數規模、上下文長度、訓練方法或效能指標。

可留意的使用重點包括:
– 支援 text-to-video、image-to-video、image-text-to-video 及 video-to-video。
– 可處理文字、圖片、影片與音訊,並生成 audio-video 組合內容。
– 提供 Global 與中國地區的 Online API,以及 Hailuo AI 網頁和桌面 App。
– 標示使用 MiniMax H3 Community License Agreement,部署前應查閱 LICENSE。

項目主頁

Categories: 開源, 多模態模型, 視頻模型, Video, Image, Audio, 3D, Ollama, MiniMax

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cpp、Ollama 同 LM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cpp、Ollama、LM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: 模型, 教學, Mac, LLaMa, Ollama

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, Agentic, 模型, DeepSeek, LLaMa, Ollama

Ollama 3.25 把開源模型帶回你部機

想喺自己電腦跑開源大模型,又唔想先砌一大堆環境,Ollama 正正係針對呢個卡位。它將模型執行、管理同串接應用壓縮成一條較順手的路。

Repository image for ollama/ollama

想將開源模型放返本地處理,又要兼顧聊天、程式整合同 agent 工作流,Ollama 幾乎係目前最直接的一條路。它屬於模型執行與管理工具,核心作用係將本地大語言模型的下載、啟動、呼叫同整合收斂到同一套介面,令 Mac、Windows、Linux 甚至 Docker 部署都比較一致。

它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。

同類做法入面,Ollama 的取向好清楚:它唔著重花巧介面,而係先處理「點樣穩定喺本地把模型跑起來,再供其他程式使用」呢件事。背後支援 llama.cpp,意味住它承接咗本地推理生態的成熟基礎;代價亦存在,本地效能仍然受你部機的記憶體、GPU 與模型大小限制,追求大型模型或高併發時,就未必有雲端服務咁輕鬆。

  • 安裝路徑完整,覆蓋 macOS、Windows、Linux 同 Docker,理解上可以當成一個本地 AI 服務。
  • 既可直接 run 模型聊天,亦可透過 REST API、Python、JavaScript 接入現有項目。
  • 跟 Claude Code、OpenClaw、Codex、Copilot 等整合,適合做本地 agent 與開發工作流。
  • 配合 Open WebUI、LibreChat、Lobe Chat、NextChat 等,可快速補上可視化操作層。

較受惠的一群,會係想保留資料喺本地的開發者、需要快速測試開源模型的團隊,以及想把 AI 能力嵌入內部工具的人。就產品定位而言,Ollama 最有價值的地方,係將「本地跑模型」由零散步驟變成可重用的基礎設施。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Mac, Linux, Ollama, Python

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

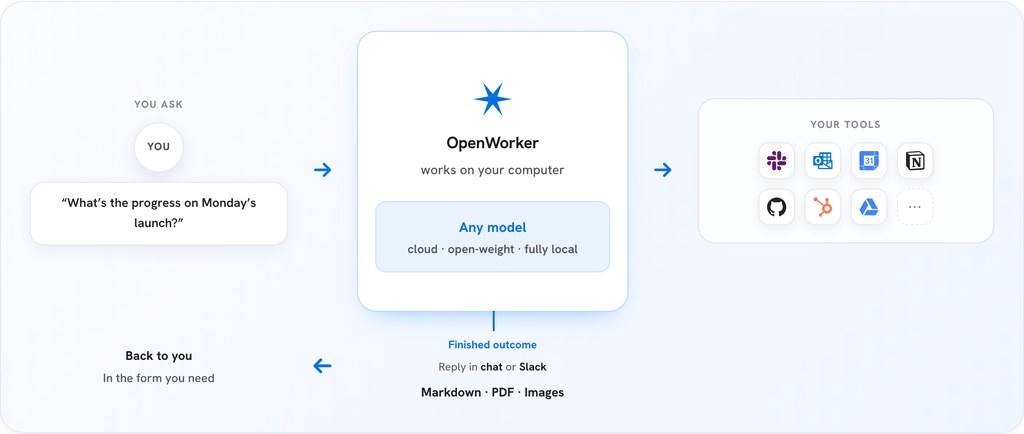
OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

Krea 2 Outpaint:外擴 LoRA 補畫面

想將圖片自然延伸到更大畫布,又唔想主體走位,呢個 Krea 2 Outpaint 就係針對呢個卡位而來。它唔只做補邊,重點係知道原圖應該擺喺新畫布邊個位置。

Og image

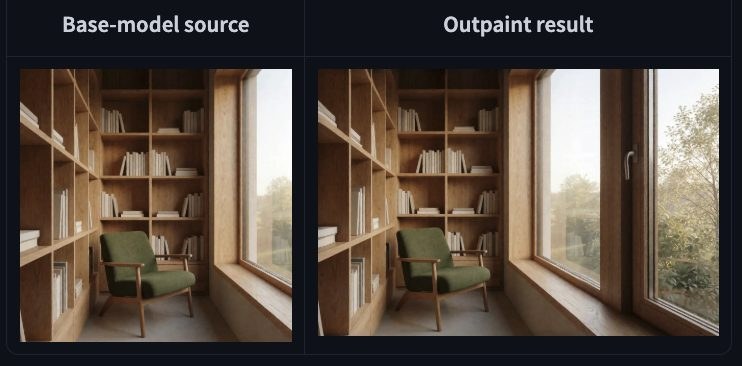
畫面外擴最怕兩件事:原圖內容被改壞,或者延伸後透視、光線同結構接唔上。呢個項目明確建立在 Krea/Krea-2-Turbo 之上,並以 Krea 2 Raw 作訓練目標,形式係一個 rank-32 的 LoRA,用嚟做 image-to-image outpainting,重點唔係單純參考原圖,而係連原圖要放喺新畫布邊個區域都一併編碼。

它的做法是把來源 latent tokens 加上來自目標 bounding box 的 rotary coordinates,令 denoiser 能理解「已知畫面屬於整張新圖的哪個位置」。所以它比一般 image-reference adapter 更適合做左貼右擴、上貼下擴,甚至置中後向兩邊延伸,對透視、光照、紋理連續性的控制更直接。

檔案資訊相當清楚,但重點不在量化版本。頁面列出 krea2_outpaint_rank32.safetensors、pipeline.py、outpaint.py、example.py,另有授權與雜湊檔;同時明確說明 Hugging Face 自動產生的 Diffusers snippet 及一般 LoRA importer 不相容,要用隨附腳本與自訂 pipeline。這代表它不是即插即用型 LoRA,而係帶有功能性介面的適配器。

  • 基礎模型已指明為 Krea/Krea-2-Turbo,並針對 distilled 8-step inference 設計。
  • 核心差異在 registered reference_placements,可指定原圖在目標畫布的位置。
  • 已測試寫實、水彩、stylized 3D 等場景,涵蓋橫向、縱向與置中延伸。
  • 頁面沒有提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio 或量化等資訊。

使用取向上,它更像為 Krea 2 編輯流程補上一個 UI 版的外擴能力,而唔係通用本地推理模型。由於依賴 diffusers 與自訂程式碼,適合已經在 Python 圖像流程中工作、需要穩定控制構圖位置的人。

項目主頁 · 模型

Categories: 開源, 視覺模型, Image, 影像模型, 影像處理, Ollama

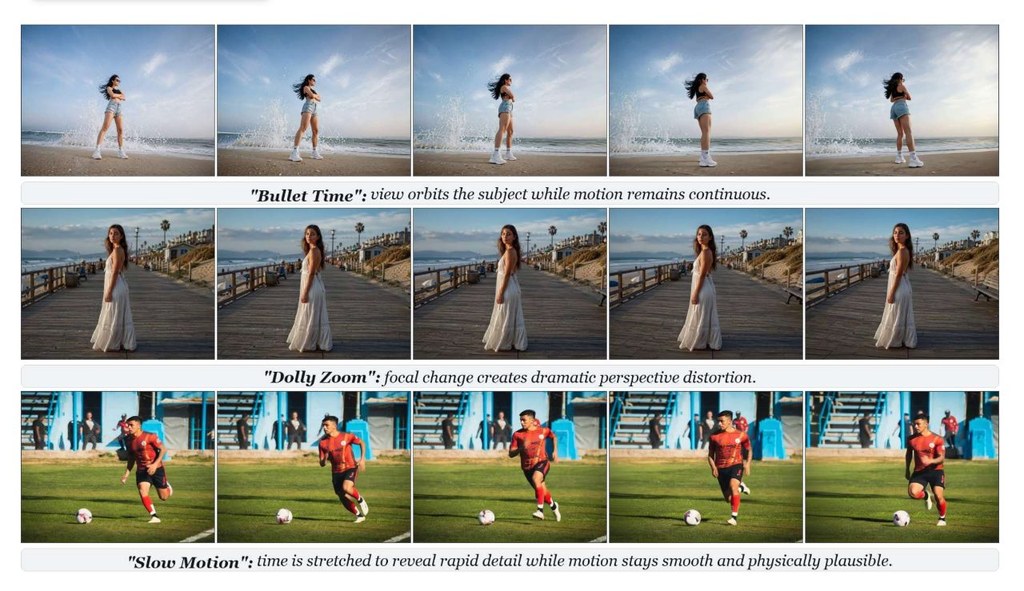
CineMobile 點樣把電影運鏡搬上手機

想用一張相做出 bullet time 或 dolly zoom,CineMobile 瞄準的正是手機端生成速度與畫質之間的拉扯。它把大型影片擴散模型壓縮到可落地的體積,同時盡量保住電影感運鏡。

Hugging Face

由 Wan 2.1 架構的 teacher model 壓縮而來,CineMobile 針對 image-to-video diffusion 而設,重點唔係追求最大全能,而係讓 bullet time、dolly zoom、slow motion 這類電影感鏡頭可以在手機晶片上跑得動。對一般使用者來說,最大差異是它把原本偏向雲端或高階 GPU 的生成流程,縮短到可在行動裝置完成的級別。

技術路線分三步走:先用 distillation-guided pruning 保留關鍵影片生成能力,再把壓縮後模型結合 diffusion distillation 與 reinforcement learning,進一步做成 4-step generator,最後再用 hybrid post-training quantization 把整體模型壓到 1 GB 以下。這組做法直接對準兩個瓶頸:DiTs 參數太大,以及多步去噪太慢。

頁面提供的數字相當具體。相比採用 Wan 2.1 architecture 的 teacher model,CineMobile 可帶來 40× 生成加速;生成 49-frame、480p 影片時,在 NVIDIA H200 GPU 的每步 denoising latency 為 0.6 秒,在 MediaTek Dimensity 8400 Ultimate 5G 平台約為 20 秒,峰值記憶體使用量為 1.8 GB。這代表它雖然仍有明顯等待時間,但已進入手機可接受的範圍。

  • 基礎來源可確認與 Wan 2.1 架構有關,但頁面未見完整 base model 款式或 checkpoint 名稱
  • 核心優化包括 pruning、distillation、reinforcement learning 與 post-training quantization
  • 目標輸出為 49-frame、480p 的 cinematic camera motion 影片
  • 重點能力在於連續運鏡,同時維持 subject identity 與 scene consistency

Hugging Face 暫未提供可直接下載量化檔的模型頁,未提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio、chat template 或 v2 檔名更新資訊,亦無法判斷是否支援 MTP draft speculation。

項目主頁 · Paper

Categories: AI productions, 視頻模型, 模型訓練, NVIDIA, Video, Image, LLaMa, Ollama

vLLM 新後端跑出原生級速度

同一份 transformers 模型實作,依家可以直接食到 vLLM 的高速推理。對部署大型語言模型的人而言,少咗移植工序,吞吐量亦未必輸原生實作。

Og image

卡位一直在於:想用 vLLM 的高吞吐推理能力,過去往往要為個別模型寫或等專用實作。呢篇內容講的是 Hugging Face 把 transformers 直接作為 vLLM 的 modeling backend,而且頁面沒有提供 base model 資訊,因為它不是單一模型頁,而是針對推理後端整合的技術更新。

重點價值很直接:模型作者只要已有 transformers 實作,就有機會不用再額外移植到 vLLM,也能拿到接近原生,甚至更快的推理表現。對 LLM 與 VLM 都有意義,因為 serving 設定基本不變,只是加入 --model-impl transformers 旗標。

文中展示了三組 Qwen3 測試:Qwen3-4B 單 GPU、Qwen3-32B 以 tensor parallelism 跑 2 GPU,以及 Qwen3-235B-A22B-FP8 Mixture-of-Experts 在同一個 8×H100 節點上以 data parallelism 加 expert parallelism 執行。結果指向同一件事:transformers backend 的 throughput 已經追平或超過 vLLM 手寫 native implementation。

  • transformers 已支援 450+ architectures,角色像參考級 modeling library
  • vLLM 繼續負責 continuous batching、custom attention kernels 等高效推理優化
  • 啟用方式很簡單:升級 vllm,並在 serve 時加入 --model-impl transformers
  • 可與 --tensor-parallel-size、--data-parallel-size、--enable-expert-parallel 一起使用

取捨亦要講清楚:頁面重點在 backend 整合與效能展示,不是 GGUF 發布頁,所以沒有提供 GGUF 格式、量化等級、mmproj、chat template、MTP draft speculation 或 LM Studio/Ollama/llama.cpp 檔案資訊。硬體需求方面,示例至少涵蓋單 GPU、2 GPU,同埋 8×H100 節點;不同模型是否都能複製同樣增益,仍要視架構與部署環境而定。

項目主頁 · GitHub

Categories: 開源, Qwen, 框架, Ollama, Python, 庫

DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。

項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

Page 2 of 4
1 2 3 4